设计模式——策略:有状态与无状态
策略模式把「用哪个算法」从调用点挪开,代价跟着一起挪,落在别的地方。
一份共享的无状态实例和直接调用测不出差别;每次新建带状态的策略,成本从调用换成分配;从表里取策略,成本落在查表之后那个无法内联的调用点上。
这篇在 JDK 21.0.8 和 JDK 25 上各跑 1 亿次调用,量四种形态的耗时和分配字节。
一、成本落在哪两个地方
一个策略调用点要回答两件事:这次执行的是谁(分派),它需要的状态从哪来(持有或分配)。
分派和分配的价格差了好几个量级。分派如果是单态的,JIT 能把接口调用消成一条直接调用,再和调用体一起内联进循环,循环随即被向量化,最后测出来是每调用 0.3 纳秒这个量级。分配只要是逃逸的,每次调用都要付出一个对象的内存,1 亿次就是 2.4 GB 的垃圾。
策略有状态还是无状态,决定成本落在分派还是分配上。
    graph TD
    CALL["调用点 p.apply(x)"] --> SEL{"p 从哪里来"}
    SEL -->|"static final,一份"| S1["共享实例:无状态"]
    SEL -->|"每次调用 new 或 lambda"| S2["新建实例:带捕获状态"]
    SEL -->|"Map 查表或分支"| S3["表里的若干实例"]
    S1 --> C1["单态调用点,可内联"]
    S2 --> C2["每次一个对象,调用体仍是同一段"]
    S3 --> C3["调用点看到多个实现"]
    C1 --> R1["成本接近 0"]
    C2 --> R2["成本是分配"]
    C3 --> R3["成本是查表加虚调用"]
与总纲那组实验的区别
系列总纲里已经测过一组对照:策略模式写成「接口 + 实现类」和写成 lambda,模板方法写成抽象类钩子和传函数,四种写法的每轮耗时落在 5.2 到 7.3 ns 一档。那组实验问的是写法贵不贵,每轮构造一次,然后在计时循环里反复调用。
本文不复测那组对照。这里固定「lambda 实现接口」这一种写法,只改状态放在哪里:一份共享实例、每次调用新建一份、从表里取一份。量耗时的同时量分配字节:有状态的账记在分配上,只看时间看不到。
二、实验设计
被测接口和四个实现:
1 | interface Policy { |
七个调用形态,每个测 1 亿次(第四节还会换键类型再测一遍):
| 形态 | 策略实例 | 每次调用的对象 |
|---|---|---|
direct |
无 | 无 |
shared |
一份 static final 实例 |
无 |
new-capture |
循环内 make((i & 7) + 1),立即调用 |
一个捕获 lambda |
new-capture-escape |
同上,但先存进 static Policy[] HOLDER 再调用 |
一个捕获 lambda |
table-string |
Map<String,Policy>,键在 4 个名字间轮转 |
无 |
lookup-only |
只查表,不调用 | 无 |
poly-call |
数组下标选策略,不查表 | 无 |
测量口径:
- 机器 Apple M1 Pro,Darwin 25.6.0,JDK 21.0.8+12-LTS-250 与 JDK 25+37-LTS-3491
- 每个 case 起一个独立 JVM,先跑 3 轮 2000 万次预热,再跑 5 轮 1 亿次计时,取 5 轮中位数
- 分配字节用
com.sun.management.ThreadMXBean.getCurrentThreadAllocatedBytes(),在计时轮之外单独跑一轮 1 亿次计数 - 计时循环在全局文件锁内串行执行(同一时刻还有 21 篇同系列文章在写,编译和画图不占锁)
- 本机没有 JMH。这是单线程微基准,只用来判断量级,不能当成硬件上限
怎么复现
每个 case 的循环体是一个独立方法,参数只有循环上限:
1 | case "table-string": { |
acc 最后打印出来,避免整个循环被当成没有副作用的死代码删掉。键按 i & 3 在四个名字间轮转,是为了让调用点看到四种实现;如果只用一个键,类型剖面会退化回单态,这一行的成本就测不出来了。
分配字节的读法:
1 | ThreadMXBean bean = (ThreadMXBean) ManagementFactory.getThreadMXBean(); |
这是当前线程的累计分配字节数,包含 TLAB 里已经用掉的部分,比采样 GC 日志精确。
分辨力
同一个 case 的 5 轮之间,中位数与最小值相差在 1% 以内(JDK 21 上:查表 5.02 / 4.98,共享实例 0.36 / 0.35)。本文当作结论的差都远大于这个范围:String 与枚举差 0.6 ns,占 12% 到 14%;查表与共享实例差 4.6 ns,是 13 倍。
分配字节在多次运行之间不变(两套 JDK、三种 GC 配置下都是 24.00),耗时在分配密集的 case 上会随 GC 时机浮动几成。关于分配,结论可以直接用字节数说;关于耗时,只取量级和方向。
三、实测一:四种形态
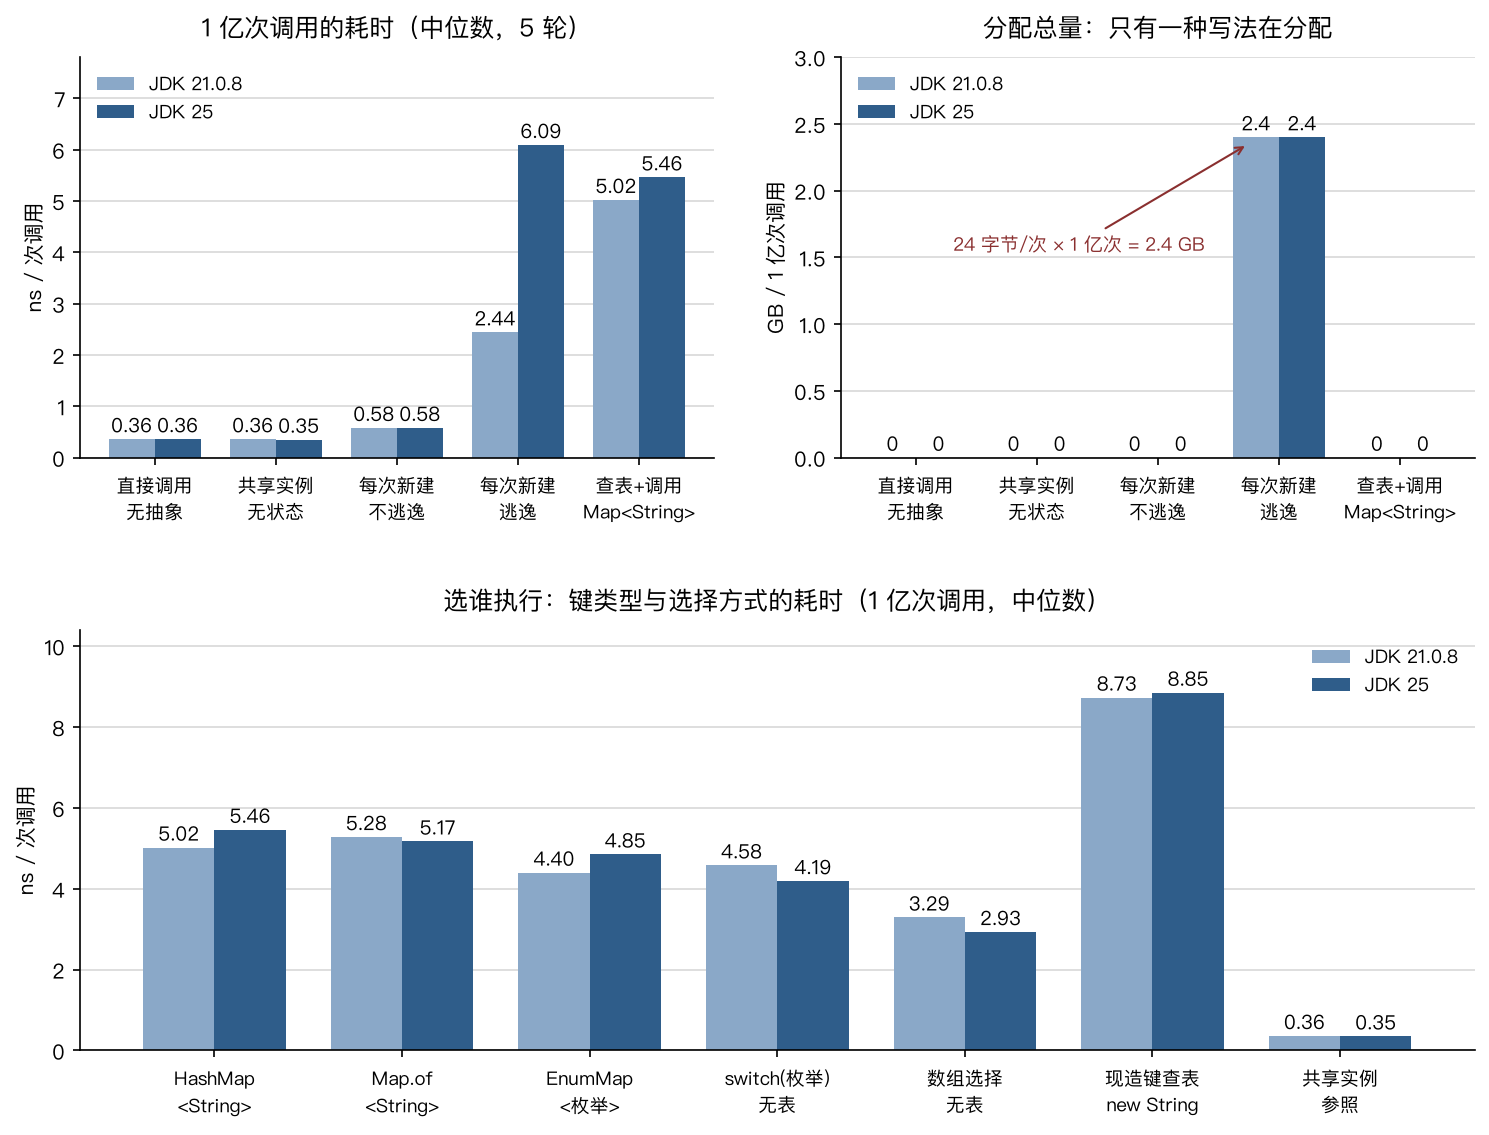
| 形态 | JDK 21.0.8 | JDK 25 | 分配/次 | 1 亿次分配总量 |
|---|---|---|---|---|
direct 直接调用 |
0.36 ns | 0.36 ns | 0 | 0 |
shared 共享无状态实例 |
0.36 ns | 0.35 ns | 0 | 0 |
new-capture 每次新建,不逃逸 |
0.58 ns | 0.58 ns | 0 | 0 |
new-capture-escape 每次新建,逃逸 |
2.44 ns | 6.09 ns | 24 字节 | 2.4 GB |
table-string 查表 + 调用 |
5.02 ns | 5.46 ns | 0 | 0 |
lookup-only 只查表 |
1.98 ns | 2.98 ns | 0 | 0 |
poly-call 数组选择 + 调用 |
3.29 ns | 2.93 ns | 0 | 0 |
共享实例与直接调用测不出差别
0.36 对 0.36 ns,两个 JDK 都一样。每次调用低于 1 纳秒,循环已经被向量化,测到的是乘法和加法的吞吐,分派的开销不在里面。
-XX:+UnlockDiagnosticVMOptions -XX:+PrintInlining 的输出给了原因。JIT 对那个循环做最终编译时,Policy::apply 的调用点只有一种接收者:
1 | @ 430 StrategyBench$$Lambda/0x0000007c010418a0::apply (5 bytes) inline (hot) |
类型剖面 1257524 次全部命中同一个类,接口调用被去虚化后内联,方法体再被内联。抽象层在编译结果里消失,剩下的和 direct 那组一样。
共享一份实例让调用点保持单态,省内存只是附带。无状态 lambda 天生只有一份实例,javac 为无捕获 lambda 生成的 invokedynamic 在链接期就把单例缓存好:
java.base/java/lang/invoke/InnerClassLambdaMetafactory.java:213-222,buildCallSite()在factoryType.parameterCount() == 0时返回new ConstantCallSite(caller.findStaticGetter(innerClass, LAMBDA_INSTANCE_FIELD, factoryType.returnType()))- 同文件
:365-369,generateClassInitializer()生成那个静态字段:注释写着Generate the static final field that holds the lambda singleton
用 JDK 25 实跑一次:同一个无捕获 lambda 表达式求值两次得到同一实例,同一个捕获 lambda 表达式求值两次得到两个不同实例(equals 也为 false,lambda 不覆写 equals)。
1 | 无捕获 lambda,两次调用同一处表达式,同一实例: true |
SHARED 那一行的 0.35 ns 来自这个机制:实例在类初始化时创建一次,此后每次调用拿到同一个对象。
每次新建:不逃逸时一个字节都测不到
new-capture 每次迭代都调用 make((i & 7) + 1),捕获值在 1 到 8 之间变化,因此不可能复用实例。它的耗时是 0.58 ns,比共享实例高 0.22 ns,分配字节是 0。
编译图里有这次分配,PrintInlining 输出这一串:
1 | @ 742 StrategyBench::make (7 bytes) inline (hot) |
Unsafe::allocateInstance 是内建函数,说明对象被分配了出来,但调用结束后没有任何地方引用它:apply 被内联成读一个字段,对象随即成为死代码。加 -XX:-EliminateAllocations 关掉标量替换再跑一遍,结果不变:0.84 ns 每次调用,0 字节。
写这段代码的人只会看到自己每次都 new 了一个策略,JIT 把这些分配删掉了。
逃逸之后,账单立刻出现
new-capture-escape 和上一组的差别只有一行:把新建的策略先写进 static Policy[] HOLDER,再从这个数组读回来调用。对象活过了当前这次调用,编译器只能把它分配出来。
- 分配:24.00 字节/次,两个 JDK 都是这个数,1 亿次就是 2.4 GB
- 耗时:JDK 21.0.8 是 2.44 ns,JDK 25 是 6.09 ns
- 一轮 1 亿次里,G1 各触发了 6 次和 10 次年轻代回收
这 2.5 倍的差没有继续归因,但可以排除「分配变贵了」:换用 -XX:+UseSerialGC,同样 1 亿次分配,两个 JDK 都是 1.7 到 1.8 ns 每次调用(各 34 次年轻代回收)。
| 逃逸新建的配置 | JDK 21.0.8 | JDK 25 | 年轻代回收次数 |
|---|---|---|---|
| G1(默认) | 2.44 ns | 6.09 ns | 6 / 10 |
-XX:+UseSerialGC |
1.73 ns | 1.80 ns | 34 / 34 |
G1,-Xmx8g |
2.63 ns | 5.91 ns | 5 / 6 |
24 字节这个数字与 GC 配置无关,两套 JDK、三种配置下都是 24.00。换算成时间才依赖 GC。要判断一段代码有没有这个问题,看分配字节,别看耗时。
24 字节是怎么来的
把几种对象单独量一遍,每次 100 万次分配取平均:
| 分配什么东西 | JDK 21.0.8 | JDK 25 |
|---|---|---|
| 无捕获 lambda,存入数组 | 0 字节 | 0 字节 |
捕获 1 个 long 的 lambda |
24 字节 | 24 字节 |
捕获 2 个 long 的 lambda |
32 字节 | 32 字节 |
自定义类,1 个 long 字段 |
24 字节 | 24 字节 |
new Object() |
16 字节 | 16 字节 |
new long[0] |
16 字节 | 16 字节 |
布局对得上:压缩指针下的对象头是 12 字节,加一个 long 字段 8 字节是 20,对齐到 8 的倍数得 24;两个 long 是 28,对齐得 32;空对象 12 字节对齐得 16。两种 JDK 的数字一致。
第一行的 0 有原因:无捕获 lambda 存进数组之后也没有分配,那个实例在链接期就建好了,数组里存的只是它的引用。捕获 lambda 才是每次一个对象。
同一个 k 值新建出来的 lambda 也不相等(前面测过 equals 为 false),所以缓存策略实例这件事不能靠「值相同就复用」实现,得自己建索引。
查表:代价在查完之后
lookup-only 只做 HASH_STRING.get(SKEYS[(int) (i & 3)]) 并把结果判空,不调用,1.98 ns(JDK 21)和 2.98 ns(JDK 25)。加上调用变成 5.02 和 5.46。两段成本大致加得回来:JDK 21 上 1.98 加 3.29 等于 5.27,实测 5.02;JDK 25 上 2.98 加 2.93 等于 5.91,实测 5.46。查表和虚调用大致是相加关系。
poly-call 换掉了表:ARR[(int) (i & 3)].apply(i),一次数组索引加同一次调用,3.29 和 2.93 ns。表不是大头,贵的是调用点:同一个循环里 Policy::apply 现在有四个接收者类:
1 | @ 576 java.util.HashMap::get (19 bytes) inline (hot) |
查表整条链都内联了,包括 String::hashCode。只有最后那一次接口调用停在 failed to inline: virtual call 上。poly-call 的输出同样如此(@ 473 StrategyBench$Policy::apply (0 bytes) failed to inline: virtual call)。
表让「选谁」变便宜,代价是「调用谁」定格成虚调用。四个实现是同一个接口的不同类,接收者类超过内联阈值之后,JIT 就停在这一步,代价与表的大小无关,与实现个数有关。
在生产里怎么看到同一件事
不需要单机基准也能定位分配。JFR 的 jdk.ObjectAllocationSample、-Xlog:gc 里的分配速率、async-profiler 的 alloc 模式都能按类统计。要找的形态是:某个策略类的分配次数和热路径调用次数同阶。
按本文量到的 24 字节/次算:一台每秒 5 万次调用的服务,一天 43 亿次调用,这个写法一天产生 104 GB 的垃圾。这个数换算自实测字节数,服务的调用量换成你自己的。比开销更麻烦的是这些对象持有每次调用才确定的状态:一旦有人把它们存起来,行为就不再等价。
四、实测二:键类型与选择方式
同一个循环,换键类型和选择方式,各 1 亿次:
| 选择方式 | JDK 21.0.8 | JDK 25 | 分配/次 |
|---|---|---|---|
HashMap<String> |
5.02 ns | 5.46 ns | 0 |
Map.of(String) |
5.28 ns | 5.17 ns | 0 |
HashMap<枚举> |
4.44 ns | 5.07 ns | 0 |
EnumMap<枚举> |
4.40 ns | 4.85 ns | 0 |
switch(枚举),无表 |
4.58 ns | 4.19 ns | 0 |
现造字符串键 + HashMap |
8.73 ns | 8.85 ns | 24 字节 |
| 共享实例,参照 | 0.36 ns | 0.35 ns | 0 |
三个观察:
String 和枚举的差在半个纳秒上下。 5.02 对 4.40(JDK 21)、5.46 对 4.85(JDK 25),都在 15% 以内,不构成量级差。枚举省下的那点来自 Object.hashCode():枚举的 hashCode 是 identity hash,算出一次就随对象头带下来,不需要读字段、不需要遍历字符。
EnumMap 与 HashMap<枚举> 也测不出差别(4.40 对 4.44,4.85 对 5.07)。EnumMap 用序号直接索引数组,HashMap 要走一次扰动和探测。四个键、无冲突的场景里,这点差别落在噪声内。选 EnumMap 的理由是迭代顺序和内存布局,与这几个纳秒无关。
Map.of 和 HashMap 同样测不出来(5.28 对 5.02,5.17 对 5.46,符号在两个 JDK 之间翻转)。4 个键的 Map.of 内部是线性探测的小表,与 HashMap 的一次探测成本相当。
switch(枚举) 没有表,却和查表一个档次(4.58、4.19)。选择方式换掉,那个有四种可能接收者的调用点还留在原地。
唯一产生量级差的是最后一行。键如果每次都要现造(new String(SKEYS[(int) (i & 3)]),模拟从配置、HTTP 参数、日志里拿到的策略名),成本跳到 8.73 和 8.85 ns,并且多出 24 字节的分配:一个新 String 对象,它的 hash 字段还是空的,hashCode() 得从头算。1 亿次调用就是 2.4 GB 的临时字符串。
三件事按影响排序:键类型最小,「键要不要现造」次之,「查完之后那个调用点还能不能内联」最大。
键应该在哪一步归一化
策略名从配置文件、HTTP 参数、数据库字段里读出来时,它在内存里是一个刚构造的 String,hash 字段还是空的,第一次查表要现场算一遍哈希,而且这个对象自身也算一次分配。把名字在初始化阶段映射成枚举,热路径里的成本就从 8.73 ns、24 字节降到 4.40 ns、0 字节(JDK 21 的数;JDK 25 上是 8.85 对 4.85)。这一步不动业务语义,只改键在什么时候被解析。
键是连续整数(渠道号、状态码)时,用数组下标代替表更快:poly-call 那行 3.29 ns 就是这种写法的实测值,比 HashMap 便宜一档,代价是键空间必须留给编译器看得见的数组边界。
这两条都属于「把选择成本移出热路径」,与换哪张表无关。
五、策略、状态、命令的边界
这三个模式都长成「一个接口,多个实现,调用点拿一个实现来用」,差别在状态和调用时机上。
本文测的策略实例不会自己变。make(k) 收到什么 k 就一直是那个 k,下一次用哪个算法由调用者决定。这份状态是只读的,所以它既能共享(无状态时)也能每次新建。
状态模式的实例自己会变。它把「下一步做什么」写在内部,由事件驱动迁移到另一个状态,调用方只负责递事件。这样的对象天生不可共享,一个连接的有状态协议解析器不能被两个连接用。
命令模式把一次调用本身变成对象,为了排队、重试、撤销、审计。命令必须携带执行所需的全部输入,所以每个命令都是一次分配,成本直接落在本文的 new-capture-escape 那一行:24 字节起步。区别在于命令的对象通常活得比调用长,会进队列;本文那 24 字节是一次即弃的。
判断状态从哪来就够了:
| 状态的来源 | 它是什么 | 本文对应的成本 |
|---|---|---|
| 调用者每次给的输入 | 参数,写进方法签名 | 0,与直接调用同档 |
| 构造时确定、之后不再变 | 无状态策略的一部分 | 建实例那次分配,之后 0 |
| 随环境自己迁移 | 状态模式 | 每个状态对象一份 |
| 一次调用的完整输入,以后才执行 | 命令 | 每次调用一个对象,且留到执行完 |
六、JDK 源码里的三种做法
Comparator:共享单例与捕获各占一半
Comparator.naturalOrder() 返回一份共享单例:
- JDK 25
java.base/java/util/Comparator.java:360-361,return (Comparator<T>) Comparators.NaturalOrderComparator.INSTANCE; java.base/java/util/Comparators.java:47-48,这个类本身是一个枚举:enum NaturalOrderComparator implements Comparator<Comparable<Object>> { INSTANCE; }
反转则分两种情况。Comparator.reversed() 是默认方法,每次都建新对象:
Comparator.java:188-189,default Comparator<T> reversed() { return Collections.reverseOrder(this); }Collections.java:5727,return new ReverseComparator2<>(cmp);,捕获被包装的那个比较器,字段在:5750的构造器里赋值
无状态的那份单例连反转都不用新建,Comparators.NaturalOrderComparator 覆写了自己的 reversed():
Comparators.java:55-58,public Comparator<Comparable<Object>> reversed() { return Comparator.reverseOrder(); }
反转一个无状态比较器得到的还是无状态比较器,所以 JDK 直接返回另一个共享单例。Collections.reverseOrder() 也是一个单例(Collections.java:5661-5663 返回 ReverseComparator.REVERSE_ORDER,字段定义在 :5675)。
Collections.reverseOrder(cmp) 的四个分支把这件事写得更直白:
1 | public static <T> Comparator<T> reverseOrder(Comparator<T> cmp) { |
(Collections.java:5718-5730)前三个分支返回现成实例,第四个把已经反转过一次的包装器拆开,把原对象还给你,避免套两层。只有最后一种情况才分配。
这套写法可以照搬到业务代码里:策略没有状态时,让它成为一份单例;reversed() 这类「再包一层」的操作只要结果是同一个无状态形态,就返回另一个单例。
Function:默认方法每次返回新函数
java.util.function 里的组合方法全部是每调用一次分配一个对象:
java.base/java/util/function/Function.java:86-89,default <V> Function<T, V> andThen(Function<? super R, ? extends V> after) { Objects.requireNonNull(after); return (T t) -> after.apply(apply(t)); }- 同文件
:66-69,compose同样是return (V v) -> apply(before.apply(v));
组合出来的函数捕获了它的组成部分,所以每次调用 andThen 都要新建。把它写在请求处理路径上就是每请求一次分配;写在初始化里则只分配一次。
Function.identity()(同文件 :97-99,return t -> t;)没有捕获,返回的是那个在链接期就建好的单例。
ThreadPoolExecutor:状态放在参数里
RejectedExecutionHandler 是策略接口(java.base/java/util/concurrent/RejectedExecutionHandler.java:44,void rejectedExecution(Runnable r, ThreadPoolExecutor executor); 在 :61),四个预置实现都是无状态类,没有一个实例字段:
- JDK 25
java.base/java/util/concurrent/ThreadPoolExecutor.java:2016-2034,AbortPolicy只有一个空构造器和一句throw new RejectedExecutionException(...) :1989-2007,CallerRunsPolicy的判断是if (!e.isShutdown()) { r.run(); },读的是参数e,不是自己的字段:2040-2054(DiscardPolicy)与:2074-2095(DiscardOldestPolicy)同理
所以一份实例能同时服务多个线程池。线程池把 handler 存在一个 volatile 字段里,这个实例活到被替换或者池子被回收:
:523,private volatile RejectedExecutionHandler handler;:561-562,默认实现是private static final RejectedExecutionHandler defaultHandler = new AbortPolicy();:1475-1478,setRejectedExecutionHandler只做非空检查再赋值
如果策略带状态,这套共享就不成立。一个计数的 handler(比如记录被拒绝任务的次数)必须每个池一份实例,并且自己处理可见性,因为 rejectedExecution 会在线程池的工作线程和提交线程里被调用。
把状态从对象挪到参数
这段 JDK 代码可以原样搬到业务上。同一个定价策略,两种写法:
1 | // 版本一:每单新建一个带状态的策略 |
版本二的 OrderPricer 没有字段,level 和 coupon 从方法签名走。对应本文的表:版本一是 new-capture-escape 的 2.44 / 6.09 ns 加 24 字节,版本二是 shared 的 0.36 / 0.35 ns 加 0 字节。差别在状态是存在对象里还是从参数过一遍,与用不用对象无关。
判断标准是状态和谁的生命周期一致。定价规则每次调用都不同,它就是参数;汇率表一天变一次,它是构造参数,那份策略可以共享一整天。
    graph LR
    subgraph JDK["JDK 里的策略"]
        direction TB
        C1["Comparator.naturalOrder()<br/>枚举单例,共享"]
        C2["Comparator.reversed()<br/>新建 ReverseComparator2"]
        F1["Function.identity()<br/>无捕获,链接期单例"]
        F2["Function.andThen()<br/>每次新建,捕获两个函数"]
        T1["AbortPolicy / CallerRunsPolicy<br/>无字段,状态在参数里"]
    end
    C1 --> S["无状态:一份实例,可被任意多个使用者共享"]
    F1 --> S
    T1 --> S
    C2 --> A["有状态:捕获状态,随生命周期分配"]
    F2 --> A
七、结论
什么时候共享一份实例
策略没有实例字段时,共享。省一次分配只是小头,final 字段加单一实现让调用点保持单态,接口调用被内联,后面的方法体一起进来,实测 0.35 ns 上下,与直接调用无从区分。
共享的前提是这份实例无状态。JDK 的 CallerRunsPolicy 选择把状态放在参数里,字段留空,这才让它能同时服务多个线程池。要给策略加计数器、缓存、上次结果这类字段,共享就不成立了,见系列里的不可变与防御性拷贝。
共享还要求线程安全。字段全是 final 且指向不可变对象的实例可以直接共享,ReverseComparator2 持有的 cmp 就是 final 字段(Collections.java:5750 的构造器里赋值)。要共享一个带可变状态的策略,同步、volatile、ThreadLocal 得自己选一个,这份成本取决于争用强度,不在本文测量的口径里。
什么时候每次新建
策略的状态和这次调用同生共死时,每次新建是正确的做法,而且通常免费。前提是它不逃逸:一份在调用点内部创建、用完即弃的策略,哪怕捕获了变量,实测也是 0.58 ns 和 0 字节,编译器把它连同分配一起消化掉了。
会打破这个前提的写法:
- 存进字段、数组、集合,或者传给一个不内联的方法
- 在 lambda 里引用
this以外还会被别处改动的对象,导致它不能被消除 - 交给线程、异步任务、
CompletableFuture,跨出当前栈帧
缓存策略实例是另一个常见陷阱:为了「避免每次新建」而把带状态的策略塞进 Map 缓存起来,结果是所有调用者共享同一份状态。这正是享元要解决的问题,需要状态被设计成不可变或者按范围划分。
什么时候查表
只有在策略的种类和生命周期超出编译期可知的范围时才需要表。查表的直接代价是 2 到 3 ns,间接代价是调用点失去单态性,两者加起来 5 ns 上下,比共享实例贵一个量级。
如果种类是固定的少数几种,switch 和表一样贵(实测 4.58 和 4.19),成本在分派上,与用哪种选择方式无关。要提速就得让每个分支的调用点各自单态,例如在 switch 的每个分支里直接写出算式,而不是取出一个 Policy 再调用。
键类型和表实现的选择排在最后。HashMap<String>、Map.of、HashMap<枚举>、EnumMap 之间的差都在半个纳秒以内。键需要每次现造时才会出现量级差(8.73 ns 和 24 字节)。策略名从配置或请求参数里来的时候,把它在进入热路径之前解析成枚举,这一步比换表实现有用得多。
什么时候不用策略
direct 那一行是 0.36 ns,和共享实例没有差别。两个方向:
抽象层的代价可以忽略,「为了性能不用策略」站不住脚。该放弃策略的场景是另一种:只有一个实现,没有第二个。这时候接口、工厂、注册表都是纯开销,因为没有任何东西需要被选择。系列里的被语言吃掉的那些模式记的就是这类判断。
判断顺序:
    graph TD
    S["准备引入一个策略"] --> Q1{"它有实例状态吗"}
    Q1 -->|"没有"| A1["一份 static final 实例<br/>调用点保持单态"]
    Q1 -->|"有"| Q2{"状态活多久"}
    Q2 -->|"和调用一样短"| A2["每次新建,别让它逃逸<br/>不逃逸就没有分配"]
    Q2 -->|"比调用长"| Q3{"状态可变吗"}
    Q3 -->|"不可变"| A3["建一份,安全共享"]
    Q3 -->|"可变"| A4["每个持有者一份<br/>并处理可见性"]
    A1 --> Q4{"种类是编译期固定的吗"}
    A2 --> Q4
    A3 --> Q4
    A4 --> Q4
    Q4 -->|"是,且只有一种"| A5["删掉抽象,直接调用"]
    Q4 -->|"是,少数几种"| A6["分支里直接写算式<br/>或每种一份单例"]
    Q4 -->|"不是"| A7["用表,键先归一化<br/>再考虑表实现"]
总结
- 共享的无状态策略实例与直接调用测不出差别:JDK 21.0.8 上两者都是 0.36 ns,JDK 25 上是 0.35 对 0.36。PrintInlining 显示调用点类型剖面 1257524 次全命中同一个类,接口调用被去虚化并内联。
- 无捕获 lambda 在链接期就是单例(
InnerClassLambdaMetafactory.java:213-222),捕获 lambda 每次求值都是新对象。实跑验证:前者同一实例,后者不同实例。 - 每次新建捕获 lambda、不逃逸:0.58 ns、0 字节,加
-XX:-EliminateAllocations也是 0 字节(0.84 ns)。分配在编译图里存在,调用之后的死代码消除把它删掉了。 - 同样的代码让策略逃逸到数组里:24.00 字节/次、1 亿次 2.4 GB,耗时 JDK 21 是 2.44 ns、JDK 25 是 6.09 ns。改用 SerialGC 后两个 JDK 都是 1.7 到 1.8 ns,这 2.5 倍差随 GC 配置消失,分配字节数不变。
- 只做查表 1.98 / 2.98 ns,查表加调用 5.02 / 5.46 ns;数组选择加调用 3.29 / 2.93 ns。查表链全部内联,卡住的是
Policy::apply的failed to inline: virtual call。 - 键类型:
HashMap<String>5.02 / 5.46,EnumMap<枚举>4.40 / 4.85,差在 15% 以内。HashMap<枚举>与EnumMap同档,Map.of与HashMap同档。 - 键每次现造(
new String):8.73 / 8.85 ns,多 24 字节/次。这是本组实验里唯一的量级差。 - JDK 自己的策略写法:
naturalOrder()返回枚举单例,reversed()每次分配ReverseComparator2(Collections.java:5727),NaturalOrderComparator.reversed()返回另一个单例(Comparators.java:55-58);RejectedExecutionHandler的四个预置实现都没有实例字段,状态来自参数e。
参考资料
- Comparator (Java SE 25)
- Comparators (JDK 25 源码)
- Collections (Java SE 25)
- Function (Java SE 25)
- RejectedExecutionHandler (Java SE 25)
- ThreadPoolExecutor (Java SE 25)
- ThreadMXBean.getCurrentThreadAllocatedBytes
- Java HotSpot VM 性能增强:逃逸分析
- Java Microbenchmark Harness
系列索引:设计模式系列