设计模式——享元:共享不可变状态
Integer.valueOf(500)每次调用返回一个新对象,Integer.valueOf(5)每次返回同一个。两者的方法体一样,差别在IntegerCache的区间上,而这个区间由启动参数决定。
享元模式做的就这一件事:把不变的部分抽出来放进池子共享,把每次都不同的部分当参数传进去。Integer的值是内在状态,调用方要哪个数是外在状态。
1 亿次调用、一组 JVM 参数和两个 JDK 量出这条分界线的两个后果:分配字节从每次 16 变成 0,耗时只差 1.5 倍左右。差额的去处在 TLAB 和 GC 里。
一、享元拆开了什么
享元把对象的字段拆成两半。实例之间重复的那部分字段,JDK 里的说法是内在状态,抽出来放进池子,每个值只留一个实例。随调用变化的那部分叫外在状态,留在对象外面,每次调用时当参数传进来。
    classDiagram
    direction LR
    class FlyweightFactory {
        -Map pool
        +get(Key) Flyweight
    }
    class Flyweight {
        <<immutable>>
        -int 内在状态
        +operate(外在状态)
    }
    class Client {
        +调用(外在状态)
    }
    FlyweightFactory --> Flyweight : 同一个 Key 永远返回同一个实例
    Client --> FlyweightFactory : 问池子要
    Client --> Flyweight : 把外在状态当参数传进去
    note for Flyweight "字段只有内在状态,构造之后不改,所以可以共享"
    note for FlyweightFactory "池子里的对象活到进程结束,不会有人回收"
Integer 的缓存是这个结构最干净的实例。内在状态是那个 int 值,池子是一层 static final Integer[],外在状态是调用方想装箱的那个数。装箱这一步里,「装的是 5 还是 500」属于外在状态,「5 这个值长什么样」属于内在状态。
FlyweightFactory.get(Key) 的返回类型有两个约定:同一个 Key 永远返回同一个实例;返回的对象不可变。第二条是第一条的前提。池子里的对象如果可变,共享它就等于共享了修改。
为什么 JDK 必须做这件事
装箱的身份语义写在语言规范里:-128 到 127 之间的 int 字面量装箱之后必须 intern,同一个值两次装箱的结果必须 ==。JDK 源码里对应的断言是 assert IntegerCache.high >= 127;。
规范只要求到这 128 个值。JDK 把上界做成了可配置的,于是这条界线变成三个可观察的层次:规范要求的最小集、JDK 默认给的 -128..127、以及启动参数能推到的地方。
缓存和对象池不是一回事
两者的区别在于池子里装什么。享元的池子装不可变对象:取出来直接用,不用还,多个调用方同时持有同一个实例也不担心。对象池(数据库连接池、ThreadLocal 里的缓冲区都算)装可变对象,借用和归还是协议的一部分,少还一次就漏,多还一次就乱。共享连接池是对象池,共享 Integer 是享元。
二、实验设计
要量的是同一个方法调用的两种情况:值落在缓存区间内,值落在区间外。再加第三种:把区间扩到能盖住那个值,用启动参数,不碰代码。
三个模式共用同一个循环方法,base 由调用方传进来:
1 | static Object keep; // 静态字段,阻止 JIT 把装箱对象标量替换掉 |
base = -128:值落在-128..127,默认缓存命中base = 500:值落在500..755,默认缓存未命中base = 500加上-XX:AutoBoxCacheMax=1000:同一段字节码,值全部落进扩展后的缓存
三个模式编译出同一份字节码,JIT 看到的逐字节相同,只有运行时传进来的 base 不同。写法差异就此排除,「命中与否」只剩一个来源:运行时传进来的 base。
另外跑一个不装箱的对照 plain(n),循环形状一样,只是 int 不进池子,量的是循环本身的地板价。
测量口径:
- 1 亿次调用,先跑 1000 万次预热,再测 3 轮,取中位数
- 分配字节用
com.sun.management.ThreadMXBean.getThreadAllocatedBytes(threadId),这是线程级的 TLAB 分配计数,精确到字节,Runtime.freeMemory那种前后差值量不到这个精度 - GC 次数在每轮前后各取一次
- JDK:
21.0.8+12-LTS-250与25+37-LTS-3491,都是 arm64,Apple M1 Pro - 计时循环持全局锁跑,同一时刻只有这一个测量在用 CPU
局限:这不是 JMH,没有 fork 隔离,耗时里包含 GC 暂停。分配字节是精确计数,耗时只用来判断量级。
三、实测
命中与未命中
| 模式 | JDK | 耗时中位数 | ns / 次调用 | 分配字节 / 1 亿次 | B / 次 | GC 次数(3 轮区间) |
|---|---|---|---|---|---|---|
命中 -128..127 |
21 | 125.2 ms | 1.25 | 0 | 0 | 0 |
命中 -128..127 |
25 | 137.6 ms | 1.38 | 0 | 0 | 0 |
未命中 500..755 |
21 | 219.6 ms | 2.20 | 1,600,000,000 | 16 | 6 到 8 |
未命中 500..755 |
25 | 204.6 ms | 2.05 | 1,600,000,000 | 16 | 6 到 10 |
未命中 + AutoBoxCacheMax=1000 |
21 | 114.5 ms | 1.15 | 0 | 0 | 0 |
未命中 + AutoBoxCacheMax=1000 |
25 | 113.6 ms | 1.14 | 0 | 0 | 0 |
不装箱对照 plain |
21 | 66.8 ms | 0.67 | 0 | 0 | 0 |
不装箱对照 plain |
25 | 66.2 ms | 0.66 | 0 | 0 | 0 |
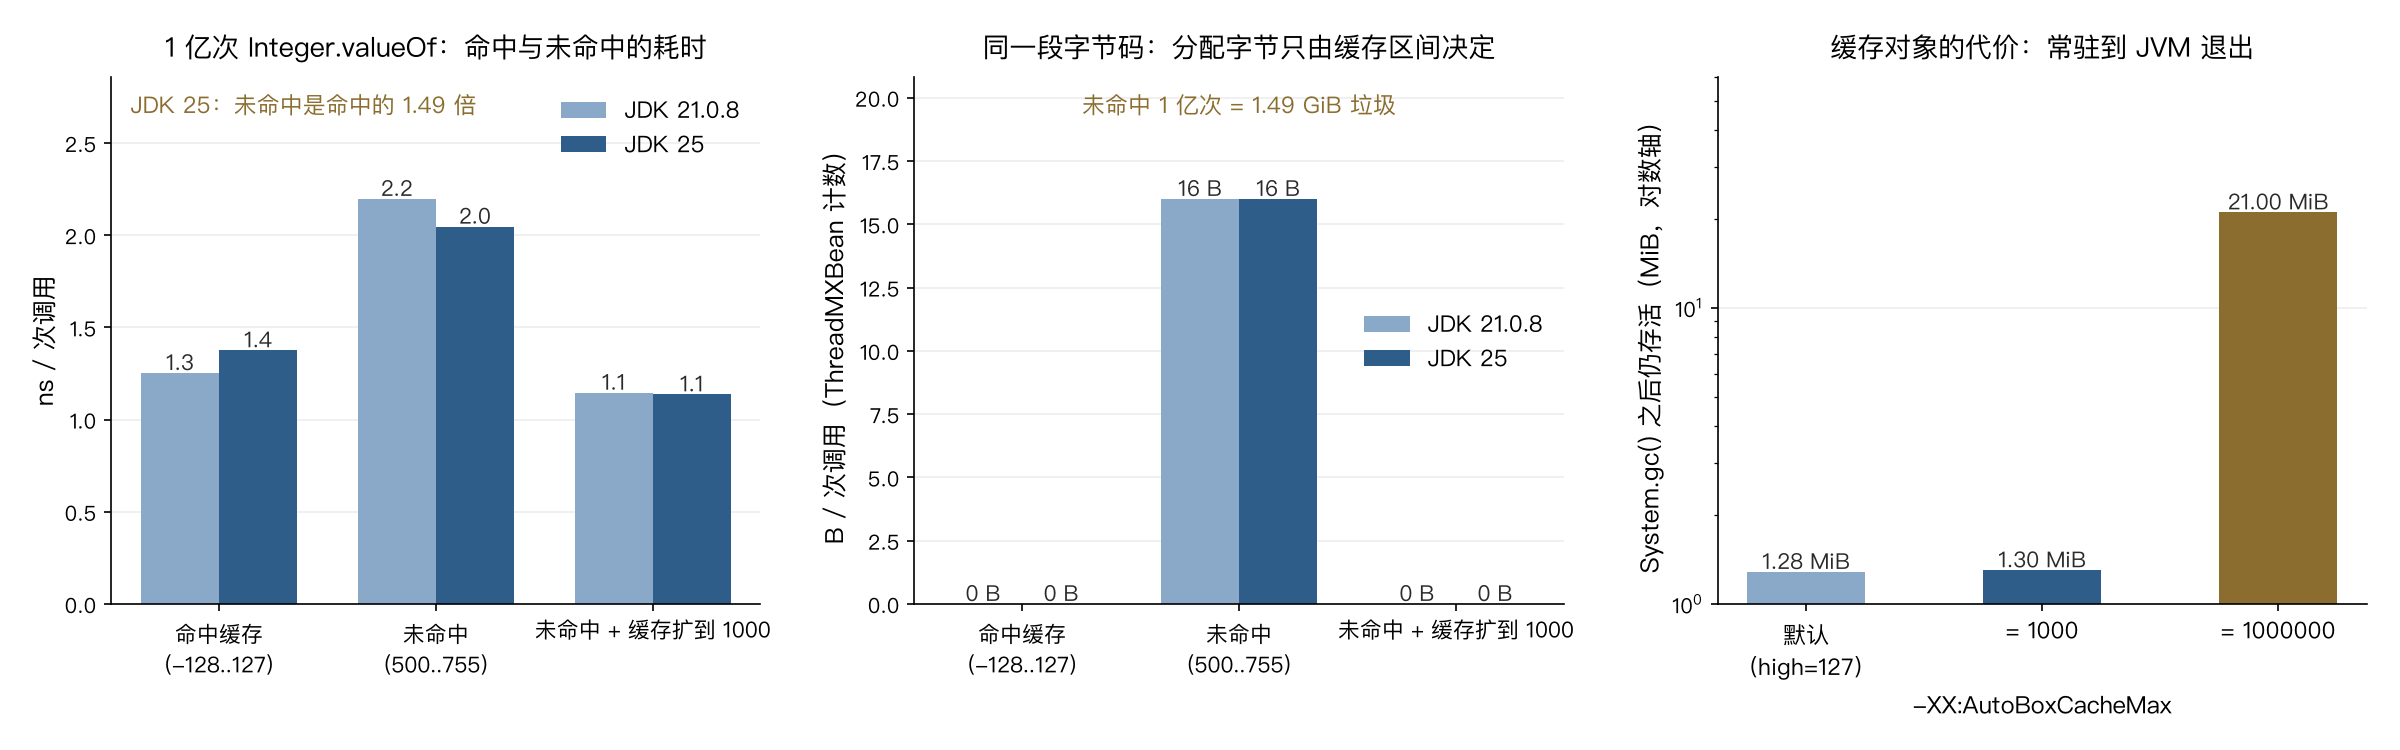
分配字节这一列没有中间值。命中是 0,未命中是每一亿次 1,600,000,000 字节,也就是每次恰好 16 字节,一个 Integer 对象在压缩指针下的完整大小:12 字节对象头加 4 字节 int 字段。这 16 来自 getThreadAllocatedBytes 的逐字节计数。
GC 那一列跟着分配走:命中是 0 次,未命中的三轮里 JDK 25 触发 6 到 10 次 young GC,JDK 21 触发 6 到 8 次。
耗时这一列差得比分配少。把三种模式按每次调用的 ns 摊开:不装箱 0.66,命中 1.38,未命中 2.05。装箱并共享掉分配之后,比完全不装箱多出 0.71 ns,这一段对应范围检查、数组读、引用写入这三步的开销。多分配一个对象再多 0.67 ns,对应 TLAB 里一次指针碰撞加一次写屏障。1.49 倍的总差是这两段加起来的。
加 -XX:AutoBoxCacheMax=1000 之后,未命中那一行的分配从 1,600,000,000 字节掉到 0,GC 次数归零,耗时回到 1.14 ns 每次。没有改一行业务代码,改的是一个 JVM 参数:同一份 class 文件、同一段字节码。
分配那 1.6 GB 的一轮里触发了 10 次 young GC(JDK 25),摊下来每 160 MB 出头一次,这些暂停都算在耗时里。命中那一行不产生垃圾,也就不会触发 GC。
三轮原始数据
每个 JVM 新起,预热 1000 万次,再测 3 轮 1 亿次,原始值不取中位数(毫秒):
| 模式 | JDK | 第 1 轮 | 第 2 轮 | 第 3 轮 |
|---|---|---|---|---|
| 命中 | 21 | 127.3 | 125.2 | 125.0 |
| 命中 | 25 | 140.5 | 137.6 | 136.3 |
| 未命中 | 21 | 300.7 | 219.6 | 209.4 |
| 未命中 | 25 | 210.7 | 204.6 | 190.1 |
| 未命中 + 扩展缓存 | 21 | 117.7 | 110.7 | 114.5 |
| 未命中 + 扩展缓存 | 25 | 114.0 | 113.6 | 112.5 |
| 不装箱对照 | 21 | 66.2 | 65.7 | 65.5 |
| 不装箱对照 | 25 | 67.4 | 66.9 | 65.6 |
轮次之间的离散度不小。未命中那两行的第 1 轮比后面两轮慢,JDK 21 上是 300.7 ms 对 219.6 ms 和 209.4 ms,因为第 1 轮要收拾前一轮留下的垃圾,撞上的 young GC 更多。命中与扩展缓存那几行跨轮次的波动在 5% 以内。按这个分辨力,1.5 倍左右的耗时差测得出来,再小的差别测不出来。
引用同一性
耗时和分配是缓存的一阶效果,二阶效果是身份语义。同一个值两次装箱,== 的结果:
| 值 | 默认 | -XX:AutoBoxCacheMax=1000 |
|---|---|---|
| -129 | false | false |
| -128 | true | true |
| 0、1、127 | true | true |
| 128 | false | true |
| 255、500、755、1000 | false | true |
| 1001、1024 | false | false |
Byte.valueOf(-100) |
true | true |
Short.valueOf(127) |
true | true |
Short.valueOf(128) |
false | false |
Long.valueOf(127) |
true | true |
Long.valueOf(500) |
false | false |
Character.valueOf('a') |
true | true |
Character.valueOf('\u0100') |
false | false |
Boolean.valueOf(true) |
true | true |
两个 JDK 上的结果一致。
一,== 的结果取决于启动参数,不取决于代码。测试环境带 -XX:AutoBoxCacheMax=1000,生产环境不带,同一份代码的 a == b 会从 true 变成 false。编译期不会暴露这类差异,代码评审里也看不出来。
二,旗标只影响 Integer。Long.valueOf(500) 在带旗标的 JVM 里照样是 false,Short、Character 的范围一点没动。参数名 AutoBoxCacheMax 听起来管所有装箱类型,管到的只有 Integer。
三,Byte 全部 256 个值都在缓存里,Byte.valueOf(x) == Byte.valueOf(x) 对任意 byte 都是 true。Boolean 只有两个实例,valueOf 是一个三元表达式直接返回常量。
池子的形状
命中与否是一层,池子怎么取用是另一层。同样装 256 个缓存对象,一种池子是 Integer[] 加范围检查,另一种是 HashMap<Integer, Integer>,后者是手写享元池最常见的写法。两个池子都只装 -128..127 那批已缓存对象,命中率 100%,都不产生新对象。
| 取用方式 | JDK 21 | JDK 25 | 分配字节 |
|---|---|---|---|
Integer[] + 范围检查 |
1.14 ns/次 | 1.19 ns/次 | 0 |
HashMap.get |
2.77 ns/次 | 2.20 ns/次 | 0 |
数组池在 JDK 25 上是 1.19 ns/次,HashMap 池是 2.20 ns/次,差 1.85 倍;JDK 21 上分别是 1.14 和 2.77 ns/次。
两个池子装的是同一批对象,差别落在取用路径上。数组池的每条路径就是一次比较加一次数组读,和 Integer.valueOf 的判定形状一样。HashMap.get 的每条路径要先给 key 装箱(命中缓存时这一步不分配,但要走一次 valueOf),再算哈希、取桶、比对 key。JDK 的缓存特意选数组,就是为了把这份成本从每次取值里去掉。
HashMap 池还有一个数组池没有的问题:get 未命中时返回 null,得自己决定 null 代表「不存在」还是「值就是 null」。数组池的下标永远有效,只要范围检查挡住越界。
对象不逃逸时,缓存就没有意义了
这些数字都建立在一个前提上:装箱对象写进了静态字段 keep,逃出了方法。如果装箱结果只在方法内拆箱用掉,JIT 可以把整个对象删掉,一字节都不分配。
同一段装箱循环,只差有没有 keep = b; 这一行:
| 装箱对象去向 | JDK 21 分配 | JDK 25 分配 | JDK 25 耗时(1 亿次) |
|---|---|---|---|
| 写进静态字段(逃逸) | 16.000 B/次 | 16.000 B/次 | 212.6 ms |
| 只在方法内拆箱(不逃逸) | 0.000 B/次 | 0.000 B/次 | 65.4 ms |
逃逸那一行是 16 字节每次,不逃逸那一行是 0.000 字节每次。C2 的标量替换把对象拆成字段放进寄存器,分配这一步就不存在了。
这条结论会改写「要不要用享元」的判断。装箱的 16 字节值得共享,前提是它逃逸、编译器消不掉;编译器若能证明它不逃逸,这 16 字节根本不存在,缓存也就没有东西可缓存。反过来,把对象存进字段、传出去、放进集合,都算让它逃逸,分配也就躲不掉。
缓存的常驻占用
共享的另一面是这些东西不会被回收。池子里的对象从类初始化开始活到 JVM 退出:
| 参数 | System.gc() 之后仍存活 |
|---|---|
默认(high=127) |
1.28 MiB |
-XX:AutoBoxCacheMax=1000 |
1.30 MiB |
-XX:AutoBoxCacheMax=1000000 |
21.00 MiB |
默认那 1 MiB 多点是 JVM 空载的地板,与缓存无关。1000 那一行比它多 17 KB,对应 1129 个 Integer 对象加一层数组。1000000 那一行多出 19.72 MiB,对应 1,000,129 个对象。这些字节在 System.gc() 之后一个不少:IntegerCache.cache 和 archivedCache 两个静态字段引用着它们,从根上可达,GC 碰不到。
定长池子的占用可以算:(high - low + 1) × 16 字节,再加一层引用数组。high 每加一个数量级,常驻内存跟着加一个数量级。默认的 256 个值是 4 KB,百万级就是 19.72 MiB。
四、边界写在源码里
IntegerCache
JDK 25 的 src.zip 里,java.base/java/lang/Integer.java 第 932 到 984 行就是这条边界:
1 | 932 private static final class IntegerCache { |
几件事在这 23 行里定死了。下界是常量 -128,没有配置入口,Math.max(..., 127) 只夹住上界。上界只从属性读一次,属性不存在时是 127。属性读失败(NumberFormatException)时静默退回 127,不报错,不警告。
第 943 行的 VM.getSavedProperty 是这套机制的入口。它读的是 VM 保存的启动参数,不是 System.getProperties()。实测:-XX:AutoBoxCacheMax=1000 启动的 JVM 里 System.getProperty("java.lang.Integer.IntegerCache.high") 返回 null,用反射调 VM.getSavedProperty 拿到 "1000"。同一个属性,两个 API 一个看不见一个看得见。想在运行时读它来判断缓存范围,读不到。
上界还有一层夹逼,第 949 行把 high 限制在 Integer.MAX_VALUE - (-low) - 1 以内,对应数组长度上限。
缓存从归档里来
第 956 到 979 行是缓存的构造过程:
1 | 956 // Load IntegerCache.archivedCache from archive, if possible |
缓存在类初始化时才填。-128..127 这批对象来自 CDS 归档堆区,构建 JDK 时已经序列化在里面。CDS.initializeFromArchive(IntegerCache.class) 把归档里的数组挂到 archivedCache 上,new Integer 只在两种情况下执行:没有归档,或者需要的区间比归档大。
JDK 21 与 25 在这里有一处实现差别。21 是:
1 | 1041 for(int i = 0; i < c.length; i++) { |
25 改成了先搬归档的那一段、再补剩下的(第 964 到 976 行)。25 的注释解释了原因:归档里的 Integer 和运行时新建的 Integer 之间做身份比较会失败。JDK 25 的 IntegerCache 位于 Integer.java:932-984,JDK 21 的在 :1009-1051,两处的属性解析逻辑逐字相同,只有扩展缓存时的对象来源不同。
valueOf 的判定路径
Integer.java:1002-1007:
1 | 1002 |
方法体 5 行。两次比较、一次数组下标计算、一次加载,或者一次 new。@IntrinsicCandidate 说明 JIT 对它有专门的编译路径。缓存的命中判断只有两个比较和一个数组读:没有哈希、没有 Map.get、也没有锁。
return new Integer(i) 里的构造函数从 JDK 9 起标记为 @Deprecated(since="9"),在 JDK 25 上编译会得到一条移除警告。装箱代码不应该走这一行,走了就是在分配。
JIT 编译后剩下什么
判定路径在源码里是 5 行,编译之后更少。JDK 25 加 -XX:+UnlockDiagnosticVMOptions -XX:+PrintCompilation -XX:+PrintInlining 跑命中模式,loop 方法 C2 编译(第 4 层,带 OSR)的树是:
1 | 149 235 % b 4 BoxBench::loop @ 5 (46 bytes) |
    flowchart TD
    A["Integer.valueOf(i)"] --> B{"i >= IntegerCache.low && i <= IntegerCache.high"}
    B -->|"真"| C["IntegerCache.cache[i + 128]"]
    B -->|"假"| D["new Integer(i)"]
    C --> E["返回池子里的对象,0 字节分配"]
    D --> F["TLAB 里分配 16 字节"]
    F --> G{"引用逃出方法了吗"}
    G -->|"没有"| H["标量替换,16 字节被消掉"]
    G -->|"有"| I["分配真实发生"]
命中那一路的树里没有 Integer::<init>。内联 valueOf 之后,new Integer(i) 那一行在缓存命中的分支里不可达,JIT 不会为它生成代码。未命中那一路的树里多出三层:
1 | @ 19 java.lang.Integer::valueOf (32 bytes) inline (hot) late inline succeeded (boxing method) |
late inline succeeded (boxing method) 是 C2 对装箱方法的延迟内联,配合 EliminateAutoBox(默认开启,-XX:+PrintFlagsFinal 里的 bool EliminateAutoBox = true)使用。它买到的是上一节的标量替换:装箱对象不逃逸时,C2 把 new 出来的对象拆成字段,分配整个消失。
内联还消掉了调用开销。valueOf 是静态方法,调用点在编译期就定死了,内联进来之后,命中判断只剩两次整数比较和一次数组读。如果这层判断藏在一个接口方法或者虚方法后面,这份成本就会以每次调用的形式留在最内层循环里,而它买的只是「可能命中」。这也是缓存判定要写成静态方法加数组的原因。
其它包装类型的区间
| 类型 | 缓存范围 | 可配置 | 源码位置 |
|---|---|---|---|
Integer |
-128 .. 127 | 是,上界可推 | Integer.java:932-984,判定在 :1003-1007 |
Short |
-128 .. 127 | 否 | Short.java:235(size 在 :243),判定在 :277-283 |
Long |
-128 .. 127 | 否 | Long.java:953(size 在 :961),判定在 :995-1001 |
Byte |
-128 .. 127,即全部取值 | 不可能再扩 | Byte.java:108,判定在 :147-150 |
Character |
0 .. 127 | 否 | Character.java:9240(size 在 :9248),判定在 :9282-9287 |
Boolean |
两个常量 | 否 | Boolean.java:177-179 |
Long 的判定写成一行范围检查,和 Integer 同一个形状:
1 | 995 public static Long valueOf(long l) { |
Character 的区间从 0 开始,因为 char 无符号;Byte 的 valueOf 没有分支,直接下标取:
1 | 147 public static Byte valueOf(byte b) { |
Boolean 连数组都不需要,两个静态常量就是池子:
1 | 177 public static Boolean valueOf(boolean b) { |
只有 Integer 的上界由参数决定,上一个实验里 Long.valueOf(500) 就是因此不受 -XX:AutoBoxCacheMax=1000 影响:那个旗标从第 944 行读的属性名开始就只服务于一个类。
旗标的名字和它的语义不一致
-XX:AutoBoxCacheMax=1000 传的值是上界还是容量,实测把 128 显式传进去就看得出来:
- 不带这个参数:
Integer.valueOf(128) == Integer.valueOf(128)是 false - 带
-XX:AutoBoxCacheMax=128:结果是 true
属性值会先过 Math.max(parseInt(value), 127),再赋给 high。传 128 时 high = 128,缓存变成 -128..128,129 个值。旗标的默认值在 -XX:+PrintFlagsFinal 里也显示 128,但这个默认值用不上:不显式传参时属性是 null,high 停在 127。传 -XX:AutoBoxCacheMax=127 和什么都不传等价。
同一个数字,不传和传,行为差一个值。这种边界只有对着源码读一遍才能确定。
五、什么时候用
判断顺序
    flowchart TD
    A["有一批对象被反复创建"] --> B{"对象可变吗"}
    B -->|"可变"| B1["享元不适用,看对象池"]
    B -->|"不可变"| C{"实例之间有多少字段是重复的"}
    C -->|"没有重复,每个都不一样"| C1["没有可共享的部分,池子只会占内存"]
    C -->|"有重复,取值集合小"| D{"取值集合有多大"}
    D -->|"能枚举,几十到几千"| E["建池,取值集合就是池子大小"]
    D -->|"无界"| D1["用 LRU 之类有上界的缓存,不要无界池"]
    E --> F{"有地方用 == 比较对象吗"}
    F -->|"有"| F1["改掉,绑定到 == 的语义会在参数或版本变化时失效"]
    F -->|"没有"| G["测量额外分配量与常驻占用的比值"]
    D1 --> G
    C1 --> G
    G --> H{"省下的分配量超过常驻占用吗"}
    H -->|"是"| I["值得共享"]
    H -->|"否"| J["不值得,保持每次新建"]
值得共享的时候
判据可以压成两条:对象不可变,取值集合有界且重复率高。满足这两条时,收益先落在分配上:本次实验里每次 16 字节变成 0,1 亿次调用少分配 1,600,000,000 字节,少 6 到 10 次 young GC。耗时上的收益要小得多,1.49 倍,因为省下的只是一次指针碰撞。
第三条判据是池子要小。池子是定长的,占用等于取值集合大小乘以对象大小,而且永不回收。-XX:AutoBoxCacheMax=1000000 换来的是 19.72 MiB 常驻内存,这笔账只有在那个区间高频出现时才划得来。
不值得共享的时候
对象可变。 共享可变对象要靠借用归还协议管理,归对象池管。两者的失败模式不同:享元池太小只会多占内存,对象池协议写错会丢数据。
把身份语义当契约。 任何靠 a == b 判断相等的地方,都在依赖一个由启动参数决定的事实。JDK 自己都不敢承诺:Integer.valueOf 的 javadoc 只说「总是缓存 -128 到 127,可能缓存这个范围之外的值」。写成「一定」的地方就是 bug。
每次都要新建的语义。 有些代码靠 new 拿到一个独一无二的身份,比如用作锁对象或者 IdentityHashMap 的键。这类对象不能进池子。
自己写池子时的形状
JDK 的写法可以直接抄:静态数组、构造时填满、取值路径上做一次范围检查。
1 | final class Unit { // 取值集合固定的小枚举式类型 |
池子在静态初始化块里填满,类初始化完成对所有线程可见由 JVM 保证,of 不需要同步;构造函数私有,外面拿不到没进池子的实例;取值路径是范围检查加数组读,和 Integer.valueOf 同形,一次比较加一次加载。
参数来自外部输入时,范围检查必须抛异常。IntegerCache 可以不抛,因为它的输入是 int,判定不通过就走新建分支;固定大小的池子没有这个退路,越界只能报错。用 Map 做池子时这一点更明显:get 越界返回 null,错误会推迟到使用点才炸。
池子的内存账可以算:(high - low + 1) × 对象大小,加一层引用数组。Integer 在压缩指针下是 16 字节,256 个值就是 4 KB;一千个值是 16 KB。这笔内存从类初始化开始就一直占着。
池子通常做成单例。多份池子会稀释共享率,同一组值存两遍,常驻内存也翻倍。JDK 的做法是把池子做成 IntegerCache 这个私有静态嵌套类,外面连类型都看不到,只有 valueOf 这一个入口。
池子只对重复出现的值有效:如果一亿次调用里有一亿个不同的值,池子每次都不命中,付出的是一层范围检查和一份常驻内存,拿不到分配上的好处。IntegerCache 的默认区间是 -128..127,正值小整数、数组下标、状态码这些高频值都落在里面,这是它值得存在的原因。
池子和函数是两种抽法
外在状态如果是几个数值,还有一种更省的做法:根本不建对象,直接对参数做计算。Integer 的两个操作,取原始值和比较大小,在用户态都可以直接对 int 做,不需要对象。JDK 做缓存是为了让装箱的语法糖不至于每次都分配;Integer 不是拿来当主力类型的。能用 int 的地方用 int,需要对象的边界上用对象。
共享的极端形态是把对象本身去掉,这个方向和不可变与防御性拷贝是同一个问题的两面:一个问「能不能大家一起用」,一个问「要不要复制一份」。
总结
- 享元共享的是不可变的内在状态,外在状态作为参数每次传进来。
Integer缓存是它的标准实例:内在状态是那个int,池子是一层static final Integer[]。 - 1 亿次
Integer.valueOf,值在-128..127时分配 0 字节、0 次 GC;值在500..755时每次 16 字节,一亿次 1,600,000,000 字节,JDK 25 触发 6 到 10 次 young GC,中位数 204.6 ms 对命中的 137.6 ms。 - 耗时差只有 1.49 倍(JDK 25),远小于分配上的差别。一次对象分配净增 0.67 ns,分配这一步在 TLAB 里很便宜,代价的形态是 GC 次数:同一轮 1.6 GB 垃圾对应 6 到 10 次 young GC,命中那一行是 0 次。
- 加
-XX:AutoBoxCacheMax=1000跑同一段字节码,未命中那行的分配掉到 0,GC 归零,耗时回到 1.14 ns 每次。改的是一个启动参数,代码一行没动。 IntegerCache在 JDK 25 的Integer.java:932-984:下界是常量-128(:933),上界来自VM.getSavedProperty("java.lang.Integer.IntegerCache.high")(:944),解析失败静默退回 127。VM.getSavedProperty与System.getProperty读的不是同一份数据:带旗标启动的 JVM 里前者返回"1000",后者返回null。- 缓存的
-128..127那批对象来自 CDS 归档堆区(:957),JDK 25 在扩展缓存时先复用归档对象再补新的(:964-976),JDK 21 是整个数组重建(Integer.java:1041-1043)。 - 五种包装类型的缓存范围各不相同:
Byte全部取值都缓存且无分支(Byte.java:147-150),Character是0..127(Character.java:9282-9287),Boolean是两个常量(Boolean.java:177-179),只有Integer的上界可配置。 -XX:AutoBoxCacheMax=128把上界推到 128,不带这个参数时上界是 127。旗标的默认值显示为 128,但默认不生效。==的结果随启动参数变化:a == b在500上,默认 false,带-XX:AutoBoxCacheMax=1000是 true。绑定到这个语义上的代码不可移植。- 池子永不回收:
-XX:AutoBoxCacheMax=1000000时System.gc()之后常驻 21.00 MiB,比默认多 19.72 MiB。
参考资料
- Integer (Java SE 25)
- Integer (Java SE 21)
- Long (Java SE 25)
- Byte (Java SE 25)
- Short (Java SE 25)
- Character (Java SE 25)
- Boolean (Java SE 25)
- ThreadMXBean.getThreadAllocatedBytes
- JLS 5.1.7: Boxing Conversion
- JEP 350: Dynamic CDS Archives
- 系列总纲:设计模式的成本账
系列索引:设计模式系列