设计模式——迭代器:分配与逃逸分析
ArrayList.iterator()只有一行实现:return new Itr();。按字面读,每轮 for-each 都新建一个对象。
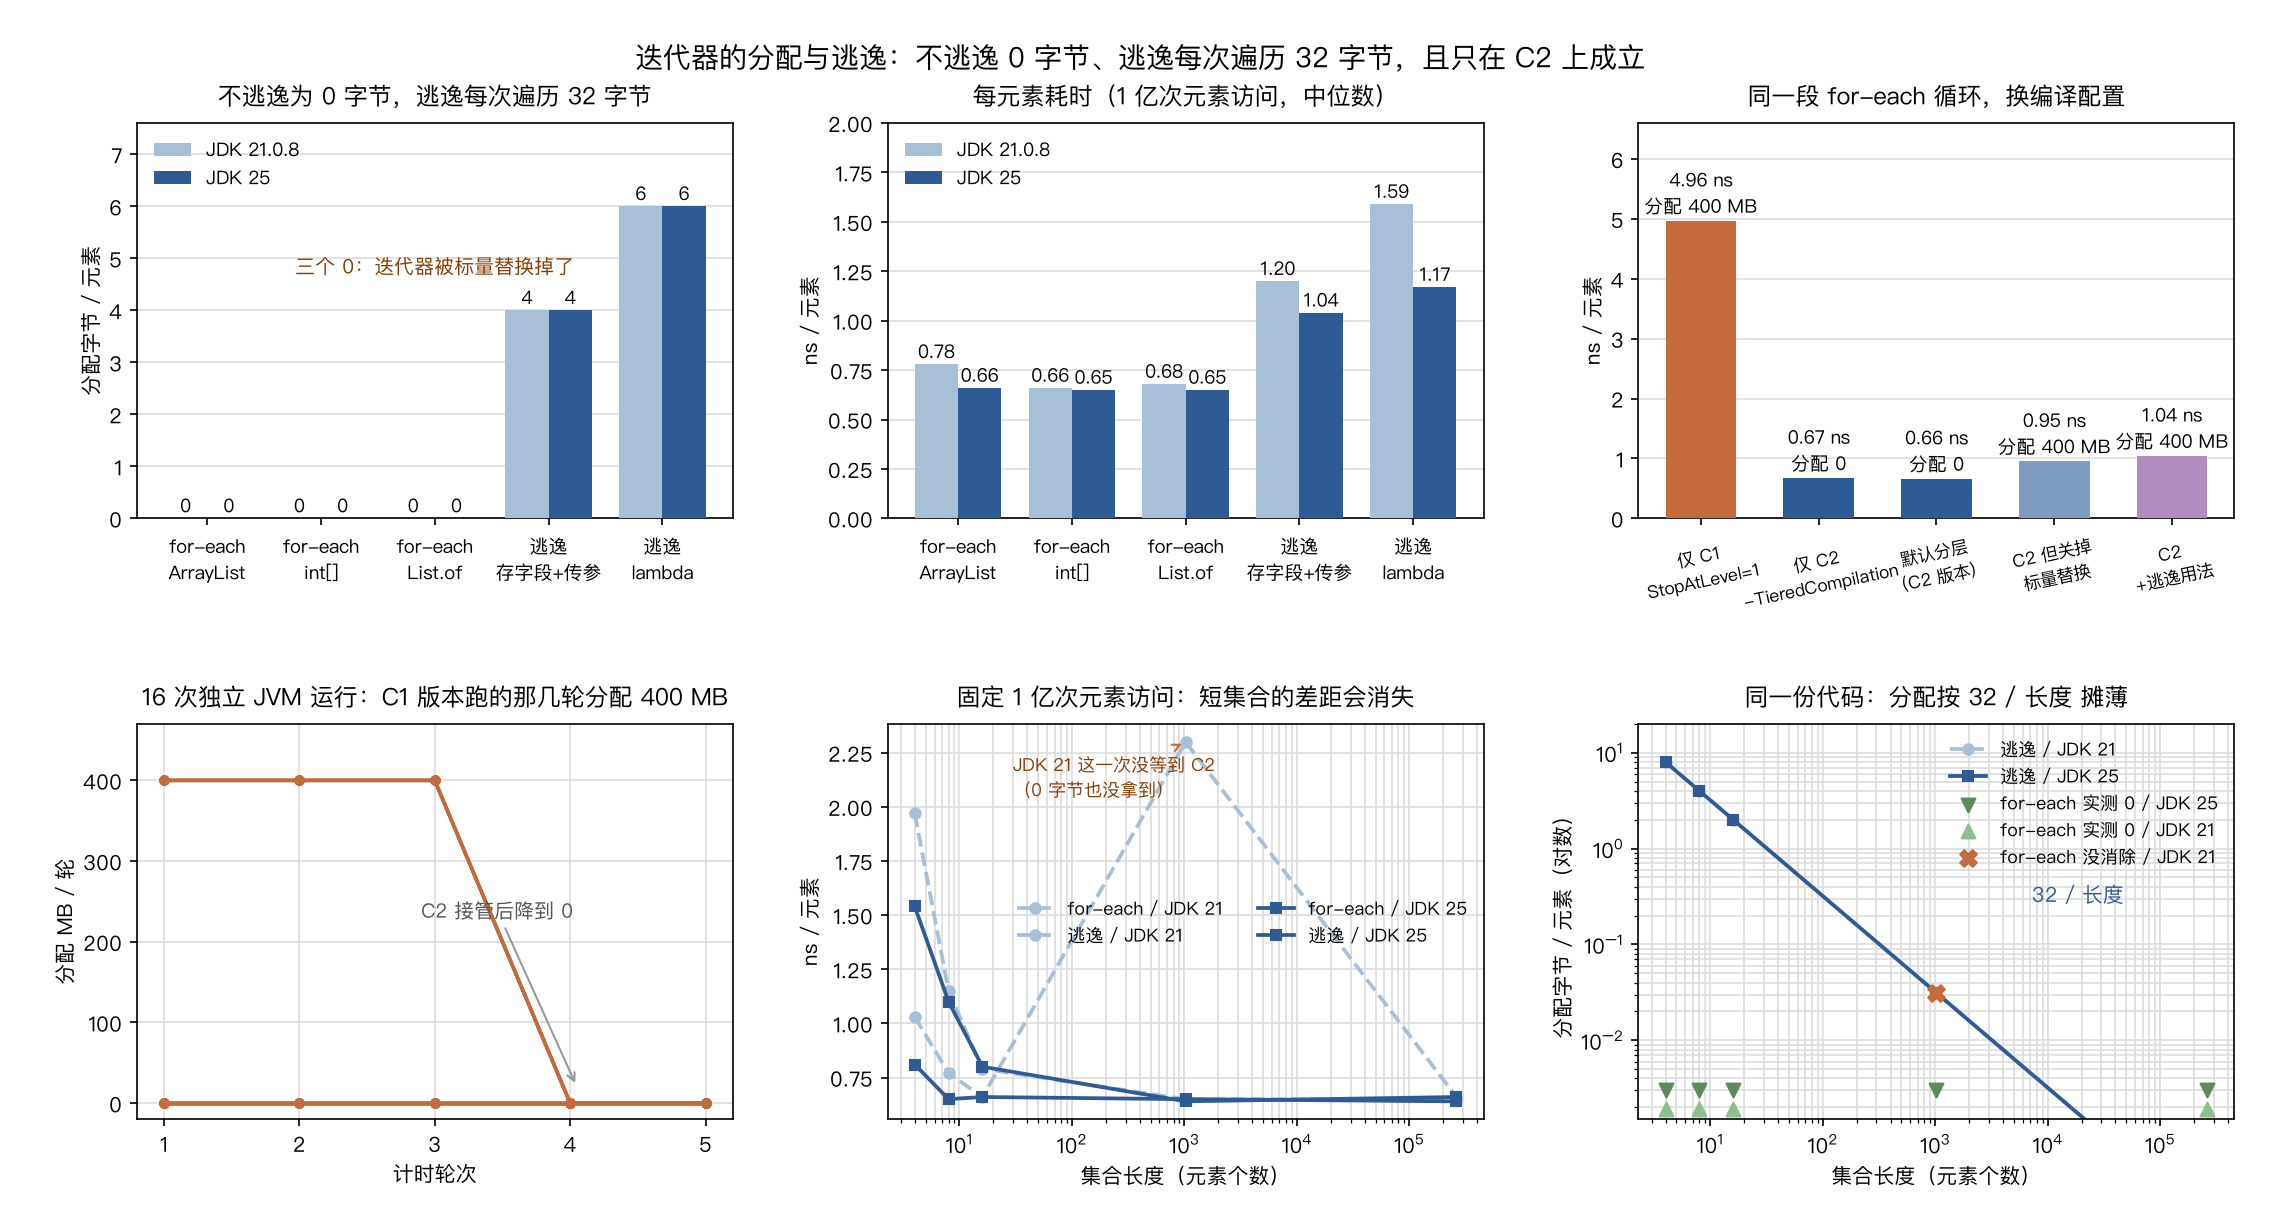
实测 1250 万轮遍历:for-each 的分配是 0 字节,把迭代器存进字段的是 400 MB。差值来自 C2 的逃逸分析。
把同一段代码丢给 C1,0 字节这一列就没有了。分配消除是当前那个编译版本的性质,同一份代码换个层级,这一列就变。
一、一行 new 和 0 字节的分配
ArrayList 的 iterator() 在 JDK 25 里长这样,java.base/java/util/ArrayList.java:1029:
1 | public Iterator<E> iterator() { |
Itr 定义在同一个文件 :1036,三个 int 字段加一个构造函数:
1 | private class Itr implements Iterator<E> { |
按这份源码的字面意思,一次 for (int x : list) 遍历 8 个元素会新建 1 个 Itr。1250 万轮就是 1250 万个对象。
javac 把 for-each 编译成了迭代器调用。用 javap -c 看同一段代码的两个版本:
1 | static long foreachList(java.util.List<java.lang.Integer>); |
同一份 javap 输出里,int[] 的 for-each 编译成了下标循环,没有迭代器对象:
1 | static long foreachArray(int[]); |
数组上的 for-each 不分配对象,这件事在编译期就定了。集合上的 for-each 里躺着一条 new Itr() 指令,每次编译都在,会不会执行得看运行期。
系列总览那篇(被语言吃掉的那些模式)讲的是语法层面的接管:for-each 把 hasNext / next 的手写循环交给编译器。编译器接管了语法,没接管分配。new 就写在源码里,JIT 得在运行期证明这个对象用不着,才能把它删掉。
二、实验设计与口径
实验测的是同一个集合上的同一次遍历,只改迭代器引用的去向。集合用 ArrayList<Integer>,8 个元素,值取 0 到 7,落在 Integer 缓存区间里,排除装箱带来的额外分配。一轮 = 一次 iterator() 调用加走完 8 次 hasNext / next。
三种用法:
- 不逃逸:
for (int x : l) sum += x;,迭代器是方法内的临时变量。 - 逃逸(字段):
Iterator<Integer> it = l.iterator(); ESCAPED = it;存进静态字段,再作为参数传进drain(Iterator)。 - 逃逸(lambda):
CAPTURED = () -> SINK = drain(it);lambda 本身存进静态字段,再调用一次。
三个对照:int[] 的 for-each(没有迭代器对象)、List.of(...) 的 for-each(换一份迭代器实现 ImmutableCollections.ListItr)、以及把迭代器只作为参数传给方法但不存字段(argescape)。
另加一组跨线程:迭代器在调用线程创建,交给每次新建的虚拟线程遍历。
集合取 8 个元素,是为了让每轮遍历的开销露出来。一次遍历分配一个迭代器,这个开销按元素个数摊薄:8 个元素摊到每元素 4 字节,26 万个元素摊到 0.0001 字节。第三节把长度从 4 扫到 262144,量这条曲线在什么位置变得无所谓。
测量口径:
- 耗时:
System.nanoTime()包住整个循环,先热 5 轮再计时 5 轮,取中位数。每轮的值都记进日志,不只看中位数。 - 分配字节:
com.sun.management.ThreadMXBean.getThreadAllocatedBytes(currentThread)在每轮前后各读一次。这个计数来自 JVM 的分配计数器,不受 GC 影响。 - 规模:主表每种用法跑 1250 万轮,合计 1 亿次元素访问。虚拟线程那组每轮要建线程,降到 20 万轮。
- 机器:Apple M1 Pro,macOS Darwin 25.6.0,JDK 21.0.8+12-LTS-250 与 25+37-LTS-3491,都是 arm64,默认 G1 与默认分层编译。
- 每个用法都在独立 JVM 里跑。同一个 JVM 里跑多个用法会让它们互相污染编译配置,这一点在第三节会看到后果。
这份测量的局限:本机没有 JMH,这是单机微基准,只用来判断量级,不能当硬件上限。计时循环里包着逃逸版本每轮 400 MB 的分配,G1 的回收成本算在耗时里,这一部分没有单独拆出来。
最直接的那条证据这次拿不到。-XX:+PrintEliminateAllocations 在 product 版 JVM 上会被拒绝:
1 | $ java -XX:+UnlockDiagnosticVMOptions -XX:+PrintEliminateAllocations -version |
本机四个 JDK(11、17、21、25)都是 product 版,没有 debug 构建。替代方案是四条:分配字节计数、-XX:-EliminateAllocations 开关、编译层级开关、以及 -XX:+PrintCompilation 的层级轨迹。字节码一个字不改,只换 VM 开关,分配从 0 变成 400 MB,这个差值只能来自编译器的分配消除。
内联证据来自 -XX:+PrintInlining。标量替换的前提是构造与读取全部内联展开,下面这段输出说明 Itr 的构造函数和内层方法都进了内联:
1 | @ 13 java.util.ArrayList::iterator (9 bytes) inline (hot) |
复现用的命令是一个单文件程序,编译和运行各一行:
1 | $ JH25=$(/usr/libexec/java_home -v 25) |
参数依次是:用法、轮数、热轮数、计时轮数、集合长度。
    graph TD
    A["l.iterator() 里的 new Itr()"] --> B{"迭代器引用去了哪"}
    B -->|"只在本方法里用,用完即弃"| C["不逃逸:NoEscape"]
    B -->|"存进静态字段 / 传给别的方法"| D["逃逸:全局可见"]
    B -->|"被 lambda 捕获,lambda 本身逃逸"| E["随 lambda 对象一起逃逸"]
    B -->|"交给另一个线程"| F["跨线程逃逸"]
    C --> G["标量替换:对象拆成局部变量,分配被删掉"]
    D --> H["堆上分配:每次遍历 32 字节"]
    E --> H
    F --> H
三、实测
集合 8 个元素,一轮 = 一次 iterator() 加走完 8 个元素,1250 万轮 = 1 亿次元素访问。每种用法在独立 JVM 里热 5 轮、计时 5 轮,下表取中位数;括号里是那一列的单位。
| 用法 | 分配字节/轮 (21) | (25) | 分配字节/元素 (21) | (25) | ns/元素 (21) | (25) | 中位耗时 ms (21) | (25) |
|---|---|---|---|---|---|---|---|---|
for-each(ArrayList) |
0 | 0 | 0.00 | 0.00 | 0.78 | 0.66 | 78 | 66 |
for-each(int[]) |
0 | 0 | 0.00 | 0.00 | 0.66 | 0.65 | 66 | 65 |
for-each(List.of) |
0 | 0 | 0.00 | 0.00 | 0.68 | 0.65 | 68 | 65 |
| 逃逸:存静态字段 + 传参 | 400000000 | 400000000 | 4.00 | 4.00 | 1.20 | 1.04 | 120 | 104 |
逃逸:List.of 的迭代器 |
400000000 | 400000000 | 4.00 | 4.00 | 1.16 | 0.93 | 116 | 93 |
| 逃逸:lambda 捕获 | 600000000 | 600000000 | 6.00 | 6.00 | 1.59 | 1.17 | 159 | 117 |
三个不逃逸的写法都是 0 字节
三个不逃逸的写法在分配这一列上都是 0 字节,5 轮全是 0。ArrayList 的 Itr 和 List.of 的 ListItr 是两个不同的类、两份不同的实现,分配计数都是 0。按源码字面读,1250 万轮该造出 1250 万个迭代器,实测一个都没有。
耗时这一列上,集合版本贴在 int[] 的下标循环上:JDK 25 上 0.66 对 0.65 ns/元素,差 1.5%;JDK 21 上 0.78 对 0.66,差 15.4%。指针跟随、边界判断、Integer.intValue() 这些开销还在,迭代器对象不在了。
逃逸之后,每次遍历固定 32 字节
逃逸那三行的分配字节是整数:每轮 400000000 字节,两个 JDK 一致。除以 8 个元素是 4.00 字节/元素,乘 1250 万轮正好 400000000。这就是源码里那条 new Itr(),前面它躺在字节码里不执行,现在每轮执行一次。List.of 的迭代器被存进字段时也是同样的 400000000 字节,对象体积一样,类的来源不同。
耗时从 0.66 涨到 1.04 ns/元素(JDK 25),1.58 倍。这个倍数里除了分配本身,还包括这 400 MB 垃圾的回收成本,G1 的 young GC 就停在计时循环里(本节最后有次数)。
对象体积是量出来的
有了分配计数,对象体积可以直接换算。单独跑一个探针,每次分配都存进静态字段保证活到测量之后,计数除以次数:
| 表达式 | 分配字节 / 次 | 布局 |
|---|---|---|
() -> {}(不捕获) |
0.0 | 不捕获的 lambda 实例被 invokedynamic 的 call site 缓存,不重复分配 |
() -> SINK(it)(捕获一个引用) |
16.0 | 12 字节对象头 + 4 字节被捕获的引用 |
l.iterator()(ArrayList) |
32.0 | 12 + 3 个 int + this$0 引用,补齐到 32 |
imm.iterator()(List.of) |
32.0 | 12 + 1 个引用 + 2 个 int + 1 个 boolean,补齐到 32 |
两个 JDK 上的读数一致。这也解释了 capture 那一列每轮多出来的 16 字节:32 字节的迭代器,加上捕获它的 lambda 实例。迭代器本来能停在方法里,只要被 lambda 捕获,lambda 类就多了一个字段,实例缓存不了,每次都要新建。
反证一:关掉标量替换
| 开关 | 用法 | 分配字节/轮 (21) | (25) | ns/元素 (21) | (25) |
|---|---|---|---|---|---|
| 默认 | for-each | 0 | 0 | 0.78 | 0.66 |
-XX:-EliminateAllocations |
for-each | 400000000 | 400000000 | 0.92 | 0.95 |
-XX:-DoEscapeAnalysis |
for-each | 400000000 | 400000000 | 0.99 | 0.96 |
| 默认 | 逃逸 | 400000000 | 400000000 | 1.20 | 1.04 |
-XX:-EliminateAllocations |
逃逸 | 400000000 | 400000000 | 1.14 | 1.04 |
默认(drain 可内联) |
传参 | 0 | 0 | 0.78 | 0.61 |
-XX:CompileCommand=dontinline |
传参 | 400000000 | 400000000 | 1.31 | 1.31 |
-XX:-EliminateAllocations 只关掉标量替换。字节码一个字没改,for-each 的分配从 0 变成 400000000 字节/轮,耗时从 0.66 涨到 0.95 ns/元素(JDK 25)。-XX:-DoEscapeAnalysis 关得更靠上游,连逃逸分析本身都不跑,结果在同一量级:400000000 字节/轮、0.96 ns/元素。逃逸那一列在这两个开关下不动(400000000 字节/轮),它本来就在分配。
表里最后两行是另一条边界。同一个 drain(it) 传参,什么都不改,只把 drain 标成不可内联,分配从 0 变成 400000000 字节/轮。逃逸分析跑在内联之后的代码上,方法一旦内联不进来,参数就落到堆上。迭代器可以只在方法之间流动而仍然不逃逸,前提是 JIT 把沿途每个调用都内联展开。
反证二:跑在 C1 上就没有消除
-XX:TieredStopAtLevel=1 把编译停在第 1 层,只用 C1。同一个程序、同一份字节码,分配字节从 0 变成每轮 400 MB,两个 JDK 一致,30 轮测量里一次例外都没有。耗时从 0.66 涨到 4.96 ns/元素。
反过来,-XX:-TieredCompilation 只允许 C2 编译,分配是 0 字节,两个 JDK 各 3 次运行、每次 5 轮都没有例外。
原因在分层编译的分工上:逃逸分析和标量替换是 C2 的优化,C1 不做。同一段循环,先被 C1 编译(tier 3,带 profiling),再被 C2 编译(tier 4)。跑在哪个版本上,分配就不一样。-XX:+PrintCompilation 的轨迹能看到这次交接:
1 | === JDK25 编译层级轨迹(-XX:+PrintCompilation,只看 Plain::plain)=== |
第 3 行是 tier 3 的 OSR 编译,也就是第一次把这个循环编译成机器码的那个版本,它分配。第 4 行的 % 4 是 tier 4(C2)的 OSR 编译,第 5 行的 made not entrant: OSR invalidation of lower levels 表示 tier 3 那个版本被换掉。之后同一个循环是 0 字节。
这和 -XX:-EliminateAllocations 那一行不是一回事。C2 不做标量替换时,每轮耗时 95 ms(0.95 ns/元素);C1 跑同样的分配时是 496 ms。两个都分配 400 MB,速度差 5.2 倍。分配字节相同,代码质量差在别处。
| 编译配置 | 跑的是谁 | 分配字节/轮 | ns/元素 | 每轮耗时 ms |
|---|---|---|---|---|
-XX:TieredStopAtLevel=1 |
只有 C1 | 400000000 | 4.96 | 496 |
| 默认分层(5 轮之后) | C2 | 0 | 0.66 | 66 |
| 默认分层(还没轮到 C2) | C1(tier 3) | 400000000 | 2.29 | 229 |
默认 + -XX:-EliminateAllocations |
C2,不做标量替换 | 400000000 | 0.95 | 95 |
| 默认 + 逃逸用法 | C2,对象逃逸 | 400000000 | 1.04 | 104 |
同一份代码,8 次运行里有 2 到 3 次没消除
| 用法 | JDK 21 测到 0 字节 | 测到 400 MB | JDK 25 测到 0 字节 | 测到 400 MB |
|---|---|---|---|---|
for-each(ArrayList) |
6/8 | 2/8 | 5/8 | 3/8 |
for-each(List.of) |
7/8 | 1/8 | 6/8 | 2/8 |
| 逃逸:存静态字段 + 传参 | 0/8 | 8/8 | 0/8 | 8/8 |
上面三节测的是「这台机器、这一次运行」的结果。把同样的参数拆成独立 JVM 各跑一次,每次热 5 轮只测 1 轮,结果分成了两堆:大多数运行从第一轮起就是 0 字节,少数运行前 3 轮是 400 MB,第 4 轮跳回 0。后者就是 C1 版本被 C2 替换掉的那个时刻。
另写一个最小程序(main 里直接调用,没有方法引用分派)跑 16 次,复现了同一件事:JDK 21 有 5 次、JDK 25 有 0 次出现「前 3 轮每轮 400 MB、耗时 229 ms,之后降到 0 字节、66 ms」,每次都在同一轮数上切换。
| 运行 | 第 1 轮 | 第 2 轮 | 第 3 轮 | 第 4 轮 | 第 5 轮 |
|---|---|---|---|---|---|
| JDK 21 典型失败 | 400 MB / 229 ms | 400 MB / 229 ms | 400 MB / 228 ms | 0 / 76 ms | 0 / 77 ms |
| JDK 25 正常 | 0 / 66 ms | 0 / 65 ms | 0 / 65 ms | 0 / 65 ms | 0 / 66 ms |
逃逸那一列 16 次全部是 400 MB,没有一次例外,也没有一次中途改变。不逃逸的对象能不能被消掉取决于编译状态,逃逸的对象没有这个不确定性。
一次跑出 0 字节不能当成保证:要断言「这段代码不分配」,得先确认它跑在 C2 上,再看多轮结果是否一致。本文主表里每一轮的分配值都相同(要么 5 轮全 0,要么 5 轮全 400 MB),没有混合状态,中位数才有意义。
逃逸的去处:lambda 与跨线程
| 用法(20 万轮) | 主线程分配字节/轮 (21) | (25) | ns/元素 (21) | (25) | 中位耗时 ms (21) | (25) |
|---|---|---|---|---|---|---|
| 迭代器交给虚拟线程 | 107172208 | 113580672 | 715 | 670 | 1144 | 1072 |
| 对照:线程里没有迭代器 | 99175752 | 105566144 | 641 | 865 | 1025 | 1384 |
每轮新建一个虚拟线程再 join,每元素成本从纳秒级跳到几百纳秒:JDK 25 上 670 ns/元素,是同一线程逃逸版本(1.04 ns/元素)的 644 倍。对照组把线程里的遍历换成数组下标求和,还有 865 ns/元素(JDK 21 上 641 对 715,方向在两个 JDK 之间是反的)。
迭代器那一份分配被线程成本淹没了。这一列里两个版本的差值在噪声里,测不出迭代器分配的影响;能确定的是,跨线程传递迭代器的成本大头在线程上。分配字节这一列统计主线程,包含 Thread 对象、lambda 和结果数组,对照组给出这批脚手架的量,两者之差才是迭代器。
集合变长以后,这件事自己消失
| 集合长度 | 轮数 | for-each 分配/轮 (21) | (25) | 逃逸 分配/轮 (21) | (25) | for-each ns/元素 (21) | (25) | 逃逸 ns/元素 (21) | (25) |
|---|---|---|---|---|---|---|---|---|---|
| 4 | 25000000 | 0 | 0 | 800000000 | 800000000 | 1.03 | 0.81 | 1.97 | 1.54 |
| 16 | 6250000 | 0 | 0 | 200000000 | 200000000 | 0.66 | 0.66 | 0.79 | 0.80 |
| 1024 | 97656 | 3124992 | 0 | 3124992 | 3124992 | 2.30 | 0.65 | 0.65 | 0.64 |
| 262144 | 381 | 0 | 0 | 12192 | 12192 | 0.66 | 0.64 | 0.65 | 0.66 |
分配这一列按 32 除以长度走:长度 4 时每元素摊到 8.00 字节,长度 16 时 2.00,长度 1024 时 0.0312,长度 262144 时 0.00012。同一个 32 字节的迭代器,摊进 1 亿次元素访问就没了。
耗时那一列同样收敛。长度 4 时两个用法是 0.81 对 1.54 ns/元素;长度 262144 时是 0.64 对 0.66,两条线合上了。
这张表还拍到两次编译层级切换。JDK 25 长度 4 的那一次,第一个计时轮是 800 MB、之后两轮是 0,原始日志里是 bytesList=[800000000, 0, 0];JDK 21 长度 1024 的那一次反过来,三轮全是 3,124,992 字节,也就是 97,656 个迭代器,全程没等到 C2。同一台机器上的两次运行,一个在第三轮切换成功,一个整轮没等到。
这些垃圾真的要回收
逃逸版本一轮 1250 万次遍历分配 400 MB,够触发好几次 G1 的 young GC。打开 -Xlog:gc 单独跑一轮:
1 | [0.005s][info][gc] Using G1 |
一轮里 young GC 停在 6 次(JDK 21)与 6 次(JDK 25),每次回收前堆里约 150 MB,暂停时间在 0.5 ms 到 3 ms 之间。for-each 版本在这段时间里没有任何东西要回收。
遍历次数越多,逃逸版本的垃圾按比例增长,for-each 版本这一列一直是 0。
四、JDK 源码里的几份迭代器
ArrayList.Itr 是重写版
ArrayList 没有用 AbstractList 的迭代器,自己写了一份。注释写在类定义上方,JDK 25 ArrayList.java:1034:
1 | /** |
被替换掉的那份在 java.base/java/util/AbstractList.java:345。ArrayList.Itr 的 next() 直接读 elementData,跳过了 AbstractList.get(int) 的虚调用。接口一样,每次遍历省一次虚调用,代价是多维护一份代码。
Itr 的 32 字节是怎么来的
Itr 是非静态内部类,javap -p 能看到一个合成字段:
1 | class java.util.ArrayList$Itr implements java.util.Iterator<E> { |
对象头 12 字节(压缩指针)+ 三个 int 共 12 字节 + this$0 引用 4 字节 = 28 字节,按 8 字节对齐后是 32 字节。实测逃逸那一列每轮 32 字节,与布局吻合。把它改成 static class 能省掉 this$0,但它要读外层 ArrayList 的 size、elementData、modCount 三个字段,静态化之后每次访问都要多传一个参数。
List.of 用的是另一份实现
List.of(...) 返回 ImmutableCollections.List12 或 ListN,它们的 iterator() 在 java.base/java/util/ImmutableCollections.java:301:
1 |
|
ListItr 在 :363,字段带 @Stable:
1 | static final class ListItr<E> implements ListIterator<E> { |
另一份实现、另一个类、另一组字段,跟 ArrayList.Itr 没有继承关系。两份实现在 C2 上的结果一样:for-each 里 0 字节,逃逸时每轮 32 字节。标量替换判定的是「这个对象有没有逃出方法」,跟它属于哪个类无关。 JDK 21 的 ImmutableCollections.java 与 JDK 25 逐行相同(:344 对 :363),差别不在源码里。
Spliterators.iterator 每次调用都分配
java.base/java/util/Spliterators.java:654 是从 Spliterator 造 Iterator 的工厂:
1 | public static<T> Iterator<T> iterator(Spliterator<? extends T> spliterator) { |
方法体末尾 :698 是 return new Adapter();。Adapter 有状态(valueReady、nextElement),没法共享,每次调用新建一个。在 for-each 里它同样可能被标量替换,但这个工厂的用途就是把迭代器返回给调用方,它必然逃逸,分配躲不掉。
能共享的迭代器长什么样
java.base/java/util/Collections.java:4631:
1 | public static <T> Iterator<T> emptyIterator() { |
空迭代器没有状态,一个静态实例发给所有调用方,零分配。Itr、ListItr、Adapter 都有 cursor 之类的状态,一个实例同时只能服务一次遍历,共享不了。能不能省掉这次分配,取决于两件事:它逃不逃逸,它有没有状态。
五、什么时候该在意这 32 字节
先看集合长度,成本按 32 字节除以元素个数摊,长度到几百以上这一项就不值得看一眼。长度是个位数,再问迭代器会不会离开当前方法。会逃逸,就只能改写法,for-each、Iterable.forEach、forEachRemaining 这三种都不把迭代器交出去。不逃逸,还要确认这段代码有没有热到进 C2:实测 C1 编译的版本每轮分配 400 MB,C2 的版本是 0。三个条件都满足,这 32 字节可以忘掉。
长度 8 时逃逸版本是 1.04 ns/元素(JDK 25),长度 262144 时两种写法都是 0.66 上下,差 3.0%,长度这一维自己就把问题消掉了。同一段循环在 C1 与 C2 之间差 400 MB 每轮,编译层级这一维绕不过去。16 次独立运行里 for-each 有 5 次没有消除。
不用管的情况
- 集合够长。 一次遍历只分配一个迭代器,成本被元素个数摊薄。26 万个元素的集合,每元素摊到 0.00012 字节。
- 代码只跑在 C2 上。 服务端 JVM 默认分层编译,热点循环最终都会进 C2,逃逸分析在那里生效。前提是这段代码热到了被重新编译的程度。
- 每次遍历干的活比几次虚调用重。 迭代器开销是每元素两次调用加一次
Integer.intValue()。元素上只要有一次字符串拼接或者 map 查找,这部分就淹没了。
需要管的情况
- 短集合 × 高频遍历。 8 元素集合遍历一亿次,逃逸版本一轮丢掉 400 MB 垃圾,for-each 版本是 0。
- 迭代器被存起来或者传出去。 存进字段、装进集合、作为回调参数传进不可内联的方法、塞进 lambda、交给别的线程,任何一种都会把它钉在堆上。调 JVM 参数救不回来,只能改写法。
- 冷启动路径。 一个只在启动时跑几十毫秒的遍历逻辑,可能从头到尾都在 C1 甚至解释器里。这种代码的分配量按 C1 的规则算:每一轮都分配。
- 跨线程传递。 跨线程交给别人遍历时,每元素 670 ns(JDK 25),把线程里的遍历换成数组下标求和的对照组是 865 ns。两者差值落在噪声里,这一层该省的是线程。
自己写迭代器时,这笔账一样算
业务代码里手写 Iterator 的地方多在分页游标上:一次拿一批,取完再拉下一页。这类迭代器自带状态(游标、当前批次、连接或语句句柄),按上面的判据落位:
- 方法把迭代器交给调用方,比如
Iterable<Row> rows(),它必然逃逸,每次遍历一次分配。32 字节跟它持有的资源比起来不算什么,优化方向在别处。 - 迭代器只在本方法里消费,比如
for (Row r : page),它有机会被标量替换。能不能成功,看它的字段数量和构造过程:ArrayList.Itr能被拆掉,靠的是三个 int 加一个外层引用,拆完就是一串局部变量。
拿不准就用同一套办法量:把这段遍历跑几百万轮,前后各读一次 getThreadAllocatedBytes,差值为 0 就是被消掉了。这比读汇编便宜得多。
一条判断顺序
    flowchart TD
    S["一次遍历要不要为迭代器分配操心"] --> A{"集合长度有多长"}
    A -->|"长:遍历成本远大于 32 字节"| Z["不用管"]
    A -->|"短,且这段代码在热点路径上"| B{"迭代器会逃逸吗"}
    B -->|"不会:for-each 或方法内局部变量"| C{"这段代码进 C2 了吗"}
    B -->|"会:字段、回调、跨线程"| D["每次遍历一次分配,改写法才是出路"]
    C -->|"进了:稳定 0 字节"| E["不用管"]
    C -->|"没进:还在 C1 或解释器"| F["每次遍历 32 字节,按 C1 的规则算"]
总结
ArrayList.iterator()的实现是return new Itr();(JDK 25ArrayList.java:1029),1250 万轮遍历、1 亿次元素访问的实测分配是 0 字节,5 轮全 0。- 逃逸之后每轮固定 400,000,000 字节(4.00 字节/元素):
Itr是非静态内部类,12 字节对象头 + 3 个 int +this$0引用,补齐到 32。探针实测 32.0 字节,两个 JDK 一致。 - 同一份字节码加
-XX:-EliminateAllocations,for-each 从 0 变成每轮 400,000,000 字节,耗时从 0.66 涨到 0.95 ns/元素(JDK 25)。 -XX:TieredStopAtLevel=1(只有 C1)跑同一段循环,每轮 400 MB、4.96 ns/元素,30 轮测量无例外;-XX:-TieredCompilation(只有 C2)是 0 字节、0.66 ns/元素。C1 不做逃逸分析。- 默认分层编译下会出现两种状态:C1 版本每轮 400 MB / 229 ms,C2 版本 0 / 66 ms,切换点由编译进度决定。16 次最小程序运行里有 5 次拍到前 3 轮是 C1 版本。
- 独立 JVM 重复运行:for-each 在 JDK 21 上 8 次里 2 次、JDK 25 上 8 次里 3 次没有消除;逃逸用法 16 次全部 400 MB,一次例外都没有。
- 传参的边界在内联上:
drain可内联时分配 0 字节,-XX:CompileCommand=dontinline之后变成每轮 400,000,000 字节。 List.of用另一份实现(ImmutableCollections.ListItr),C2 上 for-each 同样是 0,逃逸时同样每轮 400 MB。判定依据是逃不逃逸,跟类无关。- 捕获一个引用的 lambda 是 16 字节,不捕获的由
invokedynamic缓存、0 字节;capture那一列每轮 48 字节/遍历 = 迭代器 32 + lambda 16。 - 集合长度到 262144 时每元素摊到 0.00012 字节,两种写法的耗时差 3.0%,这个尺寸上不必优化。
- 逃逸版本一轮 1 亿次元素访问触发 6 次 G1 young GC,for-each 版本 0 次。
-XX:+PrintEliminateAllocations属于 develop 选项,product 版 JVM 直接拒绝启动;判断有没有发生标量替换,用分配字节计数加编译层级对照。
参考资料
- ArrayList (Java SE 25)
- Iterator (Java SE 25)
- Iterable (Java SE 25)
- List (Java SE 25)
- Spliterators (Java SE 25)
- Collections (Java SE 25)
- ThreadMXBean.getThreadAllocatedBytes
- JEP 401: Value Classes and Objects (Preview)
- JEP 169: Value Objects(已撤回)
系列索引:设计模式系列