设计模式——访问者:类型与操作的矩阵
访问者模式的经典卖点是「加操作容易、加类型难」:操作轴加一个类,类型轴改遍所有操作。
sealed interface 与模式匹配之后,这笔账要重算:switch 也有穷尽性检查,加类型时编译器同样点名。
4 类型 × 4 操作的矩阵两种写法都写一遍,量耗时、量两个扩展方向的真实 diff,再看 JDK 24+ 的 ClassFile API 为什么选了访问者这一侧。
一、问题出在哪
访问者的机制是双分派。第一次分派给节点,第二次分派给操作:
1 | // 节点侧 |
    sequenceDiagram
    participant C as 调用方
    participant N as Add 节点
    participant V as EvalVisitor
    C->>N: accept(v)
    N->>V: visitAdd(this)
    V->>N: left() / right()
    N->>V: 子节点继续 accept,回到第一步
    V-->>C: 归约出的结果
第二次分派把「这是个 Add」和「现在在做求值」拼在一起,操作的实现就从节点里挪进了访问者。代价同时落到类型侧:ExprVisitor 每多一个方法,所有实现类一起编译失败。
另一条路是 sealed interface + 模式匹配,JDK 21 起可以用穷尽 switch:
1 | public static int eval(Expr expr) { |
加一个类型,每个 switch 都会因为「不覆盖全部可能输入」编译失败。
经典论断的两半都松动了。「加操作容易」这半,两种写法都是新增一个文件,谁都碰不到现有代码;「加类型难」这半,两边编译器指向同一批操作文件。这个场景有个更老的名字,expression problem,问的是「能不能在不改现有代码的前提下同时扩展类型和操作」,答案是两边都躲不开改现有代码,区别只在改动落在哪一侧。
代码量上有一处稳定的差别。同一个矩阵的基线:
| 基线 | 文件数 | 总行数 | 节点侧 | 操作侧 |
|---|---|---|---|---|
| 访问者 | 10 | 158 | 40(4 个 record 各 8 行,含 accept) |
113(4 个访问者类) |
| sealed + switch | 9 | 96 | 20(4 个 record 各 4 行) | 76(4 个静态方法类) |
访问者版本多出 62 行,多在一个 accept 方法和四个访问者类的骨架。这个差距与矩阵大小无关,是一次性的入场费。
要看出差别,得分开看三件事:运行期代价、两条轴扩展时的改动规模、编译器与运行期各自能替你抓到什么。
二、实验设计
矩阵的两条轴:
| 轴 | 取值 | 说明 |
|---|---|---|
| 类型 | Num、Add、Mul、Neg |
表达式节点,构成一棵 41 节点、深度 7 的树 |
| 操作 | eval、size |
求值、节点数 |
| 操作 | depth、print |
深度、中缀打印(追进 StringBuilder 再产出 String) |
三个操作返回数值,一个产出字符串,形状刻意拉开:求值只做算术,深度只做比较,打印要分配。操作形状会不会影响两种写法的差距,是这个矩阵要先回答的问题。
两种写法的代码在 /tmp/Visitor/ 下,包结构一致:expr.Expr 是 sealed 接口,四个 record 节点;访问者版每个节点实现 accept,操作是实现 ExprVisitor<R> 的类;switch 版节点只有数据,操作是含穷尽 switch 的静态方法类。两边都不缓存中间结果,每次遍历完整走树。
访问者侧的接口保持泛型原样(ExprVisitor<Integer>、ExprVisitor<Void>),没有做 int 特化。这个取舍会在字节码和耗时里看到后果,两处都会给出对照。
测量口径:
- 机器 Apple M1 Pro,macOS Darwin 25.6.0,单线程
- JDK 21.0.8+12-LTS-250 与 JDK 25+37-LTS-3491,都是 arm64
- 计时前先预热 100 万次,再计时 5 轮,每轮 200 万次遍历,取最快一轮
- 树构造了 16 棵,循环里按
i & 15轮换。单棵树会让整个循环体成为循环不变量,JIT 有理由把它提到循环外,量到的就不是遍历 - 计时期间持全局文件锁,避免同机其他进程干扰
- 没有 JMH。这是单机微基准,结论只取量级
全部耗时来自同一次测量会话,横向可比。绝对值不要跨文章比:树的形状、操作里做的事、预热口径都会改数字,本矩阵内 print 和 eval 就差 8 倍。
eval、size、depth 复用同一个无状态访问者实例,print 每次遍历新建一个访问者,因为它要持有 StringBuilder。打印操作的形态决定了它必须带状态,两种写法都得这样写。
没覆盖的东西一并列出:没有 JMH 的 Blackhole,靠 volatile 写把结果留住;没有多线程竞争场景;没有测深递归到栈溢出的边界;没有测节点数超过 JIT 内联预算之后的形态。树只有 41 个节点,单趟耗时的绝对值小,看相对差时把注意力放在同一行内的两列,不要跨行比。每节点成本可以自己除:把某一行除以 41 就是每个节点的平均代价。
三、实测一:矩阵的运行期代价
41 节点树的单趟遍历,单位纳秒:
| 操作 | JDK 21 访问者 | JDK 21 switch | JDK 25 访问者 | JDK 25 switch |
|---|---|---|---|---|
| eval | 26.1 | 115.8 | 26.4 | 117.3 |
| size | 38.5 | 116.9 | 46.1 | 117.9 |
| depth | 25.9 | 121.4 | 25.6 | 91.5 |
| 209.0 | 293.9 | 196.6 | 223.5 | |
| 四项合计 | 329.9 | 631.7 | 323.0 | 543.3 |
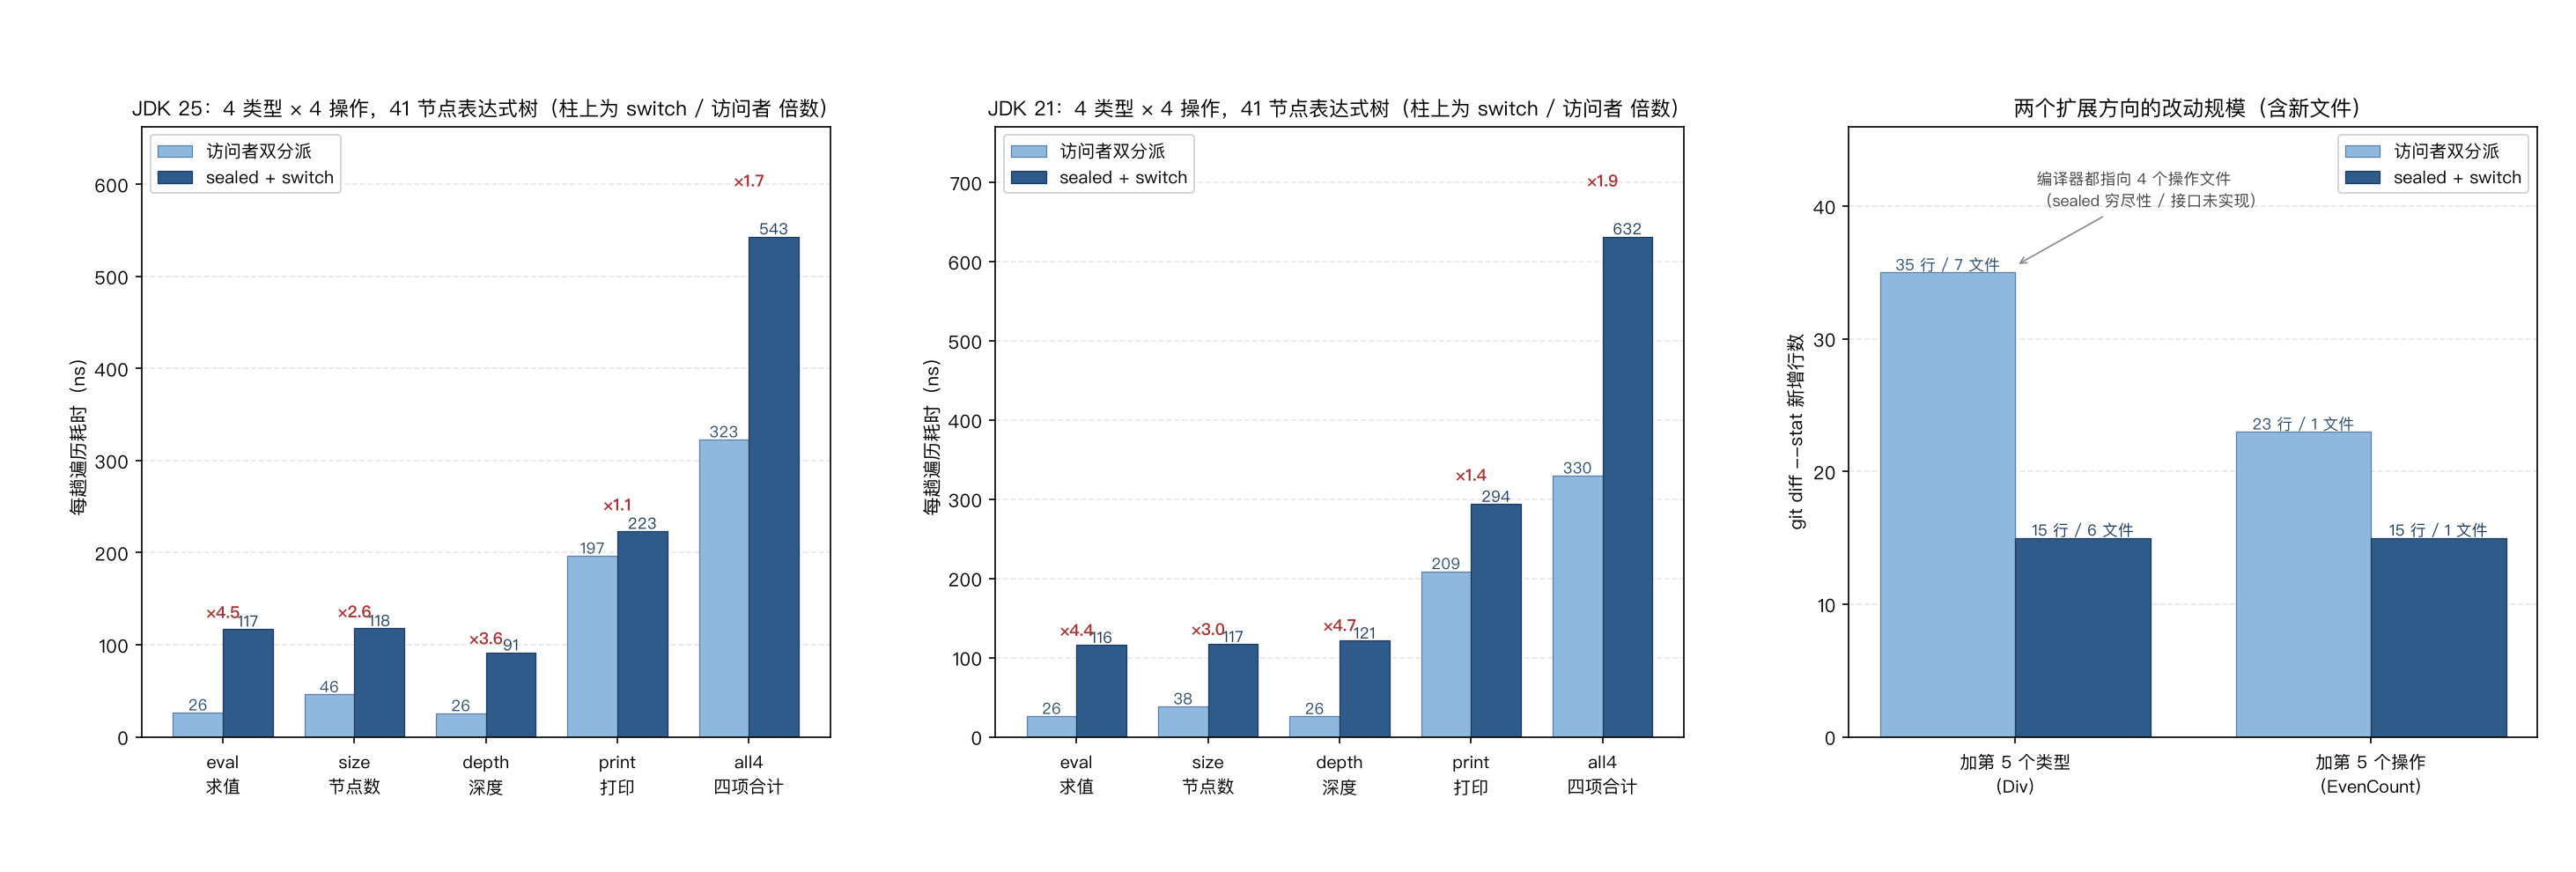
两代 JDK 上排序一致,这棵 41 节点的树上四种操作都是访问者更快。
print 每趟 209.0ns(JDK 21 访问者),是 eval 的 8 倍,绝对值由操作形状决定。它每个节点都要往 StringBuilder 里 append,遍历收尾还要 toString() 一次,分配与拷贝吃掉了大部分时间。size 只做整数加法,比 eval 慢一点;depth 用 Math.max,和 eval 同量级。矩阵里最贵的是每个节点上操作自己做的事。
switch 的倍数按操作收缩。 JDK 21 上 eval 是 4.4 倍,depth 4.7 倍,print 只有 1.4 倍,四项合计 1.9 倍。JDK 25 上 depth 从 4.7 倍降到 3.6 倍,print 从 1.4 倍降到 1.1 倍,eval 与 size 基本不动。两个 JDK 的 switch 实现不同,它换掉了每个节点的分派形态,但收益为什么只落在 depth 与 print 上,没有进一步定位。
四项相加与 all4 那一行大体相等:JDK 21 访问者 26.1 + 38.5 + 25.9 + 209.0 = 299.5,实测 all4 是 329.9;switch 侧 115.8 + 116.9 + 121.4 + 293.9 = 648.0,实测 631.7。四次独立遍历没有出现互相抵消,访问者侧的 +10% 与 switch 侧的 −2.5% 方向相反,落在本次抖动与 JIT 布局变化之内。
访问者的单节点成本是 26.1 / 41 = 0.64ns,低于一次未内联的接口调用。41 个节点、深度 7 的树让 C2 有机会把 accept 与 visitXxx 的调用链内联掉大半;换一棵 8 倍大的树能验证这个数字是不是小树的假象。
换一棵 339 节点的深树
把树深从 6 加到 10(339 节点、深度 11),写法和口径不变,只改树的规模:
| 操作 | JDK 21 访问者 | JDK 21 switch | JDK 25 访问者 | JDK 25 switch |
|---|---|---|---|---|
| eval | 232.5 | 700.0 | 230.1 | 755.5 |
| size | 231.4 | 701.7 | 221.3 | 749.5 |
| depth | 224.8 | 981.8 | 219.1 | 757.8 |
| 1713.4 | 1683.3 | 1656.9 | 1512.7 | |
| 四项合计 | 2414.1 | 4063.7 | 2337.6 | 3778.0 |
单节点成本在两个规模上都稳定。访问者的 eval 在 41 节点树上是 26.1ns,除以 41 是 0.64ns/节点;在 339 节点树上是 232.5ns,除以 339 是 0.69ns/节点。switch 侧同样稳定,2.8ns/节点降到 2.1ns/节点,两代 JDK 一致。两边都近似线性,差的 1.5ns/节点可以当成这两种分派方式在本题里的固定价差。
操作自身的成本摊薄了分派差。 print 在深树上反转:JDK 21 是 switch 快一点(1683.3 对 1713.4),JDK 25 是 switch 快 9%(1512.7 对 1656.9)。打印每个节点要 append、收尾要 toString(),固定成本约 4.4ns/节点,1.5ns 的价差摊到 1.02 倍;访问者版每次遍历还要多建一个访问者对象(它持有 StringBuilder),switch 版只需要一个 StringBuilder。操作越重,分派风格越不重要,最后比的是谁少分配一个对象。
int 特化在深树上的收益更稳:JDK 25 上三个操作都快了,eval 从 230.1ns 到 182.8ns,size 从 221.3ns 到 156.2ns,depth 从 219.1ns 到 156.1ns,快 20% 到 29%。浅树上 size 的倒退没有复现。
字节码里是什么
访问者的递归调用点,javap -c -p expr.EvalVisitor(JDK 25 编译产物):
1 | 5: invokeinterface #25, 2 // InterfaceMethod expr/Expr.accept:(Lexpr/ExprVisitor;)Ljava/lang/Object; |
每个节点一次接口调用,加上 checkcast 与拆装箱。泛型接口的返回值是 R,擦除后是 Object,这条路绕不开。
switch 侧的同一个递归点:
1 | 2: invokestatic #7 // Method java/util/Objects.requireNonNull:(Ljava/lang/Object;)Ljava/lang/Object; |
每个节点一次 invokedynamic 加上按序号跳转的 tableswitch。
泛型接口的账单:int 特化的对照
把接口从 ExprVisitor<Integer> 换成 IntVisitor(int visitNum(Num) 这种),同样四个类型各加一个 int acceptInt(IntVisitor),字节码就变干净了:
1 | public int visitAdd(expr.Add); |
checkcast、intValue、valueOf 全部消失。三个数值操作的耗时对照(同一把锁、同一次会话):
| 操作 | JDK 21 泛型访问者 | JDK 21 int 特化 | JDK 25 泛型访问者 | JDK 25 int 特化 |
|---|---|---|---|---|
| eval | 26.1 | 22.8 | 26.4 | 23.5 |
| size | 38.5 | 48.0 | 46.1 | 70.0 |
| depth | 25.9 | 21.2 | 25.6 | 22.1 |
三个数值操作里,int 特化在浅树上有两个变快、一个变慢:
- eval:JDK 21 从 26.1ns 到 22.8ns,JDK 25 从 26.4ns 到 23.5ns,快 10% 到 13%
- depth:JDK 21 从 25.9ns 到 21.2ns,JDK 25 从 25.6ns 到 22.1ns,快 14% 到 18%
- size:JDK 21 从 38.5ns 到 48.0ns,JDK 25 从 46.1ns 到 70.0ns,慢了 25% 到 52%
size 的倒退在两代 JDK 上同时出现,看着像系统性代价。换到 339 节点的深树就不见了:JDK 21 是 227.2ns 对 231.4ns,JDK 25 是 156.2ns 对 221.3ns,后者还快了 29%。内联日志里,int 版本把 Num::acceptInt 内联进 Add::acceptInt 时出现 failed to inline: already compiled into a big method,这类拒绝在泛型版本里没有;方法形状一换,内联预算的分配就变,浅树上的 25% 更可能是这种布局偶然,而不是拆装箱的真实代价。
字节码的账单是确定的:省掉一条 checkcast、一次 intValue、一次 valueOf。省下来的时间不稳定,深树与浅树给出的答案都不一样。把接口 int 特化当性能开关之前,先拿真实负载量一遍。
两个 JDK 的 switch 不是同一套东西
同一次运行里加 -XX:+UnlockDiagnosticVMOptions -XX:+PrintInlining、-XX:+PrintCompilation 和 -Xlog:class+load=debug,两边差别明确:
- JDK 25:每个 switch 生成一个隐藏类,
expr.Eval$$TypeSwitch/0x…::typeSwitch (82 bytes),-XX:+PrintCompilation里编到了 4 层,内联日志里是inline (hot) - JDK 21:同一个程序、同一组日志开关,
TypeSwitch零条记录。JDK 21 的-Xlog:class+load=debug会输出Hid$$Lambda这类隐藏类,说明问题不在日志级别
源码对得上。JDK 21 的 java.base/java/lang/runtime/SwitchBootstraps.java:222 起是 createMethodHandleSwitch,用 MethodHandles.guardWithTest 串出判断链(:231),再 MethodHandles.tableSwitch(:235)收口。JDK 25 的同一个类 :732 起换了做法:
1 | byte[] classBytes = ClassFile.of(ClassFile.StackMapsOption.DROP_STACK_MAPS).build(ConstantUtils.binaryNameToDesc(typeSwitchClassName(caller.lookupClass())), |
(JDK 25 SwitchBootstraps.java:737-743。)生成的字节码再用 caller.defineHiddenClass(classBytes, true, NESTMATE, STRONG)(:749)挂进调用点。生出来的方法能被 C2 内联,替换掉了原先一串句柄。
内联日志里访问者侧的高频行是 expr.Expr::accept (0 bytes) failed to inline: no static binding,递归自调用则是 callee is too large。两种写法都没有把整趟遍历压成一个方法的余地,能优化的只是每节点的那次分派。
四、实测二:两个扩展方向的真实成本
扩展实验分两次:先加类型,再加操作,每次都用 git diff --stat 记录真实改动。
加第 5 个类型 Div:
| 写法 | 文件数 | 新增行 | 删除行 | 被改的文件 |
|---|---|---|---|---|
| 访问者 | 7 | 35 | 1 | Expr、ExprVisitor、Div(新)、EvalVisitor、SizeVisitor、DepthVisitor、PrintVisitor |
| switch | 6 | 15 | 1 | Expr、Div(新)、Eval、Size、Depth、Print |
加第 5 个操作 EvenCount(统计偶数值节点):
| 写法 | 文件数 | 新增行 | 被改的文件 |
|---|---|---|---|
| 访问者 | 1 | 23 | EvenCountVisitor(新) |
| switch | 1 | 15 | EvenCount(新) |
行数的差来自写法本身。访问者每加一个类型要补一整个方法(签名、方法体、缩进),switch 只加一条 case 标签,两边要写的逻辑一样多。单看两条轴,类型轴一步在访问者侧是 35 行 / 7 个文件,在 switch 侧是 15 行 / 6 个文件;操作轴一步两边都是 1 个新文件,23 行对 15 行。
两条轴一起长
真实重构里更常见的场面是新语法配新分析,Div 与 EvenCount 一起加。两个变体第一次编译都失败:
1 | $ javac ... # 访问者 |
新操作必须先覆盖新类型,两种写法都拦得住,没有谁能漏掉。补全之后再统计:
| 写法 | 文件数 | 新增行 | 矩阵从 4×4 长到 5×5 后的基线 |
|---|---|---|---|
| 访问者 | 8 | 63 | 12 文件 / 221 行 |
| switch | 7 | 31 | 11 文件 / 127 行 |
两条轴同时长的成本接近两笔单步之和:访问者 35 + 23 = 58 行,实测 63 行;switch 15 + 15 = 30 行,实测 31 行。多出来的几行是新操作必须立刻覆盖新类型,访问者侧是 visitDiv 方法,switch 侧是 Div 分支。没有「一起改更便宜」的窗口。
只改类型和接口、故意不修操作类,让编译器报错:
1 | $ javac -J-Duser.language=en ... # 访问者:Expr 加 permits,ExprVisitor 加 visitDiv |
switch 侧的多文件批编译只报 1 条就中止。把四个操作文件逐个单独编译,四条错误各归其位:Eval.java:8、Size.java:8、Depth.java:8 是 switch expression does not cover all possible input values,Print.java:8 用的是语句形式的 switch,措辞是 switch statement。责任文件同样是 4 个。
测量口径:javac 遇到穷尽性错误会提前中止,多文件批编译数不出责任文件的数量。 要么逐文件编译,要么看 IDE 的编译日志。
两条轴的编译期保护都是可关的
访问者侧的「编译器点名」来自 ExprVisitor 的抽象方法。给新方法加个 default 实现就能关掉:
1 | default R visitDiv(Div div) { |
同样的实验,编译结果 0 错误,通过。加了 Div 而没修任何操作类,四个访问者都能编出来,漏掉的那个方法只在运行期、只在数据里真的出现 Div 时抛异常。
switch 侧的开关是 default 分支,同理。两种写法都能把编译期保护降级成运行期异常,区别在默认状态:抽象方法默认打开保护,switch 只有配了 sealed 才有穷尽性检查。
类型集封闭不了的时候,差别才出现
把 Expr 从 sealed 改成普通接口,switch 需要 default 兜底,访问者的 ExprVisitor 仍是抽象方法。同样只加 Div、不修操作类:
- 访问者:仍然 4 个编译错误,
EvalVisitor、SizeVisitor、DepthVisitor、PrintVisitor一个不落 - switch:编译通过,0 错误
switch 版本运行起来是这样:
1 | $ java -cp out expr.OpenDemo |
default 分支把「漏了一个类型」从编译期推到运行期,而且只在数据里真的出现 Div 时才炸。插件式层级里,第三方给你带来第五个类型时,你的 switch 连提醒都不会有。
类型集封闭时,两边都是编译器驱动的修改;类型集开放时,访问者靠接口方法把更新逼出来,switch 靠 default 把问题藏起来。 类型集封闭与否,看的是这个层级会不会被外部实现,跟此刻有几种类型无关。
    flowchart LR
    T["类型轴 +1<br/>新增 Div"] --> TV["访问者:ExprVisitor 加方法<br/>4 个操作类编译失败<br/>7 文件 / 35 行"]
    T --> TS["sealed + switch:4 个 switch<br/>穷尽性编译失败<br/>6 文件 / 15 行"]
    T -.-> T2["若接口无法 sealed:<br/>switch 编译通过,运行期抛异常"]
    O["操作轴 +1<br/>新增 EvenCount"] --> OV["访问者:1 个新类<br/>23 行,零改动"]
    O --> OS["switch:1 个新类<br/>15 行,零改动"]
五、矩阵里还有第三种写法
两种写法之外,矩阵还能这么摆:一个访问者遍历一次,把四个操作全算出来。
1 | public final class AllOpsVisitor implements ExprVisitor<Void> { |
它把操作轴的四个格子压进一次遍历。访问者天然支持这种融合:accept 是框架调进来的,一个节点上想累计多少个量都行。switch 侧要融合,得把四个 switch 合并成一个巨型 switch,每个 case 里干四件事,四段逻辑长在一起。
融合省下的是分派账单,操作本身的计算照付,可以按前面的数字估个上限。深树上 339 个节点 × 0.69ns ≈ 234ns 是访问者一次遍历的逐节点分派成本;四个操作各跑一遍要付四遍(约 936ns),融合之后只付一遍,省下的上限在 700ns 上下,对 2414ns 的合计来说是 30% 左右。这正好解释了 all4 与四项之和为什么几乎相等:没有融合时,四次遍历的分派一分钱也省不掉。
六、JDK 源码里的同类选择
JDK 24 起 java.lang.classfile 提供 Class-File API,它的对象模型把两条轴分得很清楚。
类型轴是封闭的。java.base/java/lang/classfile/ClassFileElement.java:60 是 public sealed interface ClassFileElement;CompoundElement.java:63-66:
1 | public sealed interface CompoundElement<E extends ClassFileElement> |
ClassModel.java:65 起是 public sealed interface ClassModel extends CompoundElement<ClassElement>, AttributedElement。JVMS 的语法不会因为你的工具多出第 5 种成员。
操作轴是开放的,而且刻意做成了访问者形态。ClassFileTransform.java:105:
1 | public sealed interface ClassFileTransform< |
四个子类型对应类、字段、方法、方法体四种粒度的操作。用户侧的扩展点是一个 accept(:119):
1 | void accept(B builder, E element); |
注释写得很直白(:113-114):
1 | * This method is called by the Class-File API. Users should never call |
框架控制调用方向。jdk.internal.classfile.impl.TransformImpl.java:51 是框架侧的调度:
1 | return new ResolvedTransform<>(e -> transform.accept(builder, e), |
API 负责遍历,元素逐个送进来。CompoundElement.forEach(CompoundElement.java:73)是元素侧的入口。
访问者形态在这里有实际用处,原因在 ClassFileTransform 的另外两个方法,atEnd(:132)与 atStart(:146):
1 | default void atEnd(B builder) { |
一个 transform 可以在遍历开始前做准备、结束后做清理,可以在处理成员时累计状态,还可以用 andThen(:160)把两个 transform 串成流水线。状态化的用法在文档里专门写了一节(:64-72):
1 | * Transforms can have states that persist across processing of individual |
这些位置在静态 switch 函数里没有对应的语法:一个纯函数拿不到「遍历开始 / 结束」这两个时刻,也存不住跨元素的状态。
ClassFile 接口上的操作可以数出来:parse(byte[])(ClassFile.java:524)、build(...)(:555)、verify(ClassModel)(:758)、transformClass(...)(:692、:717、:749)。解析、生成、校验、改写四个操作,落在一个封闭的类型层级上。
用矩阵的眼光看,这个选型说得通:类型轴由 JVMS 定死,操作轴由无数工具(脱糖、注入、校验、插桩)共享,每个操作都要求「逐个处理成员元素」的遍历节奏,还带生命周期钩子与组合需求。矩阵的形状决定了它长成访问者。
JDK 25 自己的模式匹配就用这套 API 生成字节码(SwitchBootstraps.java:737)。封闭的类型层级加开放的操作轴,JDK 自己就是这么用的。
七、什么时候用,什么时候不用
访问者值得写的条件,满足两条以上:
- 类型层级封闭,或者改动类型集需要一轮自知的版本决定
- 操作数量在长,而且要跨团队分发(分析器、导出器、校验器各写各的)
- 操作有状态、有生命周期(开始 / 结束钩子),或者需要互相组合
- 需要框架控制遍历顺序,用户代码只关心「遇到某个节点做什么」
该放弃访问者的信号:
- 类型集还在长。每加一个节点就要改 7 个文件、补 35 行,这笔成本会一直付下去
- 层级来自别人,你只能写
instanceof链或default兜底。这种情况下 sealed 加穷尽 switch 没有编译期保护,别指望模式匹配帮你 - 操作都是一次性的、几行的函数。JDK 21 起 switch 表达式的语法密度低于访问者里的四个方法声明,读起来更短
- 返回原始类型而且对热点敏感。泛型访问者每个节点带一次
checkcast与拆装箱,字节码已经写明了;要么把接口 int 特化,要么直接用 switch
判断顺序,从便宜到贵:
- 这个类型集能不能 sealed?不能的话,先想清楚「谁来保证新类型被处理」,再谈模式选择
- 两条轴谁先长?操作先长选访问者,类型先长选穷尽 switch
- 操作需要状态、钩子、组合吗?需要就只剩访问者
- 最后谈性能。矩阵上的差距在量级之内,别拿它当架构决策的依据
局部状态与遍历控制
两种写法还有一个形状差异,落在能写出什么样的控制流上。
switch 版的每个操作是一个完整的函数,可以在里面平铺任意逻辑:用显式栈改成迭代遍历、按深度跳过整棵子树、把中间结果放进局部变量传给兄弟调用。访问者版的每个方法只看到自己那一个节点,任何跨节点的状态都得挂到访问者对象上;accept 的调用方向由节点决定,留给自己的遍历顺序空间很小。
代价在这次实验里露过面:PrintVisitor 必须持有一个 StringBuilder 字段,每次遍历新建一个访问者;如果某个操作需要「进入节点」和「离开节点」两个时机,访问者得在同一个方法里前后各写一段,或者另起一套回调协议。switch 版里这些就是普通的代码顺序。
三种把访问者写废的形态
只写 accept,不写 visitor 接口。 每个节点一个 accept(Op op),Op 里再用 instanceof 分支。双分派退化成了单分派加类型判断,多了一层壳,少了一次编译期检查。
接口写了一堆,实现只覆盖一个类型。 四个访问者方法里三个是 throw new UnsupportedOperationException()。这时矩阵只有一列,接口的形状是假的,编译器点名反而成了噪音。
在 visitXxx 里再判断子类型。 visitAdd(Add add) 内部又去 add.left() instanceof Num 走另一条路。这种情况通常说明方法该拆得更细,或者矩阵的类型轴设计有问题。
八、复现
源码、编译脚本与原始输出都在 /tmp/Visitor/:
1 | visitor/src/expr/ 访问者版基线(10 个文件 158 行) |
运行环境是 JDK 21.0.8 与 25+37 LTS,java_home -v 切换。计时命令形如:
1 | java -cp out-25/visitor bench.VisitorBench 1000000 2000000 5 |
三个参数是预热次数、计时次数、轮数。
九、总结
基线规模。 4 类型 × 4 操作的两种写法:访问者 10 个文件 158 行,sealed + switch 9 个文件 96 行。
运行期。 访问者的每节点成本 0.64ns(41 节点树)与 0.69ns(339 节点树),switch 对应 2.8ns 与 2.1ns。两者都近似线性,价差固定在 1.5ns/节点上下。操作越重,这个价差摊得越薄;JDK 25 的深树上 print 反而是 switch 略快(1512.7 对 1656.9),因为访问者版每次遍历要多带一个访问者对象。
扩展。 加类型:访问者 7 文件 35 行,switch 6 文件 15 行;加操作:两边都是 1 个新文件,23 行对 15 行;两条轴同时长:8 文件 63 行对 7 文件 31 行。成本基本相加,没有合算的窗口。
编译器。 sealed 层级下两种写法都在编译期点名(各 4 个操作文件)。层级不能 sealed 时,只有访问者还点名(仍 4 个错误),switch 编译通过、在运行期抛 IllegalStateException。这条差别与类型集封闭与否绑定,跟写法本身的优雅程度无关。
JDK 版本。 两个 LTS 的模式匹配实现换了一代:JDK 21 用 MethodHandles.guardWithTest 串判断链,JDK 25 用 Class-File API 生成隐藏类里的 typeSwitch 方法并内联。落到耗时上,JDK 25 的 depth 快 25%(121.4 到 91.5)、print 快 24%(293.9 到 223.5),eval 与 size 没动。同一份 sealed + switch 代码,跨 LTS 的性能特征会变。
判据还是前面那几句:先问类型集能不能封闭,再问两条轴谁先长,最后才轮到性能。同系列里策略模式换的是算法(策略:换算法),命令模式把调用变成对象(命令:把调用变成对象),访问者动的是类型分发的归属。
最要紧的一条:矩阵的形状决定写法,写法的性能差别是 1.5ns/节点这个量级的事。 类型轴封闭、操作轴会长,访问者;类型轴会长、能 sealed,穷尽 switch;两条都不确定,先把类型集封起来再选。
参考资料
- Gamma 等,《设计模式:可复用面向对象软件的基础》,Visitor 章
- JEP 441: Pattern Matching for switch,JDK 21
- JEP 484: Class-File API,JDK 24
- JDK 25
src.zip:java.base/java/lang/classfile/ClassFileTransform.java、ClassModel.java、CompoundElement.java、ClassFile.java、java.base/jdk/internal/classfile/impl/TransformImpl.java、java.base/java/lang/runtime/SwitchBootstraps.java - JDK 21
src.zip:java.base/java/lang/runtime/SwitchBootstraps.java - 测量源码与原始输出:
/tmp/Visitor/,日志/tmp/pattern-runs/Visitor.log
系列索引:设计模式系列