设计模式——适配器:边界在哪
适配器只做一件事:把调用方要的接口翻译成现有对象提供的接口,不改变被包装对象的行为。
常见的反对意见是「多一层调用会拖慢热点路径」。JIT 打开、调用点单态时,这层开销量出来是零;调用点收到多个实现类型时,量出约三倍。
两种情况本文都用 1 亿次调用测一遍,并贴出-XX:+PrintInlining对每一次内联决定的原文。
一、问题:那一层调用值多少钱
手里有一个只能按字节取的类,调用方要的是一个按字符取的接口,中间补一个类:
1 | interface CharReader { int read(); } // 调用方要求的接口 |
这段代码产生的新东西只有两样:一个持有 ByteSource 引用的对象,以及 read() 到 next() 之间的一次转发。decode 的逻辑与适配器无关,不装适配器也要执行。
把这段代码放进热点循环,争议就集中到那次转发上。一种说法是多一层调用是常数开销,可以忽略;另一种说法是热点路径上的额外虚调用会被放大成可观的延迟。两种说法都有人支持:结论取决于 JIT 对那个调用点做了什么,与适配器的写法无关。
两种说法在 JDK 内部都有例子。Arrays#asList 包装数组,Collections#unmodifiableList 包装列表,这两层在集合代码里用得很密,很少有人为它们的开销担心。反面情形出现在同一段代码处理多种来源时:一个 Reader 变量在循环里轮流指向 InputStreamReader 与 StringReader,调用点上的类型数一多,JIT 的类型 profile 溢出,read() 退化成真实分发。
本文用一个合成负载把这件事拆开。同一份逻辑工作,四种调用形态,各 1 亿次调用,两个 JDK 各跑一遍。结论分两层:适配器那层转发在内联之后量不出来;能测出来的成本来自调用点上实现的种类数,与适配器对象无关。前者决定要不要为性能改设计,后者决定该往哪里改。
    classDiagram
    direction LR
    class ByteSource {
        -byte[] buf
        -int pos
        +int next()
    }
    class CharReader {
        <<interface>>
        +int read()
    }
    class SourceAdapter {
        -ByteSource src
        +int read()
    }
    class Caller {
        +long run(CharReader r, int n)
    }
    CharReader <|.. SourceAdapter
    SourceAdapter --> ByteSource : 每次 read() 转发一次 next()
    Caller --> CharReader : 只认识新接口
图里 Caller 只认识 CharReader,适配器把 ByteSource 的字节接口挡在后面。适配器带来的全部新东西就是中间那个对象和它上面的一次转发。
与相邻模式的分界,先划一次
这三个模式在代码上长得很像,差别在动机:
| 模式 | 对被包装对象做什么 | 触发条件 |
|---|---|---|
| 适配器 | 换接口,不改行为、不加语义 | 调用方要的类型和现有类型对不上 |
| 装饰器 | 不改接口,在调用前后加行为 | 缓冲、计数、校验这类横切能力 |
| 桥接 | 拆开两个各自独立变化的维度 | 形状与颜色、平台与控件各自扩展 |
适配器接收一个接口不匹配的对象,输出一个接口匹配的对象,中间不做别的事;装饰器进出是同一个接口,中间做别的事。桥接不翻译已有对象,它承认两个维度都要扩展,把继承关系换成组合。
本文要划的边界有三条:与相邻模式的分界、性能上量得出来与量不出来的分界、以及什么时候不该写适配器。
二、实验设计
四种调用形态共用同一份逻辑:从 64 KiB 的字节缓冲取下一个字节,做一次固定的字节到字符转换,累加结果。
| 组 | 调用形态 | 调用点看到的实现类型数 |
|---|---|---|
| A | 不用新接口,调用处直接 decode(src.next()) |
不含接口调用 |
| B | 经 CharReader 接口调用 read(),实例是 SourceAdapter |
1 |
| C | 与 B 相同的循环体,实例在 8 个实现类之间轮换 | 8 |
| D | 旧类 ByteSource 自己 implements CharReader,没有适配器对象 |
1 |
四个调用点的代码(转载自 /tmp/Adapter/AdapterBench.java):
1 | static long direct(ByteSource s, int n) { // A |
循环体逐字相同,必须分布在三个方法里。 B、C、D 的循环体都是 for (int i = 0; i < n; i++) t += r.read();。HotSpot 的类型 profile 挂在调用点上,三个形态共用一个方法会互相污染,所以它们各自是一个方法。D 与 B 的差别只有一个:传给 D 的参数对象就是 ByteSource 本身,中间没有适配器。
C 组用 8 个实现类,机器码完全相同。 8 个类的 read() 都是 return decode(s.next());,字节码逐字节一致(编译日志里都写着 11 bytes)。真实进程里 java.io.Reader 类型的变量会接收 InputStreamReader、StringReader、FileReader、CharArrayReader 这些不同的实现,一个调用点看到多种类型是常态。把 8 个实现的工作量压成完全相同,是为了让 B 与 C 的耗时差只来自分发方式。
缓冲区取 64 KiB。 它常驻 L2,保证数组读取不是瓶颈,测出来的是调用本身的成本。缓冲区大小取 2 的幂,运行长度取其整数倍,源位置在每轮前后都停在起点。
计时流程。 每组先做 3 轮预热(丢弃),再做 7 轮测量。每轮 A/B/D 各 100,007,936 次调用,C 组 8 个实现合计 99,614,720 次。报中位数,同时给出 7 轮的最小值与最大值。预热之前还有一次「弄脏 profile」的阶段:C 组每个实现先各跑 196,608 次,让调用点先收集到 8 个类型,再进入正式测量。没有这一步,JIT 会先按单态编译 C 组,等新类型出现再去优化掉,量到的会是那次编译切换的成本。
校验和。 四条路径的结果必须完全相等。每轮运行长度取缓冲区长度的整数倍,源位置运行前后都停在起点,四组校验和可以逐位比对(日志里四行都是 checksum ok)。数值对不上的话,说明某个形态少算了,那一轮的数据作废。
锁。 计时期间持有 /tmp/pattern-bench.lock,把同一台机器上其它并发测量挡在外面。这台机器上同时有二十多个实验在跑,不串行化的话,相邻进程的一次编译就能污染整轮数据。
局限。 负载是合成的,decode 里只有 5 个整数位运算,它比真实的字符解码轻得多。真实解码更重时调用开销占比更小,本文的差值只会更小。测量在一台机器(Apple M1 Pro,10 个逻辑核,macOS 26.6.2)上完成,没有跨架构结论。内联决策是 HotSpot C2 的行为,换成其它 JVM 结论未必一致。
为什么不用 JMH。 本文的对照组是同一段循环的四种编译结果,需要控制的是类型 profile 与编译时机。手写骨架可以把「弄脏 profile 的阶段」显式放在测量之前,也能把四组校验和摆在同一份日志里对齐正确性。JMH 的多 fork 与随机化反而会把编译时机藏起来。折中做法是 3 轮预热加 7 轮测量取中位数,并公开每轮原始值供核对。
判据流程
分界问题在代码里落成一条判断顺序:
    flowchart TD
    S[调用方手里的类型<br/>与现有对象的类型] --> Q1{是同一个接口吗}
    Q1 -- 不是 --> Q2{差异来自两个维度<br/>各自独立变化吗}
    Q1 -- 是 --> Q3{要改变调用行为吗}
    Q2 -- 是 --> BR[桥接:拆成两个维度]
    Q2 -- 否 --> AD[适配器:只翻译接口]
    Q3 -- 是 --> DE[装饰器:同接口加行为]
    Q3 -- 否 --> PQ{要控制访问吗}
    PQ -- 是 --> PR[代理]
    PQ -- 否 --> NC[直接调用]
三、实测:JIT 打开时
| 组 | 调用形态 | JDK 21.0.8 中位数 (ns/次) | JDK 25 中位数 (ns/次) | 相对 A |
|---|---|---|---|---|
| A | 直接调用 | 0.96 | 0.96 | 1.00 |
| B | 一层适配 | 0.96 | 0.96 | 1.00× / 1.00× |
| C | 多实现(8 个类型) | 2.95 | 2.78 | 3.07× / 2.90× |
| D | 绕过包装 | 0.96 | 0.96 | 1.00× / 1.00× |
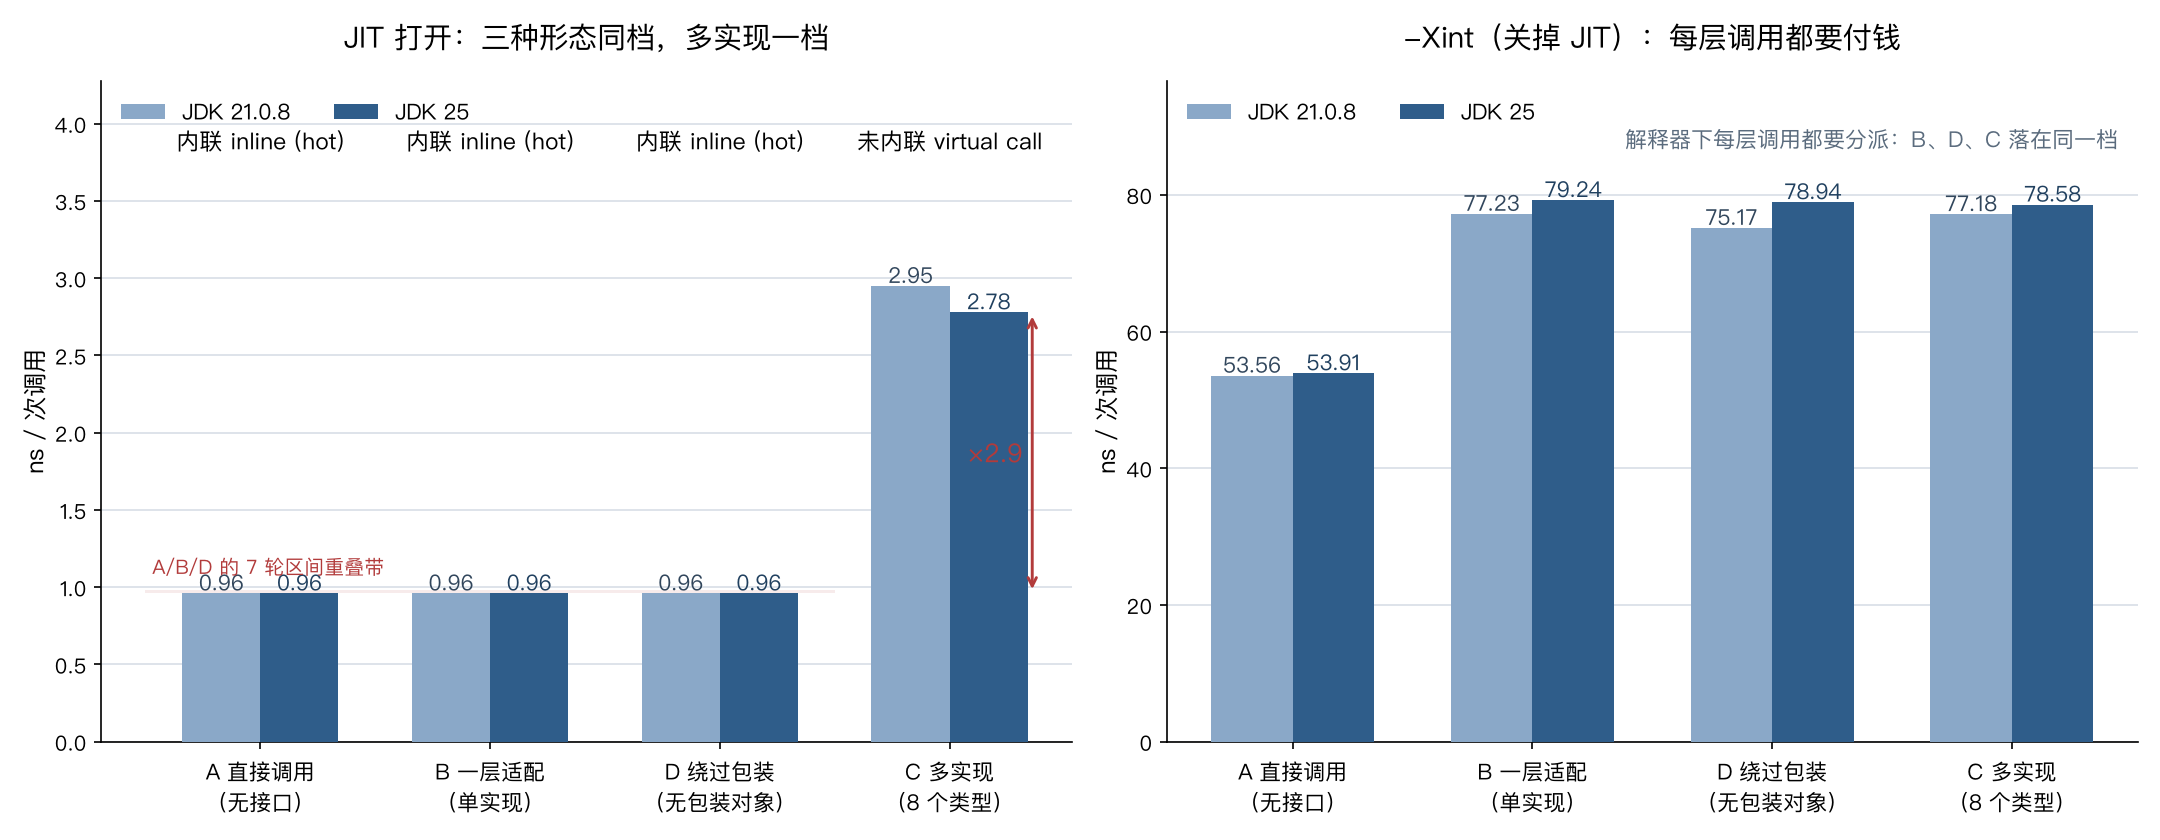
A、B、D 落在同一档。JDK 21 上三者的中位数是 0.96、0.96、0.96 ns/次,JDK 25 上是 0.96、0.96、0.96 ns/次。三者的逐轮波动都在 0.04 ns 以内,B 与 A 的轮次区间重叠:JDK 21 上 B 组的 7 轮最小值 0.96、最大值 1.00,A 组 0.96 到 0.97。这组数据里读不出「加一层适配器」的耗时。
C 行落在另一档:JDK 21 中位数 2.95 ns/次,JDK 25 2.78 ns/次,分别是 A 组的 3.07× 与 2.90×。C 组循环体与 B 组逐字相同,静态类型也相同,唯一差别是同一个调用点先后收到 8 个不同的实现类型。
D 行回答的是另一个问题:如果不想付适配器的钱,能不能绕过它。D 让旧类自己实现新接口,中间没有适配器对象,比 B 少一层。测量结果与 B、A 都在同一档,两个 JDK 上都分不出差别。绕过包装能省下的东西在这份数据里是零。
跨 JDK 看,同一组在两个 JDK 上的中位数差 +0.00 ns/次(A)、-0.17 ns/次(C,JDK 25 更低)。这个差异不构成本文任何结论,两个 JDK 都是默认参数的 HotSpot,C2 的内联策略在这个规模上没有可见变化。
怎么读这张表
表里带结论的是两个比值:3.07× 与 2.90×。它们说明多实现调用点比单态慢出几倍,量级足以跨过测量噪声。A、B、D 三行的中位数一致,逐轮最大值与最小值的差不超过 0.04 ns,读不出方向。
D 组的机器码比 B 组短:少了适配器对象,也少了那层转发,测量结果却与 B 组无法区分。这层转发在稳态里不占时间,为省它而让旧类实现新接口,换不到任何东西。
A 组同样有成本:它每次迭代要调用 next() 与静态 decode 两次,只是 JIT 把这两次都内联了。决定成本的是这些调用能不能被内联,与调用次数关系不大。
7 轮的原始数字
JDK 21,单位 ns/次:
| 组 | 第 1 轮 | 第 2 轮 | 第 3 轮 | 第 4 轮 | 第 5 轮 | 第 6 轮 | 第 7 轮 | 中位数 |
|---|---|---|---|---|---|---|---|---|
| A 直接调用 | 0.96 | 0.96 | 0.97 | 0.96 | 0.97 | 0.96 | 0.96 | 0.96 |
| B 一层适配 | 0.96 | 0.96 | 1.00 | 0.96 | 0.96 | 0.96 | 0.96 | 0.96 |
| C 多实现(8 个类型) | 2.97 | 2.94 | 2.94 | 2.95 | 2.94 | 2.96 | 2.97 | 2.95 |
| D 绕过包装 | 0.97 | 0.96 | 0.96 | 0.97 | 0.96 | 0.96 | 0.96 | 0.96 |
JDK 25,单位 ns/次:
| 组 | 第 1 轮 | 第 2 轮 | 第 3 轮 | 第 4 轮 | 第 5 轮 | 第 6 轮 | 第 7 轮 | 中位数 |
|---|---|---|---|---|---|---|---|---|
| A 直接调用 | 0.95 | 0.98 | 0.96 | 0.97 | 0.96 | 0.96 | 0.96 | 0.96 |
| B 一层适配 | 0.95 | 0.96 | 0.96 | 0.96 | 0.96 | 0.96 | 0.95 | 0.96 |
| C 多实现(8 个类型) | 2.78 | 2.81 | 2.77 | 2.78 | 2.78 | 2.78 | 2.78 | 2.78 |
| D 绕过包装 | 0.96 | 0.97 | 0.96 | 0.95 | 0.96 | 0.96 | 0.96 | 0.96 |
C 组的 7 轮数值同样稳定,两个 JDK 上的最小值都没有落进 A 组的区间,差距稳定在整档上,并且不随 JDK 变化。
四、内联决策:PrintInlining 的原文
耗时表给出差距,说明不了差距从哪来。加 -XX:+UnlockDiagnosticVMOptions -XX:+PrintInlining 把 JIT 的内联决策打出来,原因就写在日志的每一行里。
B 组(单态调用点),JDK 25 的日志原文:
1 | @ 13 AdapterBench$SourceAdapter::read (11 bytes) inline (hot) callee changed to AdapterBench::viaAdapter (29 bytes) \-> TypeProfile (197632/197632 counts) = AdapterBench$SourceAdapter |
三行 inline (hot) 连成一条链:C2 先内联 viaAdapter 里的 CharReader::read,展开之后继续内联 SourceAdapter::read 里的 ByteSource::next 与 decode。\-> TypeProfile (197632/197632 counts) = AdapterBench$SourceAdapter 说明这个调用点从运行开始到现在只见过一个实现类型,计数比是 100%(两个数字相同:197632 次采样里 197632 次是同一个类型)。B 组的循环在机器码层面就是 A 组的循环,调用次数与指令条数都相同。
C 组(多实现调用点),同一个 JDK 的日志里有一次完整的推翻过程:
1 | 48 37 % 3 AdapterBench::viaMega @ 5 (29 bytes) made not entrant: OSR invalidation of lower levels |
第一段是 C 组在循环中途编译出的版本(末尾 % 表示 OSR 编译)。那时调用点只见过 Impl0 与 Impl1 两个类型,C2 按双态内联了两份展开,TypeProfile 把两个类型的计数与比例一并写出。紧接着一行 made not entrant: uncommon trap:第三个实现类型出现,双态假设失效,这段编译结果作废,执行回到解释器。
第二段是重新编译的版本。此时调用点已经见过 8 个类型,CharReader::read 那一行的结论是 failed to inline: virtual call,没有 inline (hot)。此后每次 read() 都是真实的接口分发。
JDK 21 的日志里同一件事的措辞少一个前缀,结论相同:
1 | 49 43 4 AdapterBench::viaMega (29 bytes) |
单态的两组在 JDK 21 上同样只有一条链:
1 | @ 13 AdapterBench$SourceAdapter::read (11 bytes) inline (hot) |
D 组的日志只是链更短,同样是 inline (hot):
1 | @ 13 AdapterBench$ByteSource::read (8 bytes) inline (hot) callee changed to AdapterBench::viaSelf (29 bytes) \-> TypeProfile (1016830/1016830 counts) = AdapterBench$ByteSource |
触发条件写在 HotSpot 的参数里:TypeProfileWidth 默认值 2(JDK 21 与 JDK 25 上 -XX:+PrintFlagsFinal 都是 = 2),调用点最多记录两个实现类型,第三个出现时按超多态处理。这个参数在 OpenJDK 源码里的定义是 product(intx, TypeProfileWidth, 2, "Number of receiver types to record in call/cast profile") range(0, 8)(src/hotspot/share/runtime/globals.hpp:1354),上限 8 个类型。方法体积也不是限制:viaAdapter 29 字节、SourceAdapter::read 11 字节、ByteSource::next 38 字节、decode 20 字节,都远在 FreqInlineSize 默认的 325 字节额度之内。
日志每行的格式是「时间 编译序号 编译层级 方法名」,行首带 % 的是 OSR 编译(循环跑到一半触发的那次)。要自己复现这几段原文,用同一条命令即可:
1 | java -XX:+UnlockDiagnosticVMOptions -XX:+PrintCompilation \ |
后四个参数是运行长度与轮数:A/B/D 每组 196 万次、C 组每个实现 26 万次、1 轮预热、2 轮测量;末尾的 quiet 让基准自己不打印,日志里只剩 JVM 的输出。-XX:CompileCommand=quiet 与 PrintInlining,'AdapterBench*::*' 把打印范围限制在这四个类上,两份日志各 200 行上下,可以直接人眼过一遍。
差距的来源就写在这些日志行里:判定成本的是调用点的类型分布,适配器对象在其中不起作用。B 与 C 的源码差别只是 8 个类名,机器码差别是一次内联和一次接口分发,1 亿次累计成 3.07× 的差距。
五、关掉 JIT 之后
把 JIT 关掉(-Xint),内联与类型 profile 都不存在,每层调用都按解释器的规则付钱。同样的四组,A/B/D 每轮 1,310,720 次调用,C 组 1,048,576 次,1 轮预热后测 3 轮取中位数:
| 组 | 调用形态 | JDK 21 (ns/次) | JDK 25 (ns/次) | 相对 A(JDK 25) |
|---|---|---|---|---|
| A | 直接调用 | 53.56 | 53.91 | 1.00 |
| B | 一层适配 | 77.23 | 79.24 | 1.47× |
| C | 多实现 | 77.18 | 78.58 | 1.46× |
| D | 绕过包装 | 75.17 | 78.94 | 1.46× |
解释器下 B 组的耗时是 A 组的 1.47×(79.24 对 53.91 ns/次),每次调用多出的 25.33 ns 就是那一层的价格。A 组每次迭代付两次解释调用(next() 与静态 decode),B 组付三次(多一层 read())。上一节 C 相对 B 的劣势在这里消失:JDK 25 上 C 组 78.58 对 B 组 79.24,JDK 21 上是 77.18 对 77.23,与 D 组几乎重合。解释器下每次调用都要完整分派,调用点上实现的种类数不再产生差别。
两组数字摆在一起,适配器的成本是这样分布的:解释执行时每多一层调用就多付一次分派;JIT 打开之后,单态调用点上内联把这一层抹掉,多态调用点上同一层开销以接口分发的方式回来。
解释执行会在这些场景里出现:进程启动阶段的前几千次调用、明确关闭 JIT 的批处理、JIT 判定为冷方法而留在解释器里的调用路径。每一层适配器在这里都实付成本,单位是每次几十纳秒,只有在循环百万次的路径上才值得看一眼。
六、JDK 源码里的四个适配器
Arrays#asList:数组接口到 List 接口
JDK 25,java.base/java/util/Arrays.java:4180:
1 | public static <T> List<T> asList(T... a) { |
同文件 :4151-4153 的注释把动机写得很直白:This method acts as bridge between array-based and collection-based APIs。返回的 ArrayList 是文件内的私有类(:4187),它持有原数组(:4194 private final E[] a;),get 直接读数组下标(:4224):
1 |
|
适配器在这里的全部开销是一个对象头加一个字段,O(1),与数组长度无关。set 也是直接写回原数组(:4229),所以列表和数组是同一份数据,改一边另一边跟着变。类注释在 :4138 与 :4143-4145 说明了边界:返回的是 a fixed-size list backed by the specified array,改变长度的操作会抛 UnsupportedOperationException。
InputStreamReader:字节流接口到字符流接口
JDK 25,java.base/java/io/InputStreamReader.java:34 的类注释:
1 | * An InputStreamReader is a bridge from byte streams to character streams: It |
InputStreamReader(:69)只持有一个 StreamDecoder(:70 private final StreamDecoder sd;),方法是清一色的一行转发。read() 在 :174:
1 | public int read() throws IOException { |
read(char[], int, int)(:182)、ready()(:193)、close()(:197)形状相同。整个文件 201 行,除 4 个构造函数与 javadoc 之外,6 个方法的全部内容都是 sd.xxx()。
JDK 25 全部源码里,类注释直接写 is a bridge from 的只有两处,分别在这一对适配器的 :34 行。
解码发生在 java.base/sun/nio/cs/StreamDecoder.java。解码器带一个 8192 字节的输入缓冲(:50 DEFAULT_BYTE_BUFFER_SIZE = 8192;),字节先读进缓冲再解码:
1 | int n = in.read(bb.array(), bb.arrayOffset() + pos, rem); // StreamDecoder.java:279 |
它还保存一个「读多出来的半个字符」(:59-64 的 haveLeftoverChar 与 leftoverChar),因为 UTF-16 的代理对必须成对处理,而 read() 一次只返回一个字符(:118-148)。适配器在这里既有状态也有逻辑,接口翻译与解码策略叠在一条调用链上。
OutputStreamWriter.java:34 是反方向:
1 | * An OutputStreamWriter is a bridge from character streams to byte streams: |
write(int c)(:187)转发给 se.write(c),write(char[], int, int)(:205)与 write(String, int, int)(:223)同样转发。:40-43 的注释说明了缓冲的位置:The resulting bytes are accumulated in a buffer before being written to the underlying output stream,字符本身不缓冲,编码后的字节才进缓冲。这一对适配器覆盖同一个问题的两个方向,一侧的接口是字节流,另一侧是字符流,转换发生在中间的解码器与编码器里。
Collections#unmodifiableList:接口的收窄
JDK 25,java.base/java/util/Collections.java:1475:
1 | public static <T> List<T> unmodifiableList(List<? extends T> list) { |
UnmodifiableList(:1488)持有被包装的列表(:1495 final List<? extends E> list;),读操作转发(:1505 public E get(int index) {return list.get(index);}),写操作抛异常(:1506):
1 | public E set(int index, E element) { |
这是适配器的第三种用法:接口形状不变,可用方法的集合收窄。它是一层视图,不复制任何元素,底层列表的改动会直接反映到这层包装上。unmodifiableList 自身还做了幂等判断(:1476),入参已经是不可修改的包装时直接返回原对象,避免包装层层套叠。
四个适配器的共同点
| 适配器 | 持有的字段 | 每次调用做什么 | 构造成本 |
|---|---|---|---|
Arrays#asList |
E[] a |
数组下标读写 | 1 个对象 |
InputStreamReader |
StreamDecoder sd |
转发 + 解码 + 8192 字节缓冲 | 1 个对象 + 1 个解码器 |
OutputStreamWriter |
StreamEncoder se |
转发 + 编码 + 输出缓冲 | 1 个对象 + 1 个编码器 |
Collections#unmodifiableList |
List<? extends E> list |
读转发、写抛异常 | 1 个对象 |
四个类的构造成本都是 O(1),没有数据复制。三个字段名(a、sd、list)都指向被适配的对象,转发方法都只有一行。第一节测的就是那一行的价格。
四个适配器在真实代码里还会和装饰器叠在一起。InputStreamReader 的类注释就推荐这种叠法(InputStreamReader.java:46-51):For top efficiency, consider wrapping an InputStreamReader within a BufferedReader,理由是适配器每次 read() 都要经过解码器,BufferedReader 把字符也缓冲一层,减少进入解码器的次数。这条链上外层是装饰器(同接口加缓冲),内层是适配器(换接口加解码),两种模式各管一段,互不替代。缓冲层的代价与顺序已经在装饰器一篇里量过。
怎么核对行号
上面所有行号都指向 JDK 25 安装目录里的 src.zip,可以直接查:
1 | unzip -p "$JAVA_HOME/lib/src.zip" java.base/java/util/Arrays.java | sed -n '4180,4182p' |
InputStreamReader 的转发链还可以用 javap 从字节码上看:javap -c -p java.io.InputStreamReader 里每个方法的常量池引用都指向 StreamDecoder,类里没有别的字段。
七、边界
适配器与装饰器。 适配器换接口,调用方拿到的类型与传入的不同:ByteSource 进,CharReader 出。装饰器保持类型不变,在调用前后做别的事:BufferedInputStream 进,BufferedInputStream 出,流本身没变,只是多垫了一层缓冲。判断方法是在构造点看两侧的静态类型,相同是装饰,不同是适配。装饰器的详细数据在装饰器一篇里。
适配器与桥接。 适配器处理已经存在的两个不匹配接口,转换发生一次,之后调用方拿到的就是它要的类型。桥接处理的是设计期的问题:两个维度都会各自扩展,把继承换成组合,让 形状 × 颜色 不再需要 2×2 个类。桥接的两个维度之间没有新旧之分,也不用翻译,见桥接一篇。
适配器与代理。 代理与被代理对象实现同一个接口,管的是访问控制与转发时机:延迟加载、权限检查、远程调用。适配器的两个接口本来就不同,也没有访问控制语义,见代理一篇。
四个模式都会产生一个持有引用的中间对象,代码形状接近,性能特征也接近:O(1) 构造加一次转发,受同一套内联规则支配。选哪个由动机决定,性能上四者没有可测的差别。
八、结论
什么时候用适配器
调用方的类型已经定死(第三方库的参数、java.io.Reader、java.util.List 这类标准接口),而现有实现的接口对不上,同时现有实现改不了或者不该改。两个条件同时满足时,适配器是唯一不复制数据的解法。
Arrays#asList 与 Collections#unmodifiableList 另外说明了一种情况:新旧两个接口都是自己的,选择适配器而不改类型,是因为旧接口的语义仍然需要保留(数组仍能按下标写,底层列表的原持有者仍能改)。
常见场景还有两类。一类是新接口已经上线,旧实现还要继续服务旧调用方,两者之间加一层适配器,两边都不必做破坏性改动;另一类是测试替身,把真实对象换成受控实现,被测代码拿到的类型不变。这两类的共同点是接口所有权不在自己手里,或者改接口的代价大于加一层。
什么时候不用
- 不想付那一层转发。D 组的数据说明这个方向没有回报:绕过适配器对象、让旧类直接实现新接口,两个 JDK 上都测不出差别。省掉的层数在 1 亿次调用里小于轮间波动,代价是让旧类多背一个新接口。
- 想给对象加能力。加缓冲、加计数、加校验是装饰器的活。用适配器做这件事,调用方得同时认识两个接口。
- 调用点是热的,并且会收到多种实现类型。这时 1 亿次调用的耗时是单态形态的 3 倍左右(JDK 21 为 3.07×,JDK 25 为 2.90×),来源是接口分发本身。这种情况下删掉适配器省不了钱,能省钱的是收敛调用点上的类型,或者把值取出来批量处理。
适配器不一定是对象
本文测的 B 组是对象适配器:一个实现新接口的对象持有旧对象,转发靠委托。另一种常见写法是函数级适配,即 A 组的形态,在调用处直接转换,没有新类型。代价是调用方必须认识具体类型,也没法再做多态替换,换来的是省掉一个对象。
继承式的类适配器在 JDK 里找不到纯正的样本。FileReader extends InputStreamReader(FileReader.java:46)看起来像,被适配的 FileInputStream 仍然由构造参数传入(:59-61 super(new FileInputStream(fileName));),它继承的是适配器本身,作用是把数据源固定成一个文件,没有新增任何接口翻译。类适配器要继承被适配类、同时实现新接口,遇到 final 类,或者需要共享同一个被适配对象,就写不下去。
一条判断顺序
- 问调用方手里的接口和现有对象提供的接口是否相同。不同,进入下一步;相同,考虑装饰器或代理。
- 问差异是否来自两个都在独立变化的维度。是,用桥接;否,用适配器。
- 问这个调用点会不会收到多种实现类型。会,先让类型收敛或者改成批量取值;不会,适配器那层转发在内联之后量不出来。
总结
- 1 亿次调用,JIT 打开:直接调用、一层适配、绕过包装三种形态在两个 JDK 上都落在同一档,轮间波动大于三者之间的差;只有多实现调用点的耗时稳定落在单态形态的 3 倍左右(JDK 21 为 3.07×,JDK 25 为 2.90×)。
-XX:+PrintInlining的原文给出机制:单态调用点打印inline (hot)与TypeProfile (197632/197632 counts) = AdapterBench$SourceAdapter;多实现调用点先按双态内联,第三个类型出现时made not entrant: uncommon trap,重编译后是failed to inline: virtual call。- 触发条件是
TypeProfileWidth(默认 2,两个 JDK 相同),决定是否触发的是调用点的实现类型数。 - 关掉 JIT(
-Xint)之后那层转发的开销直接落在数字上,B 组的耗时约为 A 组的 1.47×。JIT 把解释执行的常数开销抹平;多态分派的开销保留。 - JDK 里的四个适配器:
Arrays#asList(Arrays.java:4180,O(1) 视图)、InputStreamReader(InputStreamReader.java:174,一行转发给StreamDecoder,后者带 8192 字节缓冲与半个字符的状态)、OutputStreamWriter(OutputStreamWriter.java:187,反方向,编码后的字节进缓冲)、Collections#unmodifiableList(Collections.java:1475,视图加接口收窄,对已是不可修改的入参幂等返回)。 - 边界:适配器换接口,装饰器不改接口加行为,桥接拆两个独立维度,代理管访问。四者的性能结构相同。
参考资料
- Arrays (Java SE 25)
- Collections (Java SE 25)
- InputStreamReader (Java SE 25)
- OutputStreamWriter (Java SE 25)
- Reader (Java SE 25)
- List (Java SE 25)
- JVMS §6.5 invokeinterface
- OpenJDK jdk25u: sun.nio.cs.StreamDecoder
- OpenJDK jdk25u: runtime/globals.hpp(TypeProfileWidth 定义)
系列索引:设计模式系列