设计模式——桥接:两个维度独立变化
两个维度各自独立变化时,继承把它们乘起来:4 种报表 × 4 种格式 = 16 个叶子类,加第 5 种报表要再写 4 个。
桥接把乘积拆成和:两个层次各管一个维度,运行时用一个引用把交叉点接上。
代价是热路径上每次调用多一跳。JIT 内联掉这一跳,它是零成本;内联不掉,就是每次 0.6 纳秒。
一、桥接换的是算术
一个报表导出模块。报表有 4 种,导出格式有 4 种,两者的交叉决定行为:销售报表按 CSV 输出,和库存报表按 CSV 输出,是两个不同的实现,共享的只有「把逗号换成竖线」这类细节。
用继承写,交叉点就是类:
    classDiagram
    direction TB
    class Report {
        <<abstract>>
        +export(data)
    }
    class SalesCsv
    class SalesJson
    class SalesXml
    class SalesMarkdown
    class InventoryCsv
    class InventoryJson
    class InventoryXml
    class InventoryMarkdown
    Report <|-- SalesCsv
    Report <|-- SalesJson
    Report <|-- SalesXml
    Report <|-- SalesMarkdown
    Report <|-- InventoryCsv
    Report <|-- InventoryJson
    Report <|-- InventoryXml
    Report <|-- InventoryMarkdown
    note for SalesMarkdown "4 种报表 × 4 种格式 = 16 个叶子类,每个叶子一份格式代码"
桥接把「报表」和「导出」拆成两个层次,各自演化:
    classDiagram
    direction TB
    class Report {
        <<abstract>>
        #Exporter exporter
        #String name
        +export(data)
        #with(Exporter) Report
    }
    class SalesReport
    class InventoryReport
    class Exporter {
        <<interface>>
        +export(name, data)
    }
    class CsvExporter
    class JsonExporter
    Report <|-- SalesReport
    Report <|-- InventoryReport
    Exporter <|.. CsvExporter
    Exporter <|.. JsonExporter
    Report o-- Exporter : 桥
两个层次各加各的:加一种报表,抽象侧加一个类;加一种格式,实现侧加一个类。交叉组合在运行时组装,编译期不必为「销售 × CSV」存在一个单独的类型。
桥接买的是 m×n 到 m+n 的算术,代价是 Report.export 要把请求转给 exporter,多一次间接。本文的实验量这两端:类少掉多少,那一跳值多少。
怎么认出两个维度
判断标准是扩展的方向:报表种类变多是一个方向,导出格式变多是另一个方向,新需求进来先看它往哪边加取值。两个方向互不隶属,任一方向的取值都能和另一方向的任意取值组合时,桥接才成立。
类名是现成的线索。SalesCsv、InventoryJson 这种把两个名词粘在一起的类名,说明类型系统里写进了交叉点。粘出来的词越多,改动成本越高:给「销售」加一个字段要动 4 个类,给 CSV 改一处转义规则也要动 4 个类。再加第三个维度(输出目的地:文件 / 网络 / 控制台),继承版就是 4×4×4 = 64 个类,两个维度时是 16 个。
拆开之后,层次内部仍然可以用继承:桥接只在两个层次之间要求 holds-a,抽象侧照旧用抽象类和模板方法,实现侧可以实现多个接口。两者不互斥。
二、实验怎么做的
两个维度各取 4 个值,两份实现做同一件事。继承版的叶子长这样:
1 | public final class SalesCsv extends Report { |
桥接版把同样的两个方法拆到两层:抽象层持有一个 Exporter 并转调,实现层承担格式代码。
1 | public abstract class Report { |
除了 final 标记和类的组织方式,两份代码的骨架逐字一致:同样的 StringBuilder、转义分支与字符循环。骨架一致,测出来的差才只来自结构。
三份实现同时在跑:
- 继承:
Report抽象类 + 16 个叶子,每个叶子内联自己的格式代码 - 桥接:
Report抽象类 + 4 个报表子类,Exporter接口 + 4 个导出器;抽象层方法final - 桥接·提升传参:与桥接结构相同,只是把
name.length()在构造时算好存进int字段,调用时传int而不是String
第三份单独拎出一个变量。第一轮测出桥接比继承多出的时间里,混着一项与被调方法无关的开销:继承版的叶子把名字写成字面量,"Sales".length() 在编译期就是常量;桥接版拿到的是 String 参数,每次都要读字段。这一项与「多一层间接」无关,要分开量。
测三样:
- 类文件数量与总字节
- 类加载耗时。每轮新建
URLClassLoader,逐个Class.forName(name, true, loader)触发加载与链接,5 轮取中位数 - 每次分派的耗时。两种负载:
scan不分配内存(数一遍逗号返回int),str走真实路径(StringBuilder拼出结果返回String)
环境:Apple M1 Pro(10 核),macOS Darwin 25.6.0,JDK 21.0.8+12-LTS-250 与 JDK 25+37-LTS-3491,都是 arm64。计时循环在全局锁内跑,同一时刻没有其他进程抢 CPU;每轮新起 JVM,先预热再计时,取中位数。
前两个用类文件数量和字节数衡量,不用源码行数。行数取决于排版和注释,换个格式化工具就变;类文件才是 JVM 要读、要验证的东西,也是类加载耗时的自变量。
局限:
- 本机没有 JMH。这是单机微基准,用来判断量级和方向,不能当硬件上限
- 分派实验只覆盖一种调用形状:循环里按下标取对象,调一个返回
int或String的方法。真实系统的调用点还受参数类型、栈深度、内联预算影响 - 桥接版把抽象层的转调写成了
final。这是常见写法,也让桥接在热路径上只剩一次实现层调用。改成可覆写的虚方法,两个层次都得虚分派,这一种情况单独测了,数字在第四节 - 两份实现的业务代码形状一致。真实项目里继承版往往是历史包袱、桥接版是重构结果,代码差异不止类数
三、实测一:类、字节、加载
类文件数量与总字节
| 规模 | 继承:类数 | 继承:字节 | 桥接:类数 | 桥接:字节 |
|---|---|---|---|---|
| 4 × 4 | 17 | 14,665 | 10 | 6,181 |
| 4 × 5 | 21 | 18,097 | 11 | 7,060 |
| 5 × 4 | 21 | 18,177 | 11 | 6,533 |
| 8 × 8 | 65 | 56,793 | 18 | 11,179 |
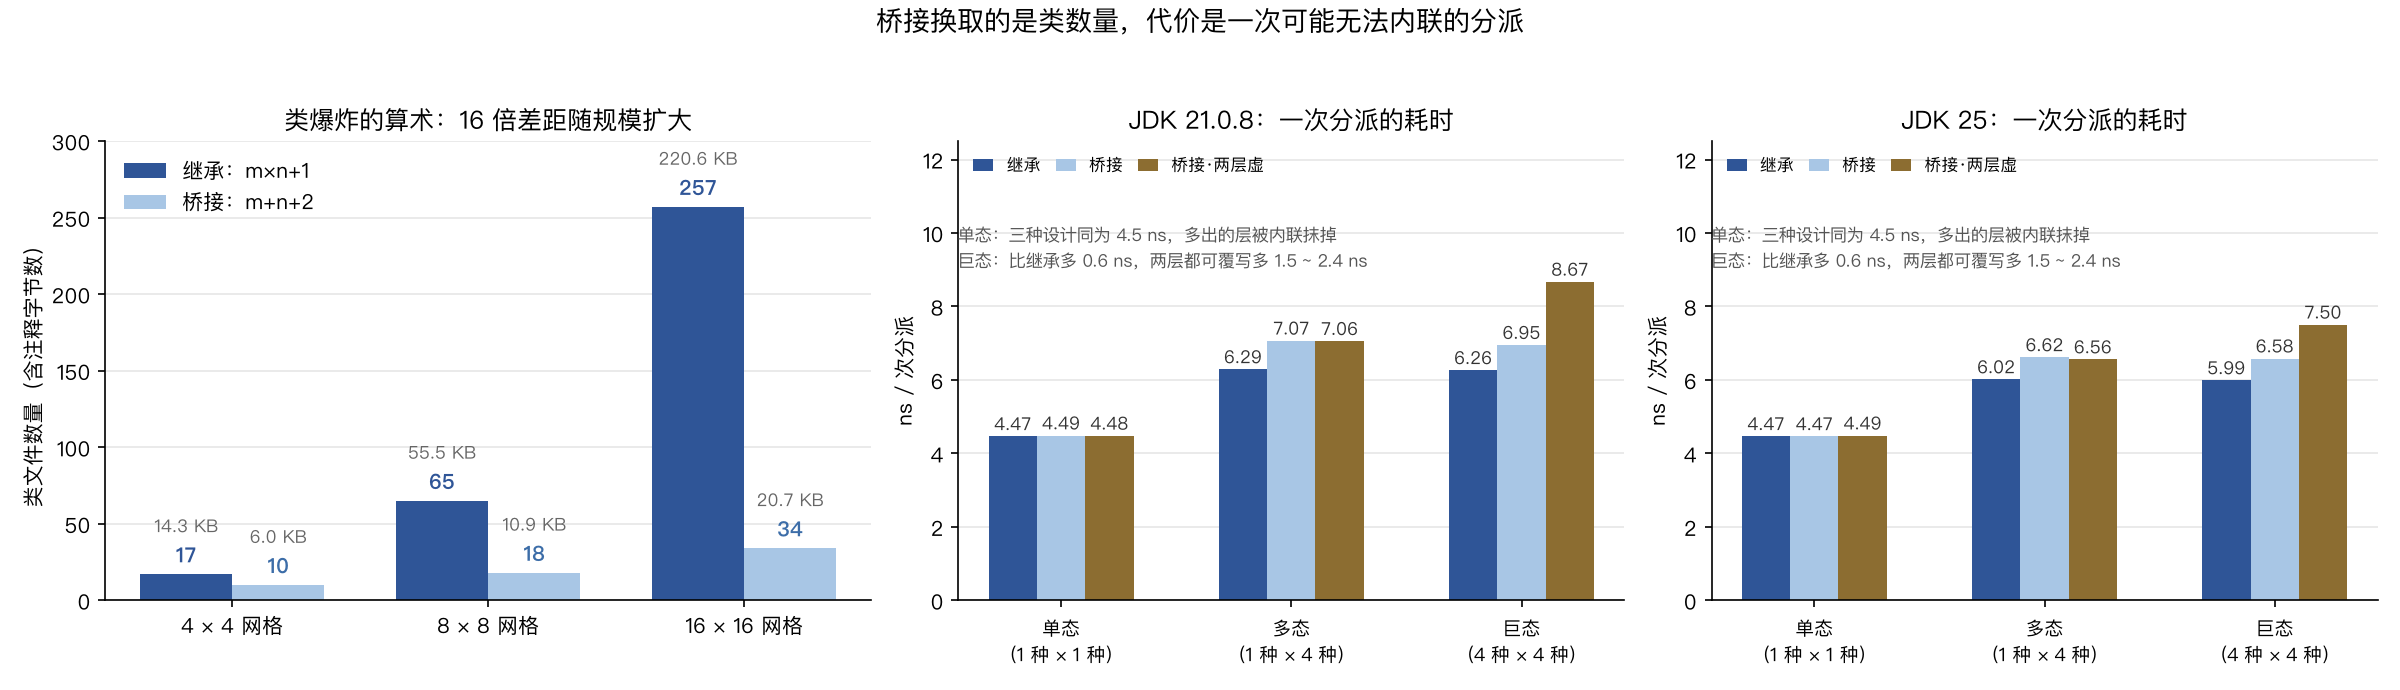
| 16 × 16 | 257 | 225,897 | 34 | 21,227 |
两列数字各有公式。继承版的类数是 m×n + 1(一个抽象基类加全部交叉),桥接版是 m + n + 2(抽象层 1 个基类加 m 个子类,实现层 1 个接口加 n 个实现)。
到 16×16,比例是 257 对 34,类文件字节 220.6 KB 对 20.7 KB,超过 10 倍;到 4×4 只有 1.7 倍。倍数随维度取值个数增长,4×4 的 1.7 倍不能外推到更大规模;两个维度各 32 个取值时是 1025 对 66。
4×4 到 4×5 那一行能看清增量分布:给格式维度加一个取值,继承版多 4 个类(每个报表各一份),桥接版多 1 个(一个导出器);给报表维度加一个取值,数目同样。桥接把「加一个取值」的代价从 m 个类降到 1 个类,这是它最实际的收益,也是重构时唯一不用赌的部分。
源码行数同方向:4×4 规模下,继承版 17 个文件共 330 行,桥接版 10 个文件共 114 行。
编译时间
同一批源码用 JDK 21 的 javac 编三遍,取墙钟秒数:
| 规模 | 文件数(继承 / 桥接) | 继承三遍 | 桥接三遍 |
|---|---|---|---|
| 4 × 4 | 18 / 11 | 0.420 / 0.429 / 0.414 | 0.377 / 0.373 / 0.381 |
| 8 × 8 | 65 / 18 | 0.534 / 0.557 / 0.657 | 0.375 / 0.381 / 0.375 |
| 16 × 16 | 257 / 34 | 0.915 / 0.852 / 0.832 | 0.416 / 0.391 / 0.399 |
javac 自身的启动时间就在 0.37 秒上下,桥接那一列基本只量到了启动。把启动扣掉,编译 257 个文件比编译 34 个多花 0.45 秒左右,摊到每个文件约 2 毫秒。这个差额在 CI 里排不上号。
类爆炸的代价先落在源代码组织和构建工具上,不在这几毫秒里。257 个文件对 34 个,代码审查、IDE 索引、改一处要碰几个文件,这些差别每天都在发生,编译时间是其中最小的一项。
类加载
每轮新建一个 URLClassLoader,把目录里的类全部 forName(n, true, loader) 并触发链接,5 轮取中位数。目录里含测试驱动类 Bench,两侧各多一个:
| 规模 | 加载类数(继承 / 桥接) | 继承中位数 | 桥接中位数 |
|---|---|---|---|
| 4 × 4 | 18 / 11 | 2.32 ms | 1.52 ms |
| 8 × 8 | 65 / 18 | 5.33 ms | 1.80 ms |
| 16 × 16 | 257 / 34 | 17.19 ms | 3.48 ms |
用两端点做线性估计,每个类的边际成本约 64 纳秒。固定开销(加载器对象、反射、Class.forName 的路径查找)在 1.5 毫秒上下,所以 4×4 这种规模上,0.8 毫秒的差值大半是固定开销的抖动,和那 7 个类关系不大。
16.7 毫秒对 3.5 毫秒,是这个实验里第二个达到量级的差,代价出现在启动阶段,进程活起来之后不再付。要不要拆,按场合分两类:启动敏感的(CLI 工具、短生命周期函数、按冷启动计费的 serverless),类的数量就是指标;长驻服务里,它只值一次启动的几百微秒。
四、实测二:多一层间接值多少
三个场景
分派实验的场景按调用点的多态程度分:
- 单态:数组里只有 1 个对象,调用点只见过一种接收者
- 多态:4 种格式配 1 种报表,调用点见过 4 种接收者
- 巨态:16 种组合全部轮流经过同一个调用点
scan 负载,每轮 2000 万次,预热 2 轮后测 5 轮取中位数,单位是纳秒每次分派:
| 场景 | JDK 21 继承 | JDK 21 桥接 | JDK 21 桥接·提升 | JDK 25 继承 | JDK 25 桥接 | JDK 25 桥接·提升 |
|---|---|---|---|---|---|---|
| 单态 | 4.467 | 4.819 | 4.488 | 4.468 | 5.077 | 4.466 |
| 多态 | 6.290 | 7.445 | 7.069 | 6.016 | 7.041 | 6.616 |
| 巨态 | 6.265 | 7.439 | 6.951 | 5.991 | 7.100 | 6.584 |
5 轮之间的波动最大到 0.4 纳秒。JDK 21 上每一档的原始分布(min / 中位 / max,单位纳秒):
| 场景 | 继承 | 桥接 | 桥接·提升 |
|---|---|---|---|
| 单态 | 4.390 / 4.467 / 4.693 | 4.811 / 4.819 / 4.896 | 4.420 / 4.488 / 4.545 |
| 多态 | 6.232 / 6.290 / 6.362 | 7.395 / 7.445 / 7.573 | 6.927 / 7.069 / 7.225 |
| 巨态 | 6.192 / 6.265 / 6.324 | 7.388 / 7.439 / 7.760 | 6.937 / 6.951 / 7.045 |
三档之间没有重叠:继承的 max 都小于桥接的 min,组间的差比组内的波动大。
三条能读出来的结论
一、单态下多出来的一跳是免费的。 继承 4.467,桥接·提升 4.488,两个 JDK 上的先后还不一致(JDK 25 是 4.468 对 4.466)。接收者只有一种时,JIT 把 Report.export 和 Exporter.scan 两层都内联进循环,间接消失。这种调用点上,桥接不比继承贵。
二、多态时,桥接多出 0.6 到 0.7 纳秒。 巨态:JDK 21 上 6.265 对 6.951(+0.69),JDK 25 上 5.991 对 6.584(+0.59)。相对量 10% 到 12%。
三、多出的这一跳和「多传一个参数」是两笔账。 桥接列比「桥接·提升」列稳定地多出 0.33 到 0.61 纳秒,单态下也有这一份(4.819 对 4.488),说明它来自调用形状,与被调方法能不能内联无关。参数换成 int 之后,单态下的差归零。
0.6 纳秒每次调用放到调用量上看:调用点每秒走一亿次,是 60 毫秒;每秒一千万次,是 6 毫秒。桥接换掉的是 220.6 KB 的类文件和 223 个多出来的类,两端的量级不该放在一起比。拿这条数据去支持「桥接更快」用错了方向;它说明的是「桥接慢」这句话需要前提。
两层都可覆写时
上面的桥接版把抽象层的 export 与 scan 写成了 final,转调是固定目标,能被内联。如果把这两个方法改成普通虚方法,并在 4 个报表子类里各自覆写一次(都转发给 super),循环里就多出一种接收者:
| 场景 | JDK 21 继承 | JDK 21 桥接 | JDK 21 桥接·两层虚 | JDK 25 继承 | JDK 25 桥接 | JDK 25 桥接·两层虚 |
|---|---|---|---|---|---|---|
| 单态 | 4.467 | 4.488 | 4.481 | 4.468 | 4.466 | 4.485 |
| 多态 | 6.290 | 7.069 | 7.057 | 6.016 | 6.616 | 6.559 |
| 巨态 | 6.265 | 6.951 | 8.672 | 5.991 | 6.584 | 7.505 |
表里的「桥接」列取的是「提升传参」那一版,好让三列的差异只来自分派次数。
单态那一行三个数又贴回 4.5 纳秒;多态那一行,两层虚版和一层版基本重合(7.057 对 7.069)。多态场景里 4 个对象的类型相同(同一个报表配 4 种格式),循环里的接收者只有一种,JIT 照样内联抽象层那次分派,只剩实现层那一次。
到巨态才分叉:8.672 对 6.265(JDK 21),多出 2.4 纳秒;JDK 25 上是 7.505 对 5.991,多出 1.5 纳秒。分派次数从 1 变成 2,代价从 0.6 涨到 1.5 到 2.4 纳秒。
涨价超过一倍,原因在下一节的内联日志里:一层版的循环内联了 Report::scan,转发代码和调用点在同一段编译单元里,字段读取和参数搬运能一起优化;两层版的循环连叶子方法都内联不了,代价是一个完整的方法调用边界,不再是一次跳转。
声明 final 就是把选择写进方法签名:放弃「子类可以改这条转调路径」,换 JIT 内联它。桥接的两个层次都留扩展点时,热路径上就是两次无法内联的分派。
str 负载:测不出来
把 scan 换成真实路径的 StringBuilder 拼接之后,分配吃掉了两个设计的差(每轮 300 万次,预热 1 轮后测 3 轮):
| 场景 | JDK 21 继承 | JDK 21 桥接 | JDK 25 继承 | JDK 25 桥接 |
|---|---|---|---|---|
| 单态 | 86.7 | 88.4 | 31.3 | 38.0 |
| 巨态 | 86.8 | 85.2 | 54.6 | 47.8 |
单次调用要构造 StringBuilder、扩容、toString() 时,每次的分配与拷贝成本是 30 到 90 纳秒,比 0.6 纳秒的分派开销大两个数量级。同一配置在 3 轮之间的跨度能到 20 纳秒(JDK 25 单态继承版 min 30.8、max 52.7),比要测的差本身还大。
- JDK 21 上三个场景、两个设计的六个数字全落在 85 到 88 纳秒之间,先后顺序不定
- JDK 25 上的绝对值整体更低(30 到 55 纳秒),方差也更大,两个设计的方向与 JDK 21 相反
被调方法自己会分配内存时,一层间接的代价不可测。 多数业务代码里的桥接,处境就是这样。
解释执行下也没有量级差
把 JIT 关掉(-Xint),每次分派回到解释器里的完整调用序列,数据字符串缩短到 "a,b",20 万次一轮,取 3 轮中位数:
| 场景 | JDK 21 继承 | JDK 21 桥接 | JDK 21 桥接·提升 | JDK 25 继承 | JDK 25 桥接 | JDK 25 桥接·提升 |
|---|---|---|---|---|---|---|
| 单态 | 583 | 599 | 563 | 577 | 609 | 578 |
| 巨态 | 586 | 600 | 567 | 588 | 630 | 604 |
解释执行下一次分派要几百纳秒,桥接比继承多 2% 到 7%。这一列里有反例:JDK 21 上「桥接·提升」比继承快 3.4%,JDK 25 上两者持平,同一个结构在解释器里的耗时随方法体的字节码条数变化。「多一层就慢一倍」在解释执行下也不成立,解释器里一次调用本身的开销,远小于被调方法里那几十条字节码。
内联日志里的机制
-XX:+PrintInlining 加上 -XX:CompileCommand=compileonly,只看循环方法自己的内联决策。巨态场景下,JDK 21 的继承版:
1 | @ 36 inh.Report::scan (0 bytes) virtual call |
(0 bytes) 是抽象方法的字节码长度。调用点见过 16 种接收者,C2 不给任何一种做内联,每次调用走一次间接分派。
桥接版同一个位置:
1 | @ 36 bri.Report::scan (15 bytes) inline (hot) |
Report::scan 是 final,静态目标确定,被直接内联进循环;转调之后的 Exporter::scan 才是因为 4 种实现而无法内联的那一次。桥接在热路径上剩下的分派和继承版一样是一次,只是这次落在接口调用上,外面包着一层内联后的转发代码。
两层虚的版本里,同一份日志变成这样。循环里的调用点:
1 | @ 36 brd2.Report::scan (15 bytes) virtual call |
进到叶子的实现里,转调才被内联,剩下的还是那一次实现层调用:
1 | @ 2 brd2.Report::scan (15 bytes) inline (hot) |
两次分派都不在内联范围内,上一节那 2.4 纳秒就是这么来的。对比 final 版本:只有一次 virtual call,循环里那次被内联掉了。
把这 0.6 纳秒拆开:构成是一次接口调用与一次虚方法调用之间的差价,加上转发代码多占的几条指令,与「多一次函数调用」没有直接关系。同样的算术解释了 16 种接收者与 4 种接收者的直接调用几乎同价(6.27 对 6.29,JDK 21 巨态对多态):C2 的内联缓存对两者都不命中,剩下的成本是同一个桩。桥接的运行时开销取决于桥的两端各留了多少可扩展性,这个量能在方法签名上调整。
五、JDK 源码里的桥接
JDK 25 的 src.zip 里有一处完整的桥接:AWT 的 peer 机制。它把「组件是什么」和「组件在哪个平台上怎么画」拆成两个层次。
抽象层是 java.awt.Component 和它的子类,持有实现层的引用,字段声明在 java.desktop/java/awt/Component.java:230:
1 | transient volatile ComponentPeer peer; |
Button 在 addNotify() 里建立这座桥,java.desktop/java/awt/Button.java:167-173:
1 | public void addNotify() { |
之后的请求转发给实现层,同一文件 :200-202:
1 | ButtonPeer peer = (ButtonPeer)this.peer; |
实现层的接口在 java.desktop/java/awt/peer/ButtonPeer.java:39:
1 | public interface ButtonPeer extends ComponentPeer { |
这个目录下有 33 个 *Peer 接口,一个组件类型一个。实现侧在同一个 src.zip 里能数出两个平台家族:sun/awt/X11/ 下有 36 个 X*Peer.java,sun/lwawt/ 下有 18 个 LW*Peer.java。同一个组件的两份实现是两个不同的类:
1 | /** java.desktop/sun/awt/X11/XButtonPeer.java:36 */ |
两个家族里同名组件的两份实现,接口一样,类不一样:
| peer 接口 | X11 实现 | macOS 轻量实现 |
|---|---|---|
ButtonPeer |
XButtonPeer |
LWButtonPeer |
LabelPeer |
XLabelPeer |
LWLabelPeer |
ListPeer |
XListPeer |
LWListPeer |
ScrollPanePeer |
XScrollPanePeer |
LWScrollPanePeer |
WindowPeer |
XWindowPeer |
LWWindowPeer |
33 个接口里,15 个在两个家族里都有实现,14 个只有 X11 实现(DesktopPeer、RobotPeer、SystemTrayPeer 这类平台服务),2 个只有轻量实现(ContainerPeer、TextComponentPeer),剩下的 LightweightPeer 与 MenuComponentPeer 在这两个目录里都没有实现。取值个数在两个维度上不对称,macOS 侧不需要重写 X11 的托盘图标,Linux 侧也不用按 macOS 的方式管理容器,两个维度各长各的。
桥的第三个部件是工厂。Component.getComponentFactory() 把当前 Toolkit 当成工厂接口用,Component.java:1233-1239:
1 | final ComponentFactory getComponentFactory() { |
ComponentFactory 接口(java.desktop/sun/awt/ComponentFactory.java:95)声明了 25 个 createXxx 方法,默认实现都是 throw new HeadlessException();sun/awt/SunToolkit.java:111-112 声明 implements ComponentFactory,而它是 XToolkit 与 LWCToolkit 的共同基类:
1 | public abstract class SunToolkit extends Toolkit |
两个维度数一下:组件类型这一侧 33 个接口,平台这一侧两个工具包家族,实现类 36 + 18 = 54 个。两个维度谁都不需要知道对方有几个取值:Button 只认识 ButtonPeer 这个接口,XButtonPeer 只认识 Button 这个类。
不做这层拆分的话,Button 得按平台分叉成 XButton 与 LWButton,33 个组件类都这么处理就是 66 个具体类,而它们共享的组件逻辑(监听器列表、事件分派、布局参数、可见性状态)要么在两边各抄一份,要么再抽一个基类出来。桥接是这条继承又拆一次的结果。
不是所有两维结构都是桥接
JDK 里更多的地方是组合与工厂。下面两个例子常被误认成桥接。
java.base/java/nio/charset/Charset.java:797:
1 | public abstract CharsetDecoder newDecoder(); |
Charset 和 CharsetDecoder 看着像「字符集 × 编解码器」两个维度,但不构成桥接:解码器由字符集自己造出来,与字符集绑定。想换编码器换不了,想换字符集必须连解码器一起换。
java.sql/java/sql/Driver.java:91:
1 | Connection connect(String url, java.util.Properties info) |
DriverManager 拿 URL 挑一个驱动,再调用它的 connect 得到 Connection。这里有两个类型,但不是两个维度:Connection 是某个 Driver 的产物,换 Driver 通常换的是一整套实现。
区分标准可以落到代码上:两个维度之间是否存在一个可以独立增减取值的引用。Component 到 ComponentPeer 的字段是,Charset 到 CharsetDecoder 的工厂方法不是。前者的两端各自成树,后者的两边成对出现。
六、什么时候用,什么时候不用
判断顺序
第一步,问交叉是否成立。两个维度相乘之后,行为差异落在交叉点上,还是能拆进各自的方法里。报表 × 格式的例子成立,因为每格要产出的字节不同;如果差异只是「报表提供标题,格式负责排版」,组合或者模板方法就够了。
第二步,数类:取值个数各是几,加一个取值的频率是多少。4×4 是 17 对 10,不值得为它重构;16×16 是 257 对 34,那就是该动的结构。这条判断不需要基准测试,只要数。
第三步看调用点。热路径上的调用点能收敛到少数几种接收者时,JIT 内联桥接的第二跳,运行时接近零成本;调用点要见很多种组合时,代价是每次 0.6 纳秒。这个数字和业务代码里的分配、IO、锁相比通常可以忽略,除非这个调用每秒走一亿次以上。抽象层要不要保留可覆写也在这里定:留了扩展点,巨态调用点上的代价从 0.6 纳秒涨到 1.5 到 2.4 纳秒。
迁移的路径
已经有继承树、想改成桥接时,顺序是先把实现维度写成接口(把每个叶子里的格式代码搬进去),再把抽象侧改成持有这个接口的引用,最后把构造从 new 换成注入。三步都能独立编译通过,因为它们只是把同一段代码挪了位置。
反过来,桥接改回继承只在一种情况下做:两个维度里有一个不再变化,而且热路径上的调用点量出了问题。这时候把 4 个实现类内联进 4 个抽象子类,得到 16 个叶子,改动是机械的。
让调用点收敛
如果量下来代价不能忽略,能改的东西按性价比排序:
- 转调方法加
final。这一条把代价从 2.4 纳秒降到 0.6 纳秒(JDK 21 巨态),改的是一个关键字 - 缩小实现维度的取值个数。调用点见过的接收者种类越多,内联越不可能;把 16 种导出格式合并成 4 种(合并成参数化的一种),调用点就有机会回到单态
- 把热路径上的组合固化。用一次调用把「哪种报表配哪种格式」解析成一个函数对象,循环里只调那个对象,调用点回到单态
这三条都不改变结构,只改变结构暴露给 JIT 的样子。
和邻居的边界
- 适配器(/205079771.html):换接口,让已有的两个东西接上;桥接不换接口,它是事前设计的两个层次,两个维度都在自己的继承树上自由扩展
- 策略(/3654303619.html):换算法,实现类通常只被选一次就固定下来;桥接的两个维度都会各自增长,且抽象层自己也有状态和行为
- 状态(/204879800.html):实现对象随状态机切换,切换由对象自己发起;桥接的实现对象从外部注入,切换发生在构造期
- 抽象工厂(/4240986029.html):解决的是「一族相关的对象一起替换」,可以和桥接叠在一起,AWT 的
ComponentFactory就是这一层;桥接回答的是「一个对象的行为由两个维度共同决定」 - 装饰器(/1805545517.html):同样保持接口不变并持有同类型的引用,但它是栈式的,一层套一层,动态叠加;桥接是两层固定结构,两个层次的类型不同
什么时候不用
- 只有一个维度会变。 另一个维度始终只有一个取值,拆出来的那一层就是白付的间接
- 两个维度之间存在语义依赖。 某种格式只对某种报表有意义时,交叉点自带信息,硬拆会让运行期出现非法组合;这时宁可保留 16 个类,用 sealed 层次加
switch把组合穷尽 - 调用点巨态且每秒上亿次。 代价会到每秒几十毫秒,先量再定
- 只想复用一段代码。 两个维度各只有一个取值时,抽一个方法就够,不需要两个继承树
总纲那篇(/2097900514.html)里有个更一般的说法:模式被语言吃掉的前提是它还能提供别的东西。桥接没被吃掉,因为继承树的数量,语言管不了。
总结
- 桥接把
m×n + 1个类换成m + n + 2个。4×4 是 17 对 10,8×8 是 65 对 18,16×16 是 257 对 34,类文件字节 220.6 KB 对 20.7 KB - 加一个取值:继承版多写 m 个类(或 n 个),桥接版多 1 个。这是桥接最实际的收益
- 编译 257 个文件比 34 个多用 0.45 秒(
javac启动 0.37 秒不计),每文件约 2 毫秒。差别在日常的代码组织,不在构建 - 类加载:18 类 2.32 ms、65 类 5.33 ms、257 类 17.19 ms,桥接侧是 11 类 1.52 ms、18 类 1.80 ms、34 类 3.48 ms;边际成本约 64 纳秒一个类,固定开销 1.5 毫秒
- 分派:单态下继承 4.467 ns、桥接 4.819 ns、桥接·提升传参 4.488 ns(JDK 21),多出来的一跳被内联抹掉
- 巨态下 6.265 ns 对 6.951 ns(JDK 21,+0.69)、5.991 ns 对 6.584 ns(JDK 25,+0.59),多出的这 0.6 纳秒左右是一次无法内联的接口分派
- 抽象层与实现层的转调都可覆写时,巨态调用点上两次分派都不能内联,比继承多出 2.4 纳秒(8.672 ns 对 6.265 ns,JDK 21;JDK 25 是 1.5 纳秒);把转调写成
final是让它降到 0.6 纳秒的方法 -XX:+PrintInlining证据:继承版inh.Report::scan (0 bytes) virtual call,桥接版bri.Report::scan (15 bytes) inline (hot)加bri.Exporter::scan (0 bytes) virtual call- 被调方法自己做分配时(
StringBuilder路径),两个设计的差不可测:单次 30 到 90 纳秒的分配把 0.6 纳秒盖住,同一配置的轮间跨度能到 20 纳秒 - JDK 25 里的一手例子是 AWT 的 peer:
Component.peer(Component.java:230)、Button.addNotify里的工厂调用(Button.java:169-170)、33 个*Peer接口、sun/awt/X11/下 36 个与sun/lwawt/下 18 个实现、SunToolkit在:111-112上implements ComponentFactory Charset/CharsetDecoder与Driver/Connection是工厂关系,不是桥接:两个维度之间没有一个可以独立增减取值的引用
参考资料
- Bridge(GoF 模式目录条目)
- Component (Java SE 25)
- ComponentPeer (Java SE 25)
- ButtonPeer (Java SE 25)
- Toolkit (Java SE 25)
- Charset (Java SE 25)
- java.sql.Driver (Java SE 25)
- HotSpot 的虚调用与内联缓存
系列索引:设计模式系列