设计模式——装饰器:缓冲链的代价
装饰器把「给一个对象加能力」变成了廉价操作:
new BufferedInputStream(new FileInputStream(f))只是多写一层。
但每一层都会改写下层被调用的形态——调用次数、每次的块大小、flush 与 close 的语义。这些改动在源码里看不到,只能测。
本文用一个 48 MiB 文件、libc 层的真实read(2)计数,和两个 JDK(21.0.8 与 25)回答一个问题:这条链上多包一层,到底买到了什么,代价在哪。
一、装饰器换到的东西
继承式的算术
给一个数据源加「缓冲」和「校验」两种能力。如果用继承,每多一种能力就要多一层子类,而两种能力的叠加顺序又各自是一个类:
    classDiagram
    direction TB
    class FileDataSource
    class BufferedFile
    class ChecksumFile
    class BufferedChecksumFile
    class ChecksumBufferedFile
    FileDataSource <|-- BufferedFile
    FileDataSource <|-- ChecksumFile
    FileDataSource <|-- BufferedChecksumFile
    FileDataSource <|-- ChecksumBufferedFile
    note for BufferedFile "NetDataSource 一侧还要原样再写一遍,合计 2 + 8 = 10 个类"
2 种能力 × 2 种数据源 = 10 个类(每种数据源 1 个基类 + 4 个组合)。再加一种能力,每种数据源涨到 16 个,两种数据源 32 个。
装饰式的算术
装饰器把「能力」从「数据源」里拆出来,做成 holds-a 而不是 is-a。能力类是包装器,包装对象是它自己实现的同一个接口:
    classDiagram
    direction TB
    class DataSource {
        +read()
    }
    class FileDataSource
    class NetDataSource
    class DataSourceDecorator {
        #DataSource inner
        +read()
    }
    class Buffered
    class Checksum
    DataSource <|.. FileDataSource
    DataSource <|.. NetDataSource
    DataSource <|.. DataSourceDecorator
    DataSourceDecorator <|-- Buffered
    DataSourceDecorator <|-- Checksum
4 个类,覆盖全部组合,顺序任意。
JDK 自己就是这么做决定的
在 JDK 25 的 src.zip 里对全部 14,671 个 .java 文件按 extends 统计:
| 写法 | 命中文件数 | 例子 |
|---|---|---|
extends FilterInputStream |
20 | BufferedInputStream、CheckedInputStream、DigestInputStream、InflaterInputStream、DataInputStream、PushbackInputStream |
extends FilterOutputStream |
19 | BufferedOutputStream、CheckedOutputStream、DeflaterOutputStream、PrintStream |
extends FileInputStream / extends FileOutputStream |
2(共 4 个内部类) | 只在 java.lang.System 与 java.lang.Process 里,是 System.in、Process 管道这类替换 fd 的场景,不是叠加能力 |
给字节流叠加能力这件事,JDK 自己做成了 39 个装饰器,几乎不做成 FileInputStream 的子类。这是上面那张类图的算术结果。
二、IO 链的层次
一条真实的读链通常长这样。注意每一层给下层发出的请求大小并不一样:
    graph TD
    APP["应用代码 readLine"] -->|"每行一次调用"| BR["BufferedReader 8192 字符"]
    BR -->|"需要更多字符"| ISR["InputStreamReader 按字符集解码"]
    ISR -->|"每次 1 到 8 字节"| DIS["DataInputStream"]
    DIS -->|"每次 1 到 8 字节"| GZ["GZIPInputStream 内部 512 字节填充"]
    GZ -->|"in.read(buf, 0, 512)"| BIS["BufferedInputStream 8192 字节"]
    BIS -->|"in.read(buf, 0, 8192)"| FIS["FileInputStream"]
    FIS -->|"read(2)"| KERNEL["内核页缓存"]
| 层 | 代表类 | 它改写了什么 |
|---|---|---|
| 字节源 | FileInputStream、SocketInputStream |
决定数据从哪来,直接产生系统调用 |
| 缓冲 | BufferedInputStream |
把下层的多次小读合并成一次大读 |
| 基本类型 | DataInputStream |
把字节组装成 int、long、UTF 字符串 |
| 压缩 | GZIPInputStream |
把压缩字节变成原始字节,自己有 512 字节输入缓冲 |
| 校验 | CheckedInputStream、DigestInputStream |
旁路计算,不改数据 |
| 字符集 | InputStreamReader |
字节到字符,引入编码状态 |
| 文本 | BufferedReader |
按行切分,再叠一层字符缓冲 |
8192 是从哪来的
BufferedInputStream 的默认缓冲是 8192 字节,两个 JDK 都一样:
- JDK 21:
java.base/java/io/BufferedInputStream.java:58,private static final int DEFAULT_BUFFER_SIZE = 8192; - JDK 25:同文件
:62,同一行代码 - 无参构造直接转调带 size 的构造:JDK 21
:218-219、JDK 25:219-220,this(in, DEFAULT_BUFFER_SIZE)
javadoc 没有解释这个数字的来源。能验证的只有它和硬件常数的关系:本机 APFS 的块大小是 4096 字节(stat -f %k 输出 4096),虚拟内存页是 16384 字节(pagesize 输出 16384)。8192 各是它们的两倍和一半,正好夹在中间。
512 和 8192 的冲突
GZIPInputStream 的默认输入缓冲是 512 字节,不是 8192:
- JDK 21:
java.util.zip/GZIPInputStream.java:90-91,this(in, 512) - JDK 25:同文件
:113-114,同样this(in, 512) - 这个 size 一路传到
InflaterInputStream:JDK 21:89、JDK 25:111,buf = new byte[size] - 而
fill()只做一件事——用这个 512 字节的数组向下层要数据:JDK 21InflaterInputStream.java:262-264、JDK 25:306-308,len = in.read(buf, 0, buf.length)
所以一个 GZIPInputStream 会给它的下层发出每 512 字节一次的读请求。这是第四节所有现象的根源。
三、实测一:逐字节读 48 MiB
测量方法
- 文件:48 MiB = 50,331,648 字节,放在 APFS 卷上
- 机器:Apple M1 Pro,macOS Darwin 25.6.0
- JDK:
21.0.8+12-LTS-250与25+37-LTS-3491,都是 arm64 - 每轮新起一个 JVM,先在临时小文件上跑一遍预热(结果丢弃),再对目标文件计时一次;跑 3 轮取中位数
- 本机没有 JMH。这是单机微基准,只用来判断量级,不能当成硬件上限
系统调用计数怎么拿到
macOS 上 dtruss -c 会直接失败:
1 | $ sudo dtruss -c java -cp out Hello |
fs_usage 能跑,但输出是系统级事件流,按进程过滤短命 JVM 不现实。
换一条路:把计数放在 libc 边界上。写一个 dylib,在 __DATA,__interpose 段里替换 read、pread、write、open、close,用 DYLD_INSERT_LIBRARIES 注入 JVM。这样每次被替换的函数调用就是一次真实的系统调用,按 fd 归因到打开的文件路径上:
1 | ssize_t read(int fd, void *buf, size_t n); |
这是 libc 层的用户态计数。它可信的理由是能交叉验证:read(byte[8192]) 读 48 MiB,libc 层计到 6145 次,同时 Java 用户态计数也是 6145 次。50331648 除以 8192 正好是 6144,加上最后一次读到 EOF 的那一回,两个数对得上。
结果
| 读法 | JDK 21 中位数 | JDK 25 中位数 | read(2) 次数 | Java 层 read 调用 |
|---|---|---|---|---|
裸 FileInputStream 逐字节 |
25,486 ms | 25,515 ms | 50,331,649 | 50,331,649 |
BufferedInputStream 逐字节 |
695 ms | 474 ms | 6,145 | 50,331,649 |
裸 FileInputStream + read(byte[8192]) |
16 ms | 17 ms | 6,145 | 6,145 |
BufferedInputStream + read(byte[8192]) |
17 ms | 16 ms | 6,145 | 6,145 |
双层 BufferedInputStream 逐字节 |
667 ms | 503 ms | 6,145 | 50,331,649 |
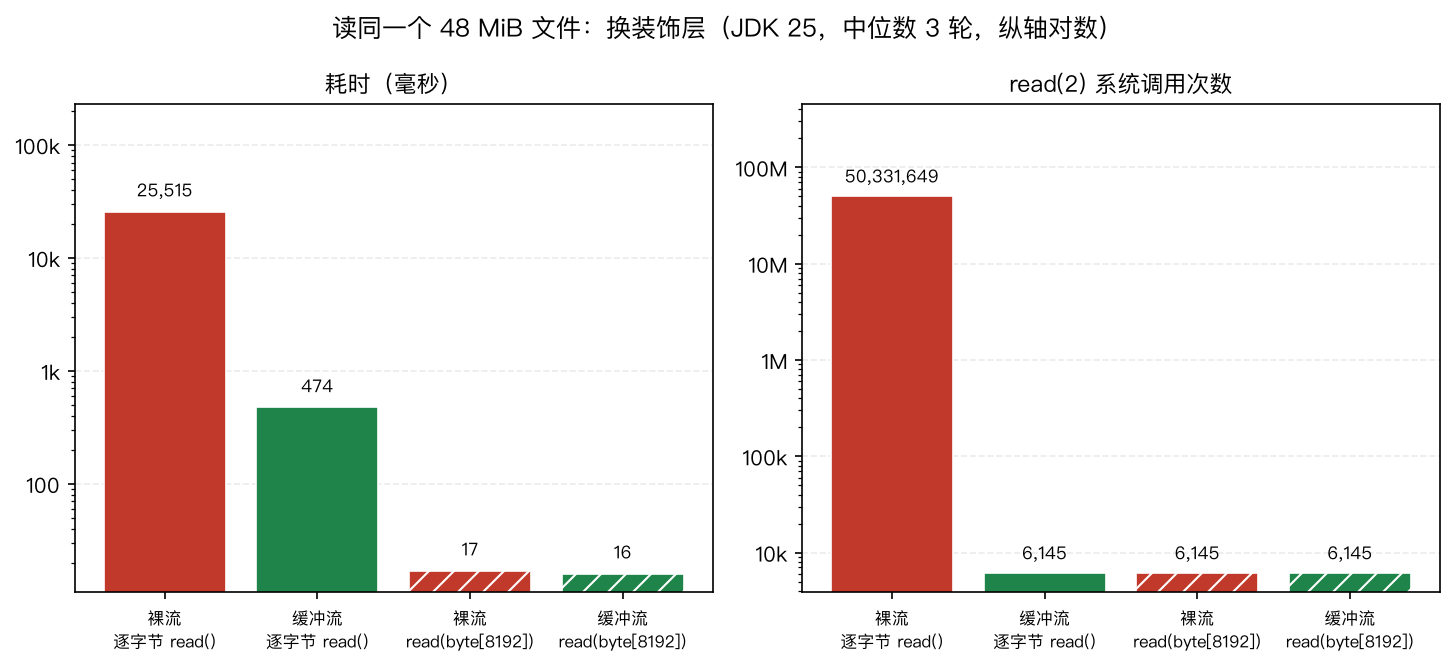
第一行和第三行是同一份数据、同一个进程,只差一个「怎么读」:25.5 秒 对 17 毫秒。系统调用次数差约 8190 倍,时间差 1499 倍。这是装饰器买到的量级。
两个反直觉的数字
一、消费端已经按大块读时,这一层测不出收益。 第三行和第四行差 1ms,而且符号在两个 JDK 之间是反的:JDK 21 是 16ms 对 17ms(加了更慢),JDK 25 是 17ms 对 16ms(加了更快)。1ms 贴着本次测量的分辨力,不能据此断言加了会更快或更慢。能确定的是源码里的两条事实,JDK 21 BufferedInputStream.java:336-345、JDK 25 :319-328:
1 | /* If the requested length is at least as large as the buffer, and |
请求长度不小于缓冲长度时,直接透传,不复制。付出的是每次调用一次加锁和一层虚调用。
二、JDK 21 上,把 BufferedInputStream 子类化反而更快。 逐字节读:695ms(直接用)对 521ms(子类化后),后者快 25%。这违反「子类化会掉出快速路径」的直觉,原因在构造函数里,JDK 21 BufferedInputStream.java:240-248:
1 | initialSize = size; |
getClass() == BufferedInputStream.class 为真时走 jdk.internal.misc.InternalLock(内部是 ReentrantLock),为假时退回普通 monitor。做 A/B 验证:JDK 21 加 -Djdk.io.useMonitors=true(这个属性会让 InternalLock.newLockOrNull() 返回 null,InternalLock.java:39-47)之后,同一个逐字节读法从 687ms 掉到 503ms,正好落到子类化那条路径上;JDK 25 上这个开关没有任何作用(479ms 对 477ms)。
因为 InternalLock 已经在 JDK 24 被删掉。JDK-8343039「Remove jdk.internal.misc.InternalLock and usages from java.io」,Fix Version 24,描述里写着 JEP 491 集成之后就可以把 java.io 改回统一的 synchronized。所以 JDK 21 的 src.zip 里有 jdk/internal/misc/InternalLock.java,JDK 25 的没有,javap --module java.base jdk.internal.misc.InternalLock 在 25 上直接报「找不到类」。
结论不必记成「JDK 21 慢」:这条分支只影响逐字节读这种极端场景,而且方向是反的。别假设 JDK 内部对 BufferedInputStream 的策略在两个 LTS 之间不变。
缓冲调多大才有用
把 bufferSize 从 64 字节扫到 1 MiB,逐字节消费,量出 syscall 次数和耗时:
| bufferSize | read(2) 次数 | JDK 21 耗时 | JDK 25 耗时 |
|---|---|---|---|
| 64 | 786,433 | 1,164 ms | 934 ms |
| 512 | 98,305 | 736 ms | 512 ms |
| 1 KiB | 49,153 | 710 ms | 483 ms |
| 4 KiB | 12,289 | 685 ms | 461 ms |
| 8 KiB(默认) | 6,145 | 677 ms | 476 ms |
| 64 KiB | 769 | 667 ms | 463 ms |
| 256 KiB | 193 | 656 ms | 457 ms |
| 1 MiB | 49 | 654 ms | 456 ms |
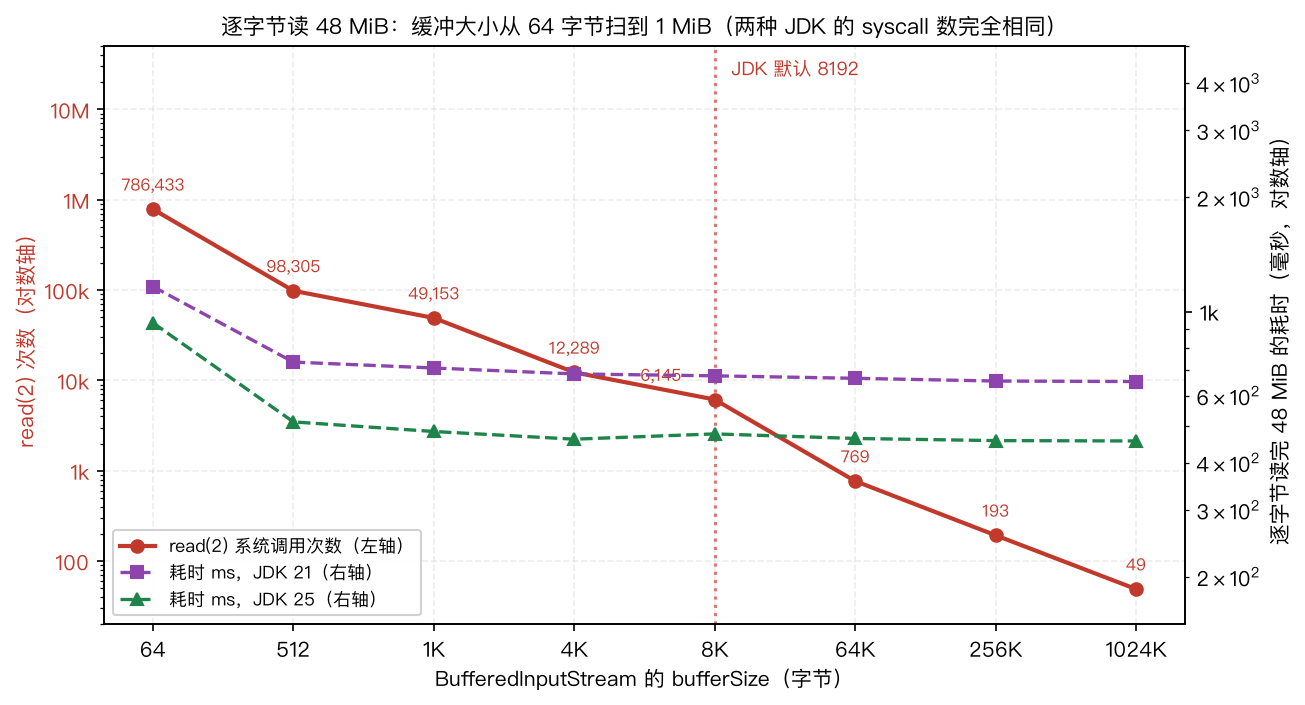
从 64 字节到 8192,syscall 数量降了 128 倍,耗时只降了 1.7 倍。从 8192 再到 1 MiB,syscall 又降 125 倍,耗时只降 3%。8192 已经在收益曲线的拐点右侧,调大它只是在 syscall 计数上好看。
这条曲线的形状也说明「一次系统调用值多少时间」:JDK 21 上 64 字节方案比 8 KiB 方案多出 780,288 次系统调用,多花 487ms,约 0.62 微秒一次。同一次实验里 JDK 25 的数换算是 0.59 微秒。这个量级只在系统调用次数上到百万级时才值钱。
四、实测二:同一份压缩数据,缓冲层放哪一层
数据
48 MiB 不可压缩数据(/dev/urandom 拼出来的),用 gzip -1 压成 50,346,969 字节——比原文件还大一点。所有解压结果都校验过 CRC32 = 1647031944,与原始文件一致,确认没有读错。
缓冲层的位置决定系统调用粒度
    graph TD
    APP["应用代码 read 或 readLine"] --> GZ["GZIPInputStream 每 512 字节向下层要一次数据"]
    GZ -->|"缓冲垫在下面"| GOOD["BufferedInputStream 把 512 字节的请求攒成 8192"]
    GOOD -->|"read(2) 共 6146 次"| FILE["FileInputStream"]
    GZ -->|"缓冲垫在上面"| BAD["BufferedInputStream 收不到那些 512 字节的请求"]
    BAD -->|"512 字节原样透传,read(2) 共 98347 次"| FILE
| 组合 | JDK 21 | JDK 25 | read(2) 次数 |
|---|---|---|---|
GZIPInputStream(FileInputStream) 无缓冲 |
108 ms | 108 ms | 98,347 |
BufferedInputStream(GZIPInputStream(FileInputStream)) 缓冲在外 |
123 ms | 125 ms | 98,347 |
GZIPInputStream(BufferedInputStream(FileInputStream)) 缓冲在内 |
64 ms | 63 ms | 6,146 |
| 两层都加 | 75 ms | 73 ms | 6,146 |
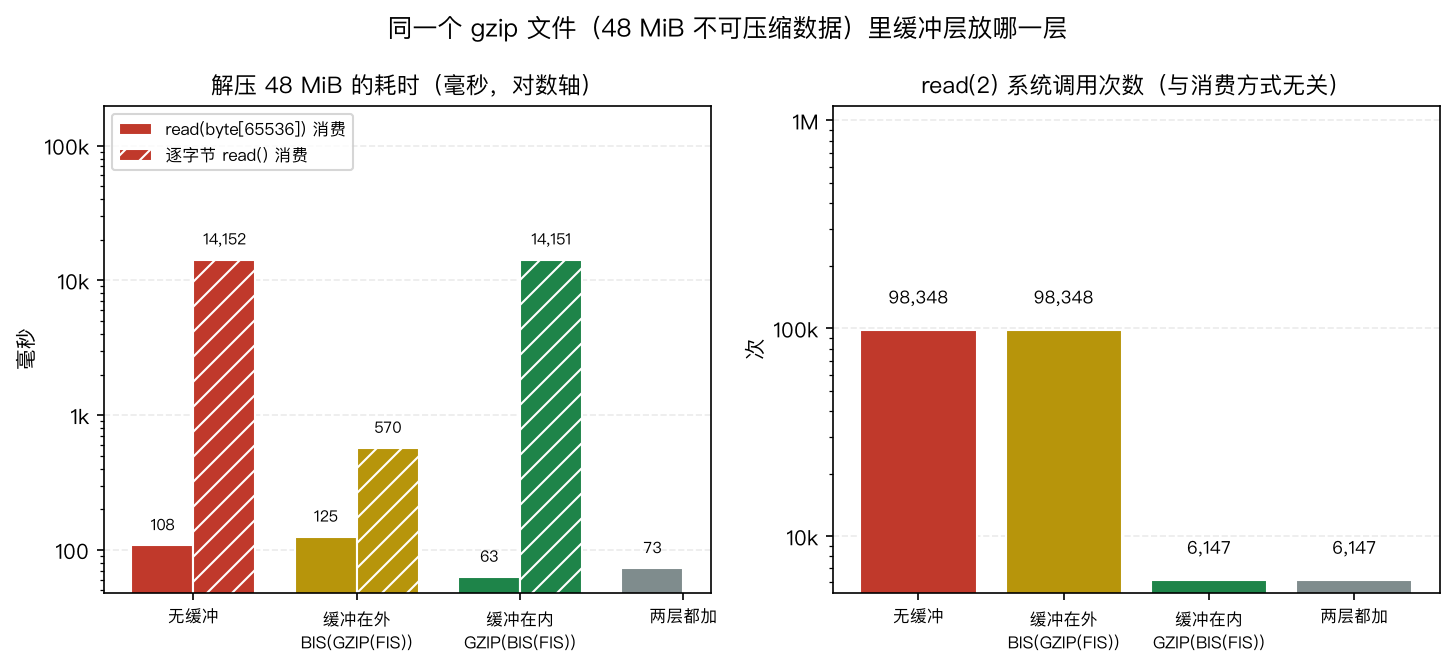
缓冲在外的那一层,一次系统调用都没省下来。 98,347 次与不缓冲时一模一样,还慢了 15ms 到 17ms——多出的是一次加锁和一层转发。
原因是小读请求来自更内层的 GZIPInputStream。它在 fill() 里向下层要 512 字节,这个请求到不了外层的 BufferedInputStream;外层收到的反而是应用发出的大请求,按 read1 的透传分支又原样交下去了。外层缓冲唯一能省的,是它自己到下层的 Java 层调用次数。
把缓冲垫在解压层下面,512 字节的请求被 8192 字节的缓冲吸收,syscall 从 98,347 降到 6,146,时间减半。
顺序对错还取决于消费端
同一组流,把消费方式换成逐字节 read(),结论就反过来了:
| 组合 | JDK 21 | JDK 25 | read(2) 次数 |
|---|---|---|---|
| 无缓冲 | 13,991 ms | 14,152 ms | 98,347 |
| 缓冲在外 | 819 ms | 570 ms | 98,347 |
| 缓冲在内 | 13,934 ms | 14,151 ms | 6,146 |
消费端逐字节读时,缓冲放在内层省不到时间:read(2) 次数确实降到了 6,146,但每次 read() 都直接穿过 GZIPInputStream,触发一次 1 字节的 inflate 调用,48 MiB 就是 5000 万次,瓶颈从系统调用换成了 inflate 本身。缓冲在外则把这些调用挡在 8192 字节的缓冲里:每次填满外层缓冲只需要约 16 次内层调用,48 MiB 数据的内层 inflate 调用从 4800 万次降到约 9.8 万次(这个数正好等于上表里的 98,347 次 read(2),因为每次 fill() 读进 512 字节压缩数据,inflate 就产出约 511 字节)。
所以「哪个顺序对」没有唯一答案,取决于谁在产生小请求:
    graph TD
    S["谁发出小读请求"] --> G1["解压层在填充它的 512 字节缓冲"]
    S --> G2["应用按字节或按行消费"]
    G1 --> A1["把缓冲垫在解压层下面:GZIP(BIS(FIS))"]
    G2 --> A2["把缓冲垫在解压层上面:BIS(GZIP(FIS))"]
    A1 --> R1["syscall 从 98347 降到 6146"]
    A2 --> R2["内层 inflate 调用从 4800 万次降到约 9.8 万次"]
flush 不是一条链上统一的语义
多层装饰之后,flush() 到底保证什么,要逐层查。把 64 KiB 可压缩数据写进不同嵌套的流,每次只 flush() 不 close(),再用 gunzip -t 验证:
| 写法 | flush 后文件大小 | gunzip -t |
|---|---|---|
GZIPOutputStream(fos) + flush() |
10 字节 | 失败 |
GZIPOutputStream(fos) + close() |
799 字节 | 通过 |
BufferedOutputStream(GZIPOutputStream(fos)) + flush() |
10 字节 | 失败 |
BufferedOutputStream(GZIPOutputStream(fos)) + close() |
799 字节 | 通过 |
GZIPOutputStream(BufferedOutputStream(fos)) + flush() |
10 字节 | 失败 |
GZIPOutputStream(BufferedOutputStream(fos)) + close() |
799 字节 | 通过 |
GZIPOutputStream(fos, 8192, syncFlush=true) + flush() |
795 字节 | 失败 |
10 字节就是 gzip 的文件头。三种嵌套顺序里,flush() 后的文件大小一样——缓冲层放在哪一侧,对这件事没有任何影响。决定它的是压缩层:GZIPOutputStream 默认 syncFlush=false,flush() 只是把调用转给下层,不产出任何压缩数据。只有把 syncFlush 打开,数据才会被吐出来,但 CRC 和长度这两项 trailer 仍然要等 finish()。
反过来,BufferedOutputStream 的 flush() 会级联调用下层的 flush(),所以两层缓冲嵌套时 flush() 能把数据一路推到底。会卡住你的是链上某一层的 flush() 语义和你的预期不符——这件事跟包了几层无关,跟包了哪一层有关。
BufferedOutputStream 的滞留窗口
BufferedOutputStream 写多少字节才落盘,取决于单次写入的大小:
单次 write |
不 flush 时文件大小 | 说明 |
|---|---|---|
| 100 字节 | 0 | 全文滞留 |
| 8191 字节 | 0 | 全文滞留 |
| 8192 字节 | 8192 | 单次写入不小于缓冲,直接穿透 |
| 8193 字节 | 8193 | 同上 |
100 字节 + flush() |
100 | flush 推给下层 |
穿透的判断是 if (len >= maxBufSize),JDK 21 在 BufferedOutputStream.java:212,JDK 25 在 :178,注释同样是 “buffered streams will cascade harmlessly”。
写 200,000 次单字节,两种写法在系统调用层面的差别:
| 写法 | 耗时 | write(2) 次数 | 未 flush 时磁盘上的字节数 |
|---|---|---|---|
FileOutputStream |
371 ms | 200,000 | 200,000 |
BufferedOutputStream |
7 ms | 25 | 196,608(滞留 3,392) |
196,608 正好是 24 个 8192,剩下的 3,392 还在缓冲里。这就是「忘记 flush」丢掉的量:最后一次没写满的那部分。
虚拟线程上的输出缓冲
new BufferedOutputStream(out) 拿到的初始缓冲,在平台线程和虚拟线程上不一样:
- JDK 21 与 JDK 25 的
BufferedOutputStream.java都有DEFAULT_INITIAL_BUFFER_SIZE = 512(21 在:42,25 在:46) - 无参构造调
initialBufferSize()(JDK 25:70-76):Thread.currentThread().isVirtual()为真时返回 512,否则返回DEFAULT_MAX_BUFFER_SIZE= 8192 - 用反射读
buf.length验证(需要--add-opens java.base/java.io=ALL-UNNAMED):平台线程 8192,虚拟线程 512,显式传 size 时两条路径都是 8192。两个 JDK 结果一致
缓冲可以增长到 maxBufSize,所以这个差异不会改变文件可见的 flush 时机,只影响初始分配。同一个构造调用,在不同执行环境下拿到的东西可能不同。
五、实测三:装饰器与继承的对照
同一组能力,CRC32 校验和 + 读取次数统计,两种写法各实现一遍。装饰器版是两个类:
1 | static final class CountingInputStream extends FilterInputStream { |
继承版要为每种顺序各写一个类,类的基类是 FileInputStream:
1 | static class CountingChecksumFileInputStream extends ChecksumFileInputStream { |
结果
| 实现 | 类数 | 有效代码行 | crc | readCalls |
|---|---|---|---|---|
| 装饰器 校验在外 / 计数在内 | 2 | 16 | 1647031944 | 6,145 |
| 装饰器 计数在外 / 校验在内 | 2 | 16 | 1647031944 | 6,145 |
| 继承 先校验后计数 | 3 | 26 | 1647031944 | 6,145 |
| 继承 先计数后校验 | 3 | 26 | 1647031944 | 6,145 |
| 装饰器 套在 GZIP 解压流上 | 复用 | 0 | 1647031944 | 98,335 |
| 装饰器 套在 15 字节小文件上 | 复用 | 0 | 2988202360 | 2 |
四种实现的结果一致,校验和与调用次数都对得上,说明两种写法在语义上等价。差别在别的地方。
代码行数不能说明问题:26 行对 16 行只是 1.6 倍。差别在复用维度。装饰器那 2 个类可以套在 FileInputStream、GZIPInputStream、ByteArrayInputStream、任何 InputStream 上,顺序随便换,结果一致——表里最后两行就是没写任何新代码套上去的。继承版那 3 个类只能读文件,顺序是编译期定死的,想套到解压流上要重写一遍。
类数量的增长方式才是要害,而且要把顺序算进去——第四节已经证明顺序不是自由选择。2 种能力:继承要 3 个类(补齐「只计数不校验」那种是 4 个),装饰器 2 个。3 种能力:继承要 15 个(3 种单能力 + 6 种两两组合 × 2 个顺序 + 6 种三能力全排列),装饰器 3 个。再把数据源当成一个维度:装饰器不增加任何类,继承是每个组合一个新类。
六、结论
收益是量级差
三组实验里最大的收益都来自同一个机制:把系统调用次数从百万量级降到千量级。同样逐字节读 48 MiB,从 50,331,649 次降到 6,145 次,时间从 25.5 秒降到 474 毫秒(JDK 25);换一种读法,裸流自己按 8192 字节读只要 17 毫秒。压缩流从 98,347 次降到 6,146 次,时间减半。这种收益不需要精细测量就能看出来。
代价是可测的三条
一是一层间接。这一条只在能被测出来的地方成立:gzip 缓冲在外时,多出的转发与加锁稳定地值 15ms 到 17ms,两个 JDK 上方向一致。消费端本来就按大块读时,加与不加的差落在 1ms 内、符号还在两个 JDK 之间翻转,属于测不出来而不是没有成本。
二是顺序耦合。缓冲层放错位置,16 倍的 syscall 差会整个消失;消费模式一换,谁对谁错还会反转。装饰器让「加一层」变便宜,也就让「加错一层」变便宜——编译器不会报错,接口也匹配。
三是生命周期语义要逐层查。flush() 在 BufferedOutputStream 上是「推给下层」,在 GZIPOutputStream 上是「什么也不做」。close() 会传播,但传播的是调用,不是保证。
什么时候自己写装饰器
满足这两个条件时,装饰器是正解:
- 这个能力是横切的,和具体数据源无关——计数、校验、限流、审计、重试。
- 它的正确实现只需要覆写一两个方法,
read(byte[], int, int)加上read()基本够了。
上面那 2 个类一共 16 行,就换来了任意顺序、任意数据源的组合能力。这个投入产出比很难被别的写法超过。
什么时候不用
- 不需要保持接口时,一次函数调用更简单。
in.transferTo(out)、in.readAllBytes()、Files.copy都是一次调用,不用包一层。装饰器的前提是调用方坚持要InputStream这个类型。 - 消费端本来就按大块读时,先量再包。 第三节第三行与第四行差 1ms 且符号不定,就是这个场景:这一层在这个用法下没有可测收益,别默认它会加速。
- 想调缓冲大小时,先看拐点。 8192 已经过了拐点,改到 1 MiB 换回 3% 的时间,代价是每线程多占 1 MiB 内存。并发 1000 个连接就是 1 GiB。
一条判断顺序
先问「谁产生小读请求」,把缓冲垫在它下面;再问「谁负责收尾」,把 close() 放在最外层;最后问「链上哪一层的 flush() 会真的吐出数据」,如果答案是「没有」或者「不确定」,就换成先写完整再交付,而不是指望中途 flush()。
总结
- 装饰器解决的是组合爆炸:2 种能力 × 2 种数据源在继承下要 10 个类,装饰器要 4 个。JDK 25 源码里 39 个类用
extends Filter*Stream给字节流加能力,只有 2 个文件用extends FileInputStream,且用途是替换 fd。 BufferedInputStream默认 8192 字节(JDK 21BufferedInputStream.java:58,JDK 25:62);GZIPInputStream默认 512 字节(JDK 21GZIPInputStream.java:90-91,JDK 25:113-114)。这两个数字的差别决定了缓冲层该放哪。- 48 MiB 逐字节读:裸流 25.5 秒 / 50,331,649 次
read(2),缓冲流 474ms / 6,145 次。量级差来自系统调用次数。 - 消费端按大块读时,加不加
BufferedInputStream的耗时差在 1ms 内、符号在两个 JDK 之间翻转(JDK 21 加更慢,JDK 25 加更快),按本次测量的分辨力区分不出来。 BufferedInputStream(GZIPInputStream(FileInputStream))的 syscall 次数与不缓冲时相同,且慢 15ms。缓冲要垫在发出小请求的那一层下面。- 消费端改逐字节读,两个顺序的优劣反转:缓冲在外 570ms,缓冲在内 14,151ms。
flush()不是统一语义:GZIPOutputStream默认syncFlush=false时flush()后文件只有 10 字节的 gzip 头,gunzip -t失败;缓冲层的位置影响不了这一点。- 200,000 次单字节写在裸流上是 200,000 次
write(2),缓冲后是 25 次;忘记 flush 滞留的是最后一次没写满的部分(3,392 字节),不是 8192。 - JDK 21 的
BufferedInputStream对非子类用InternalLock,子类用 monitor;A/B 差了 184ms(687ms 对 503ms)。InternalLock已在 JDK 24 随 JDK-8343039 删除,JDK 25 上同一个开关无效。
参考资料
- BufferedInputStream (Java SE 25)
- BufferedInputStream (Java SE 21)
- BufferedOutputStream (Java SE 25)
- FilterInputStream (Java SE 25)
- InputStream (Java SE 25)
- java.io 包说明
- GZIPInputStream (Java SE 25)
- InflaterInputStream (Java SE 25)
- DeflaterOutputStream (Java SE 25)
- JDK-8343039: Remove jdk.internal.misc.InternalLock and usages from java.io
- JEP 491: Synchronize Virtual Threads without Pinning
系列索引:设计模式系列