设计模式——原型:拷贝的四条路
原型模式只解决一件事:让一个对象复制出第二个实例。JDK 从 1.0 起就提供了
Object.clone(),它的签名到今天没动过。
它的默认语义只有逐字段赋值:字段里的数组、集合、嵌套对象在副本里仍是原来那几个。
本文用一个含嵌套数组与集合的对象图,把四条拷贝路各跑 100 万个,量耗时与分配字节,浅拷贝还是深拷贝由运行时的布尔结果给出。
一、原型换到的东西
new 的成本有时花在构造器之前:参数要从十个数据源拼出来,或者对象的形状取决于启动阶段读到的配置。原型模式的前提是手上已经有一个配好的对象,接下来只剩复制。
JDK 自己的四个样本
JDK 里几处需要「拿到一个和现有对象一样的新对象」的地方,做法各不相同:
| 位置 | 复制动作 | 嵌套引用 |
|---|---|---|
Object#clone |
VM 内建,逐字段赋值 | 原样带走 |
ArrayList#clone |
super.clone() 后 Arrays.copyOf(elementData, size) |
原样带走 |
Arrays.copyOf |
基本类型走 arraycopy,引用类型逐元素赋值 |
原样带走 |
HashMap 拷贝构造 |
逐条 putVal(hash(key), key, value, false, evict) |
原样带走 |
前三行是内存搬运:数组一旦有了长度,复制就是一次块拷贝。散列表的形状由哈希决定,第四行做不到块拷贝,只能把条目重新插一遍。四个样本在最后一列上一致:被引用的成员对象都不复制。
原型模式的坑全在这一列上。后面测的四条路,区别只在「谁在什么时机把那层引用换成新对象」。
复制与重新构造的分界
同一个需求可以用原型做,也可以用建造者做。给配置对象加一位超时参数:原型是 src.withTimeout(30),内部复制后改一个字段;建造者是 builder.timeout(30).build(),从头把必填项再走一遍(见 建造者模式)。前者的前提是源对象已经在手上,且它的其余字段不可变或可安全共享;后者不需要源对象,但要求每个参数都能重新算出来。
JDK 里 LocalDate.plusDays、Instant.plusSeconds、String.substring(JDK 7u6 之后)都属于前一类:返回新实例,原实例不动。这些类的字段全不可变,所以「复制」退化成「新对象 + 原引用」,不存在深度问题。
和备忘录的分界
原型交出来的副本要能独立使用:调用方会继续读它、继续改它。备忘录保存的是能回到过去的快照,份数和生命周期由调用方管(见 备忘录模式)。两者都涉及复制状态,判断标准是副本的用途:要参与后续业务的是原型,只用来恢复状态的是备忘录。
注册表:把模板集中起来
原型模式常见的落地形态是一张注册表:
1 | Map<String, Order> templates = new HashMap<>(); |
注册表里放的是模板对象,每次取用都复制一份。它的边界在享元那一侧:享元共享的是不可变对象,多个使用者拿到的是同一个实例(见 享元模式);注册表共享模板,发出去的是副本,每个使用者改自己的那份。判断标准是「改完之后要不要互相看见」:要,就共享同一个实例;不要,就发一份副本。
注册表实现里最容易出错的地方是 register 存进去的引用。存完模板之后如果调用方又改了原对象,模板跟着变;create 返回的副本如果浅拷贝,改副本会反过来改模板。这两个方向都得自己防。
    flowchart TB
    S["src:Order 实例"] --> F1["id / amount<br/>标量字段"]
    S --> F2["int[] quantities"]
    S --> F3["List tags"]
    S --> F4["Map counts"]
    S --> F5["Address address"]
    S --> F6["Item[] items"]
    P1["Object.clone()"] --> R1["新 Order<br/>六个字段全指向原节点"]
    P2["new Order(src)"] --> R2["新 Order + 新 int[]/List/Map<br/>address 与 items 元素共享"]
    P3["src.deepCopy()"] --> R3["新 Order + 全部嵌套节点"]
    P4["序列化往返"] --> R4["新 Order + 全部嵌套节点<br/>另加约 20 KB 流水线"]
    S -.复制.-> P1
    S -.复制.-> P2
    S -.复制.-> P3
    S -.复制.-> P4
二、实验设计
对象图
    classDiagram
    class Order {
      String id
      long amount
      int[] quantities
      List~String~ tags
      Map~String,Integer~ counts
      Address address
      Item[] items
    }
    class Address {
      String city
      String street
      String zip
    }
    class Item {
      String sku
      int qty
      long price
    }
    Order *-- Address
    Order *-- Item
1 | static final class Order implements Cloneable, Serializable { |
两个嵌套类同样实现 Cloneable 与 Serializable。这张图同时覆盖三种可变嵌套:数组、集合、对象。
四条路
1 | // 路 1:Object.clone,JDK 的默认语义 |
另外补一条对照:clone() 之后手工把六个字段换成新对象(下面记作「clone + 补深」)。它的深度与路 3 相同,用来把「机制」和「深度」分开:同样是深拷贝,一边是一次 VM 级复制加五次字段替换,另一边是一次构造器调用加八次分配。
怎么量
分配字节用 com.sun.management.ThreadMXBean.getCurrentThreadAllocatedBytes(),取一个长循环前后的差值除以次数。这份计数来自线程的分配统计,不受 CPU 争用影响。
耗时每轮 100 万次,热身后测 3 轮,取中位数,同时记录最小值。计时循环跑在全局文件锁里,同一时刻只有一个进程在抢 CPU。
副本要写进一个静态字段再消费。拷贝的用途就是让副本留下来继续用;不写出去,C2 的逃逸分析会把整个副本消掉,测出来的就不是拷贝的成本。这一点有对照组:副本不出循环时,clone 在稳定轮里的分配是 0.0 B/次。
每个变体有独立的测量循环,调用点单态。四条路如果共用一个接口或一个 lambda 调用点,调用点会变成 megamorphic,JIT 不再内联,快的路会被拖慢,这会直接污染结论。
空转基线单独测一行:只读源对象的字段、不拷贝,实测 0.0 B/次,说明消费动作本身不产生分配。
两个 JDK:21.0.8 与 25,都是 -Xmx2g,同一台 M1 Pro(arm64)。原始输出留在 /tmp/pattern-runs/Prototype.log,含每轮的毫秒数、GC 次数与 getThreadAllocatedBytes 的原始差值。
局限
这是手写脚手架,不是 JMH。数字只用来分档,结论只建立在量级上。耗时包含 GC 时间(每轮的 GC 次数在日志里,可以核对),所以中位数和最小值一起给出。对象图是中等规模(深拷贝一次 600 B),换成很大的图,序列化那一列的比例会变,其余三列的相对关系不变。
三、实测一:哪个是浅拷贝
方法:每一种写法都从一个全新的源对象开始,先比对副本与原对象的字段值,再用副本改七个位置,回头看原对象有没有被改到。
| 路径 | 值一致 | id | amount | int[] | List | Map | Address | Item[]元素 |
|---|---|---|---|---|---|---|---|---|
Object.clone |
true | 独立 | 独立 | 泄漏 | 泄漏 | 泄漏 | 泄漏 | 泄漏 |
| 拷贝构造 | true | 独立 | 独立 | 独立 | 独立 | 独立 | 泄漏 | 泄漏 |
手写 deepCopy() |
true | 独立 | 独立 | 独立 | 独立 | 独立 | 独立 | 独立 |
| clone + 补深 | true | 独立 | 独立 | 独立 | 独立 | 独立 | 独立 | 独立 |
| 序列化往返 | true | 独立 | 独立 | 独立 | 独立 | 独立 | 独立 | 独立 |
(「泄漏」= 改副本改到了原对象。两个 JDK 上逐格相同。)
五行里有两处陷阱,位置不同。
第一处是 Object.clone:七个位置全泄漏。javadoc 的原文写得很直白:performs a "shallow copy" of this object, not a "deep copy" operation。
第二处是拷贝构造。它照着 JDK 集合的写法重建了数组、List、Map,却把 address 与 items 的元素按引用带走。危险在于这一行长得最像对的:改副本的 List 不动源对象,改副本的 items[0].sku 动。写单测时如果只验 List,这条路的 bug 会一直躺着。
第 4 行说明机制本身不妨碍深拷贝:clone 补深之后全独立,「VM 快照 + 五次字段替换」同样能给出完整的深拷贝。
深度是逐字段决定的
一个对象图里每个可变字段各有一档深度。「这个类是不是深拷贝」这种问法没有答案:Order 的五个嵌套字段可以各自选,quantities.clone() 要复制,address 共享也行(前提是 Address 不可变)。判据落在字段上。
Object.clone 的 javadoc 给的建议与此一致:如果类里只有基本类型字段或不可变对象的引用,super.clone() 之后一个字段都不用改;否则要把构成内部深结构的可变对象复制一遍再换掉引用。这段文字的语气像建议,内容是唯一的正确用法。
把这套判据落到 Order 上,五个嵌套字段各自有答案:
| 字段 | 判据 | 决定 |
|---|---|---|
quantities |
副本要能独立改数量 | clone() |
tags |
副本要能加减标签 | new ArrayList<>() |
counts |
同一份计数不会跨副本共享 | new HashMap<>() |
address |
订单地址随副本走,但地址对象没人单独改 | 共享 |
items |
元素里的数量会被副本改 | 逐元素 new Item() |
五个字段里四个复制、一个共享,这就是这份对象图的「深度」。任何一句「Order 是深拷贝」都没法表达这个分布。表里第二列才是要维护的东西:共享的前提写在业务上,代码里看不出来,值得写进注释。
再往下还有一层:address 共享是因为它不可变。如果哪天 Address 加了一个 setter,这个共享决定就失效了,而改动点在另一个类里。把共享的字段类型标成不可变(record、final 字段、无 setter),判据才站得住。
四、实测二:分配字节
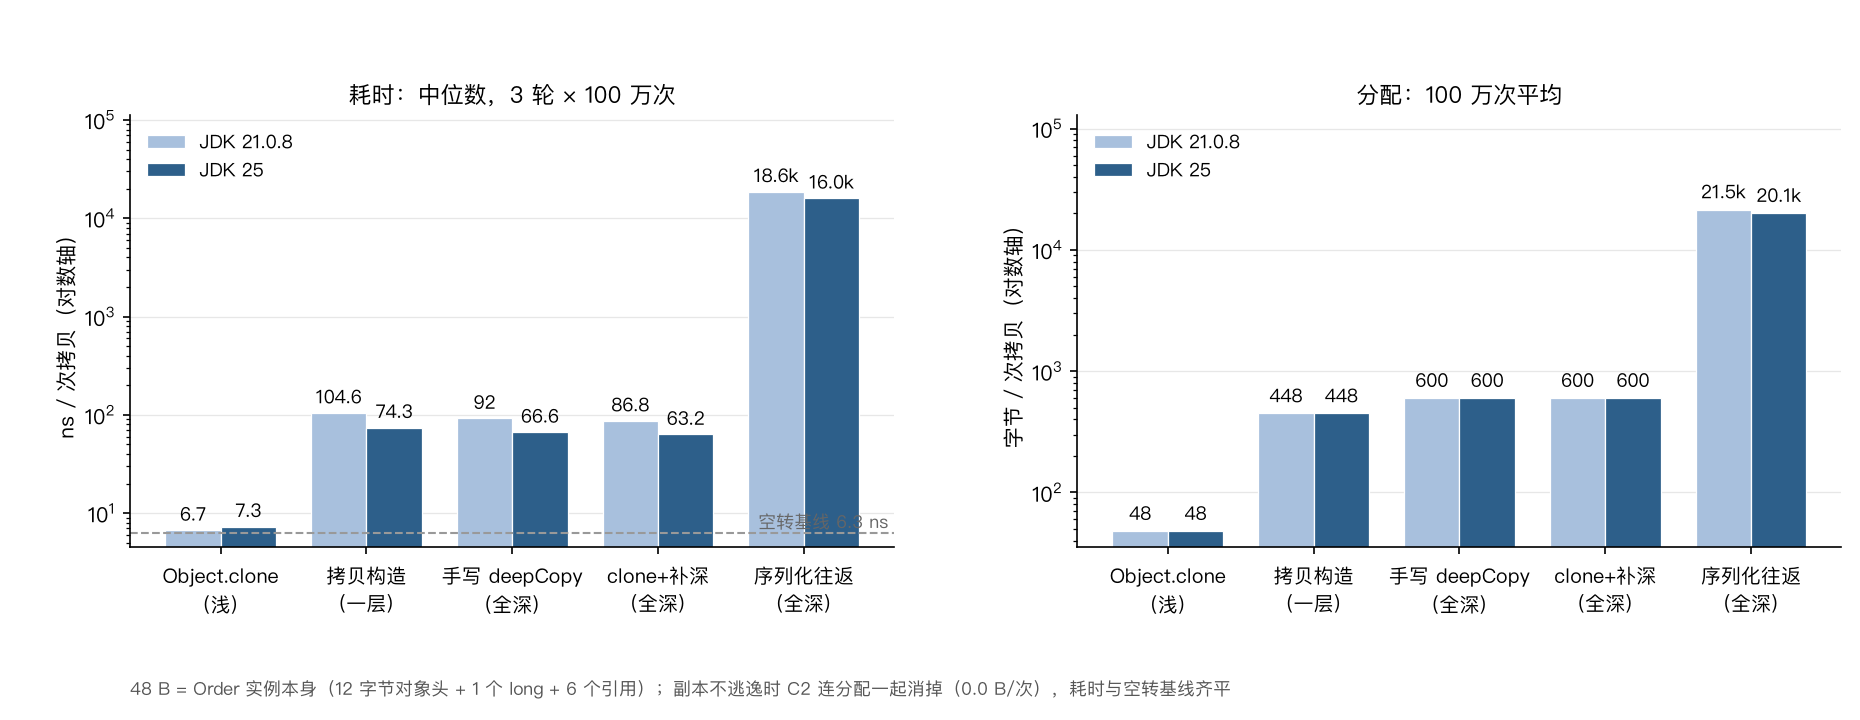
100 万次操作的平均值,两个 JDK 各测一遍:
| 路径 | JDK 21.0.8 | JDK 25 | 分配了什么 |
|---|---|---|---|
Object.clone |
48.0 B | 48.0 B | 实例本身 |
| 拷贝构造 | 448.0 B | 448.0 B | 一层结构 |
手写 deepCopy() |
600.0 B | 600.0 B | 全图 |
| clone + 补深 | 600.0 B | 600.0 B | 全图 |
| 序列化往返 | 21512.0 B | 20080.0 B | 全图 + 流水线 |
48 B 正好是 Order 实例的大小:12 字节对象头、1 个 long、6 个引用(压缩指针下各 4 字节),对齐到 48。这条路除此之外不分配任何东西,六个字段全是原引用,所以它在泄漏矩阵里全露。
448 到 600 差的 152 B,恰好是 1 个 Address(12 + 3 个引用 = 24 B)加 4 个 Item(各 12 + 4 + 4 + 8 = 28 → 32 B),24 + 128 = 152。深度版多出来的就是它没共享的那几个节点。
序列化那一列是另一个量级:同样一份数据,分配是手写深拷贝的 36 倍,是 clone 的 448 倍。
21 KB 花在哪
对象图序列化之后是 910 B。把往返拆成四段,看分配从哪一步开始跳:
| 阶段 | 累计分配 | 本步增量 |
|---|---|---|
new ByteArrayOutputStream(256) |
296.0 B | 296 |
+ new ObjectOutputStream |
2560.0 B | 2264 |
+ writeObject + flush |
5096.0 B | 2536 |
+ ObjectInputStream + readObject |
21512.0 B(JDK 25:20080.0 B) | 16416(JDK 25:14984) |
输出流一侧 2.2 KB,来自它构造时建好的几块缓冲与表:1 KB 的字节缓冲(BlockDataOutputStream.buf,java.base/java/io/ObjectOutputStream.java:1638)、256 字符的字符缓冲(1635 行定义长度,1642 行分配)、5 字节的块头缓冲,以及一张 10 槽的句柄表(HandleTable,spine、next、objs 三个数组各 10 项,2087-2089 行)。写出去再加 2.5 KB,主要来自 ByteArrayOutputStream 容纳 910 B 时的翻倍扩容(256 → 512 → 1024)。
大头在读回来这一步。ObjectInputStream 同样自带缓冲、句柄表、校验列表,readObject 还要为每个读回来的字符串建过程对象。这份图一次往返有 18 个字符串(1 个 id、5 个 tag、5 个 map 键、3 个地址字段、4 个 sku),每个字符串都有一段创建成本。
序列化深拷贝每次要分配约 20 KB,其中数据本身 910 B。它适合做「偶尔一次」的深拷贝,比如把对象存进缓存或跨进程传递;放进每请求的热路径就是另一回事了。
两个 JDK 的 1.4 KB 差
同一份代码,序列化那条路在 JDK 21 上分配 21512 B,JDK 25 上 20080 B,差 1432 B。原因在读字符串的写法上。JDK 25 的 ObjectInputStream 里:
1 | 3549 // Avoid allocating a StringBuilder if there's enough data in buf and |
(java.base/java/io/ObjectInputStream.java:3549-3551)ASCII 字符串直接 new String(buf, pos, ascii, ISO_8859_1) 就地取材,短的非 ASCII 字符串走实例自带的 char[] cbuf。JDK 21 的同一段是 private long readUTFSpan(StringBuilder sbuf, long utflen),每个字符串要先建一个 StringBuilder(默认 16 字符的 byte[],加上对象本身约 80 B)。18 个字符串乘 80 B 得到 1.4 KB,与实测的差额同量级。
分配量由实现细节决定,跨版本没有保证。同一段业务代码在两个 JDK 上的分配可以差出可观的一块,把 getThreadAllocatedBytes 挂进测试用例比猜可靠。
副本不逃逸时 C2 会把它消掉
对照组:测量循环里不把副本写出去,只在一个方法内创建、读字段、丢弃。第一轮分配 3.9 B/次(JDK 25 上 4.3 B/次),之后两轮掉到 0.0 B/次,耗时也从 12.9 ns 降到 6.1 到 6.2 ns,与空转基线(6.3 ns)齐平。逃逸分析判定 Order 实例不逃逸,C2 把整块分配消掉,拷贝耗时也就不存在了。
48 B 与 0.0 B 的差,是「副本要留下来」这件事的代价。一类微基准的数字漂亮到假,原因就在这里:被测对象没逃出测量方法,JIT 先把题目改小了。
五、实测三:耗时
每轮 100 万次,热身后 3 轮,表里是中位数:
| 路径 | JDK 21.0.8 中位数 | JDK 21.0.8 最小 | JDK 25 中位数 | JDK 25 最小 |
|---|---|---|---|---|
空转基线 consume(src) |
6.3 | 6.2 | 6.2 | 6.0 |
Object.clone |
6.7 | 6.6 | 7.3 | 6.9 |
| 拷贝构造 | 104.6 | 97.6 | 74.3 | 67.8 |
手写 deepCopy() |
92.0 | 87.6 | 66.6 | 66.3 |
| clone + 补深 | 86.8 | 86.7 | 63.2 | 63.0 |
| 序列化往返 | 18641.6 | 18579.2 | 16009.1 | 16008.7 |
(单位 ns/次。中位数来自 3 轮,最小列取 3 轮里最快的那一轮。)
三个档位
第一档只有 Object.clone 和空转基线,差 0.4 ns(JDK 21)到 1.1 ns(JDK 25)。同一轮里记录的分配是 48 B/次,说明这 48 B 每次都分配了,没有被优化掉。一次 48 B 的 TLAB 分配加上七个字段的复制,在这个循环里的边际成本不到 1.5 ns;空转基线的 6.2 ns 里,大头是消费动作(读七个字段)和写 SINK 那次 volatile 写。
第二档是三条深拷贝路,63 ns 到 105 ns。把 clone 的浅拷贝补成深拷贝,多花的那部分就是它的深度:552 B 的节点加约 60 到 100 ns。这一档的内部排序不可靠,轮间波动就有 ±15%(拷贝构造在 JDK 21 上的三轮是 126、97、104 毫秒),两个 JDK 之间又差 20% 到 30%。能站住的结论是档位差,档内名次排不出来。
第三档只有序列化,16009 ns 到 18642 ns。跨档的比值是稳的:
| 比值 | JDK 21.0.8 | JDK 25 |
|---|---|---|
手写 deepCopy() ÷ clone |
13.7 | 9.1 |
序列化 ÷ 手写 deepCopy() |
202.6 | 240.4 |
序列化 ÷ clone |
2782 | 2193 |
耗时和分配同向:48 B 对 6.7 ns,600 B 对 92 ns,21512 B 对 18642 ns(JDK 21 口径)。分配多两个数量级,耗时也多两个数量级。
计时那几轮的同口径分配与前面那张表一致,误差在 1% 以内(序列化 21656 B 对 21512 B,两个数来自不同的测量阶段),这在两套口径之间交叉验证了分配数字。
序列化的耗时里有回收成本
整段计时里 GC 次数是 395(JDK 21)与 368(JDK 25)。这个量级来自序列化那一条路:3 轮 × 100 万次 × 20 KB ≈ 60 GB 垃圾,堆只有 2 GB。所以 16 到 18 µs 里含着这些垃圾的回收,日志里有每个变体各自的轮次毫秒数可以核对。
换算到线上:每秒 1000 次拷贝的位置上,序列化是每秒钟 16 毫秒的 CPU 加 20 MB 垃圾;同一个位置换成手写深拷贝,两项都掉两个数量级。所以这条路只适合放在低频边界(落盘、进缓存、跨进程),不放在每请求路径上。
六、JDK 源码里的证据
转述容易把边界说糊,下面几段逐字取自 JDK 25 的 src.zip。
Object.clone 的 @implSpec(java.base/java/lang/Object.java:215-219):
1 | 215 * Otherwise, this method creates a new instance of the class of this |
as if by assignment 这四个词是浅拷贝的准确描述:副本的字段赋值过去,和 b.field = a.field 没有区别。同一份 javadoc 的 196-200 行给出的补救办法:
1 | 196 * By convention, the object returned by this method should be independent |
方法本身是 native(Object.java:234-235):
1 | 234 @IntrinsicCandidate |
@IntrinsicCandidate 说明它是一个 VM 内建:复制一个实例的字段布局,没有 Java 层循环。四条路里只有它把「复制字段」这一步交给了 VM。
Cloneable 这个标记接口的措辞(java.base/java/lang/Cloneable.java:29-32):
1 | 29 * A class implements the {@code Cloneable} interface to |
同一个文件 43-46 行有一句常被忽略的话:
1 | 43 * Note that this interface does <i>not</i> contain the {@code clone} method. |
Cloneable 里没有 clone 方法,实现它只是给了 Object.clone 一个许可位,不实现就抛 CloneNotSupportedException。
ArrayList#clone 展示了 JDK 自己怎么写这条路的补深部分(java.base/java/util/ArrayList.java:343-348):
1 | 343 public Object clone() { |
三个动作:super.clone() 拿到浅副本,Arrays.copyOf 换掉内部数组,modCount 清零。数组元素是引用,所以这个 clone 对 List<Order> 里的每一个 Order 都不复制。
Arrays.copyOf 在两边夹了一条快路径(java.base/java/util/Arrays.java:3587-3594):
1 | 3587 public static int[] copyOf(int[] original, int newLength) { |
长度相同时转手调 original.clone(),数组的 clone 是另一个 VM 内建;否则 arraycopy 加长度裁剪。两个分支都是块拷贝。
HashMap 的拷贝构造走的是另一条路(java.base/java/util/HashMap.java:490-494):
1 | 490 @SuppressWarnings("this-escape") |
putMapEntries 内部按 size / loadFactor + 1 算容量、建表,再对每个条目调用 putVal(hash(key), key, value, false, evict)。同样的 5 条数据,ArrayList 那边是一次 arraycopy,这边是 5 次哈希与插入。散列表结构决定了它没法块拷贝。
HashMap 把浅拷贝和补深合在同一个方法里(java.base/java/util/HashMap.java:1458-1476):
1 | 1458 * Returns a shallow copy of this {@code HashMap} instance: the keys and |
super.clone() 先把原表一起带过来,reinitialize() 清空这些字段,putMapEntries 重建内部结构。这就是「clone + 手工补深」在 JDK 里的写法,注释第一句把深度交代清楚:keys and values themselves are not cloned。
最后是序列化那条路里的一次改进(java.base/java/io/ObjectInputStream.java:3536-3555):
1 | 3536 if (utflen > 0 && utflen < Integer.MAX_VALUE) { |
CHAR_BUF_SIZE 是 256(java.base/java/io/ObjectInputStream.java:2850)。这两段重写针对的是 JVM 优化最不喜欢的东西:一个每次都新建、每次都扔的临时容器。
七、结论
什么时候用哪条
- 类里没有可变嵌套字段(全是标量或不可变引用):
clone或拷贝构造都够用,48 B 到 448 B 一次,写法随意挑。JDK 自己的ArrayList、BitSet、Date都在这一类。 - 图层数固定、类型已知:手写复制方法,或者
clone之后逐字段补深。实测两条路的分配相同(600 B),耗时也接近,取决于你更愿意写哪种代码。 - 只有一层嵌套:拷贝构造,重建数组与集合,成员对象共享。这是 JDK 集合的惯例,也是我上面那版
new Order(src)的写法。 - 需要跨流、跨进程、跨缓存传递:序列化往返。它的 20 KB/次换来的是「不用为每个类写复制代码」,在日志、会话、RPC 这类边界上划算。
什么时候不用原型
对象不可变时没有拷贝问题,直接共享引用(见 不可变与防御性拷贝)。构造过程便宜、参数齐全时,原型多引入一层「源对象状态可能过期」的隐式依赖,直接 new 更清楚。类型是接口且实现不断新增时,每个实现都要维护自己的拷贝逻辑,漏一个就有一条静默的共享路径,这种场合序列化或显式映射往往更省心。
还有一条边界:Object.clone() 的 javadoc 里,x.clone().getClass() == x.getClass() 与 x.clone().equals(x) 都用「惯例」描述,不是硬性要求。子类只要不用 super.clone(),这两个等式就会破。
字段带 final 的类也用不了「clone + 补深」:clone() 里给 final 字段换引用会编译失败(无法为 final 变量 a 分配值),只能改成拷贝构造(把复制放进构造器)或序列化。record 的字段全是 final,实测 record Rec(int[] a) 实现 Cloneable 并调用 super.clone() 能编过、能跑,但拿到的是浅拷贝,改副本的数组仍会改到源对象。record 做深拷贝只有两条路:紧凑构造器里 a = a.clone(),或者实现 Serializable 走序列化。
序列化的三份额外代价
第一份是兼容性。序列化把字段名与类型写进流里,类一改名、改类型、换包,旧数据就反序列化不回来。serialVersionUID 显式声明能挡一部分,但字段结构的变化(删字段、改类型)依然要自己写迁移逻辑。这份代价在你把对象写进磁盘、写进消息队列之后才开始付,且没有回头路。
第二份是安全。反序列化会执行流里的类构造与 readObject 回调,攻击面来自数据本身。JDK 9 起有了反序列化过滤器(JEP 290),17 起可以在每个 Stream 上下文上挂自己的过滤策略(JEP 415)。过滤器要有人配:没有配置时反序列化不做限制,而「内部深拷贝」这种纯内存需求一旦实现成序列化往返,就等于把这条攻击面引进来,收益只是少写几行复制代码。
第三份是版本漂移。这次实测里,同一个往返在 JDK 21 与 JDK 25 上分配差 1432 B,耗时也差 14%(18642 对 16009 ns)。分配量不是契约,升级 JDK 会变;如果热路径压在序列化往返上,这份漂移会直接落到吞吐上。
    flowchart TD
    A{"要复制的对象里有可变嵌套引用吗?"} -->|没有| B["clone 或拷贝构造都够<br/>48–448 B/次"]
    A -->|有| C{"嵌套结构的类型固定、层数已知?"}
    C -->|是| D["手写复制方法<br/>或 clone 之后逐字段补深<br/>约 600 B/次"]
    C -->|否| E{"还要跨流、跨进程或落缓存?"}
    E -->|是| F["序列化往返<br/>约 20 KB/次,只放在边界上"]
    E -->|否| G["先问这个对象要不要可变<br/>不可变就没有拷贝问题"]
一条判断顺序
- 先问这个对象需不需要可变。不可变就没有深拷贝这件事,共享一份实例即可。
- 可变但没有嵌套可变字段:
clone或拷贝构造,用最短的那种。 - 有嵌套可变字段:列字段清单,逐个决定共享还是复制。共享的对象要么不可变,要么在业务上允许被副本影响。
- 决定复制的字段,用手写复制方法写出来。如果实现
Cloneable,clone()里把字段换掉再返回,让两条路给出同样的深度。 - 只有当「对象图会变化、不想为每个类写复制代码」并且「这条路径不在热路径上」两条同时成立时,才用序列化。
在第 3 步之后加一条验证:写一个和本文第三部分一样的布尔测试,改副本的每个可变字段,断言原对象不变。这类测试跑一次就知道深度写对了没有。
总结
- 四条路的分配分别是 48 B、448 B、600 B、21512 B(JDK 25 上 20080 B),最贵的一条是最便宜的 448 倍。
- 耗时排序与分配同向,
clone那条路走在 VM 内建上,序列化那条路每次重建约 20 KB 的流水线。 Object.clone默认给出浅拷贝,七个测试位置全部泄漏;拷贝构造只重建一层,address与items元素仍然共享。- 深度是逐字段决定的。「这个类是深拷贝」不是有效描述。
- 序列化的分配还会随 JDK 版本变化(本次实测两个 JDK 差 1.4 KB),把分配数当契约会吃亏。
参考资料
- Object (Java SE 25 & JDK 25)
- Cloneable (Java SE 25 & JDK 25)
- ArrayList (Java SE 25 & JDK 25)
- HashMap (Java SE 25 & JDK 25)
- JEP 290: Filter Incoming Serialization Data
- JEP 415: Context-Specific Deserialization Filters
- JDK 25
src.zip:java.base/java/lang/Object.java、java.base/java/lang/Cloneable.java、java.base/java/util/ArrayList.java、java.base/java/util/Arrays.java、java.base/java/util/HashMap.java、java.base/java/io/ObjectInputStream.java
系列索引:设计模式系列