设计模式——工厂方法:创建动作的成本
工厂方法把「造哪个对象」从调用点挪进一个函数。调用点少写一个类名,多走一次转发。
这次转发值多少钱,取决于 JIT 能不能看穿它:内联成功就归零,调用点变多态就留下几纳秒。
量级差出在另外两处:反射入口的参数装箱、第一次创建时组装访问器的开销。
本文用 100 万次创建、两个 LTS(21.0.8 与 25),把「多一跳」拆成可测量的几项。
一、抽象掉一次创建,到底抽象掉了什么
把构造调用换成工厂方法的代码长这样:
1 | // 直接创建:类型写在调用点,编译期就定了 |
第一行是一次 invokespecial:JVM 解析常量池的时候就知道要分配哪个类、调用哪个构造函数,内联器和逃逸分析都能直接往里看。第二行是一次 invokeinterface:调用点只知道 OrderFactory 这个接口,具体分配哪个类取决于运行时拿到的实现对象。
工厂方法换到的是「造哪个类」的决定权,代价是多一层转发。形状由四个角色固定:
    classDiagram
    direction TB
    class Creator {
        <<interface>>
        +create() Product
    }
    class ImageCreator {
        +create() Image
    }
    class DocumentCreator {
        +create() Document
    }
    class Product {
        <<interface>>
    }
    class Image
    class Document
    Creator <|.. ImageCreator
    Creator <|.. DocumentCreator
    Product <|.. Image
    Product <|.. Document
    ImageCreator ..> Image : new
    DocumentCreator ..> Document : new
    note for Creator "调用点只依赖这一层;新增产品只加实现,不动调用点"
这四类角色是 GoF 的原始定义:Creator 声明工厂方法,ConcreteCreator 覆写它并决定造哪个 Product,产品族各自实现 Product 接口。实际代码里,Creator 通常简化成 Function、Supplier 或者一个函数对象,它们在 JVM 上的行为一样,都是一次接口调用。
跟邻近模式的边界:
- 简单工厂把
switch收进一个静态方法,类型选择只有一处,测试里换不掉。工厂方法多出来的是一个接口,换实现不用改调用点。 - 抽象工厂是若干个工厂方法打包成一个对象,解决的是「一组产品要配套」,见抽象工厂那一篇。只有一个产品维度时,抽象工厂里的每个方法就是工厂方法。
- 建造者关心的是同一个对象分步骤装配,创建动作本身还是固定的,装配的代价在建造者那一篇里量过。本篇只碰「造哪一个、怎么造出来」这一跳。
JDK 自己怎么选
JDK 里有几处可以直接对照:
| 位置 | 形态 | 创建动作是什么 |
|---|---|---|
javax.sql.DataSource#getConnection |
工厂方法 | 真开一条连接,延迟在毫秒级,转发成本可以忽略 |
java.util.Collection#iterator |
工厂方法 | 分配一个迭代器对象,ArrayList 里就是 new Itr() |
java.lang.Thread.Builder#factory(JDK 21+) |
工厂方法 | 返回 ThreadFactory,创建动作在之后每次 newThread 调用里发生 |
Integer#valueOf |
静态工厂 + 缓存 | 命中缓存时返回已有对象,Integer.java:932-984 是那张缓存表的范围(-128 到 127,上限受 java.lang.Integer.IntegerCache.high 控制) |
Integer#valueOf 说明工厂方法返回的不一定是新对象。调用点写下 Integer.valueOf(x),拿到的可能是缓存里的旧对象,这是 new 给不了的自由度,也是「工厂方法」这个词有时名不副实的原因:它不保证创建。缓存式工厂属于共享不可变的思路,细节留给享元那一篇。
二、实验设计
实验用的类只有两个字段,构造函数不做别的事:
1 | public static final class Point { |
六条路径每条都把 Point 造 100 万次,结果写进预分配好的 Object[],避免逃逸分析把这些对象整个消掉。前四条对应「创建动作被抽象成什么」,后两条对应「抽象成反射对象」:
| 编号 | 路径 | 调用点形态 |
|---|---|---|
| 1 | new Point(a, b) |
编译期解析,可内联 |
| 2 | Supplier<Point>.get() |
零参函数对象,单态 |
| 3 | 自定义 Maker.make(int,int)(1 个实现) |
带参函数对象,单态 |
| 4 | 同一个 Maker 调用点,5 个实现 |
多态调用点 |
| 5 | 缓存的 Constructor<Point>#newInstance |
反射,参数现场装箱 |
| 6 | static final MethodHandle#invokeExact |
方法句柄,无装箱 |
另外两个变体用来给前六条做对照,只在表里出现,不画进图:Maker 调用点放两个实现(双态,看内联还能不能成立),以及反射路径的参数预装箱(把装箱成本单独摘出来)。
测量口径:
- JDK:
21.0.8+12-LTS-250与25+37-LTS-3491,都是 arm64 的 HotSpot。 - 机器:Apple M1 Pro,10 核,macOS Darwin 25.6.0。
- 每条路径先跑 5 轮预热丢弃,再计时 5 轮,取中位数。每轮 100 万次。
- 时间是
System.nanoTime()的前后差,含数组写入与被写对象的内存分配,不含 GC 之外的任何清理。 - 分配字节用
com.sun.management.ThreadMXBean#getThreadAllocatedBytes,取每轮的差值再取中位数。这个计数是 TLAB 记账,不受 CPU 争用影响。 - 同一台机器上还有别的进程在跑,所以计时阶段全程持一把全局文件锁,避免互相抢核。时长的分辨力大概在零点几毫秒,换算到每次创建是零点几纳秒,只用来判断量级。
这不是 JMH,只用来把「量级」这一栏填上,给不出能写进性能报告的小数点。
三、实测一:稳态下的六条创建路径
| 路径 | JDK 21 耗时 | JDK 25 耗时 | JDK 21 分配字节/次 | JDK 25 分配字节/次 |
|---|---|---|---|---|
new |
4.07 ns | 2.08 ns | 24 B | 24 B |
Supplier.get()(单态) |
4.43 ns | 2.20 ns | 24 B | 24 B |
| 工厂函数,1 个实现 | 4.28 ns | 4.08 ns | 24 B | 24 B |
| 工厂函数,2 个实现 | 3.09 ns | 4.36 ns | 24 B | 24 B |
| 工厂函数,5 个实现 | 6.12 ns | 5.60 ns | 24 B | 24 B |
Constructor#newInstance |
4.52 ns | 3.32 ns | 56 B | 24 B |
Constructor#newInstance(参数预装箱) |
3.53 ns | 3.48 ns | 24 B | 24 B |
MethodHandle#invokeExact |
4.33 ns | 2.20 ns | 24 B | 24 B |
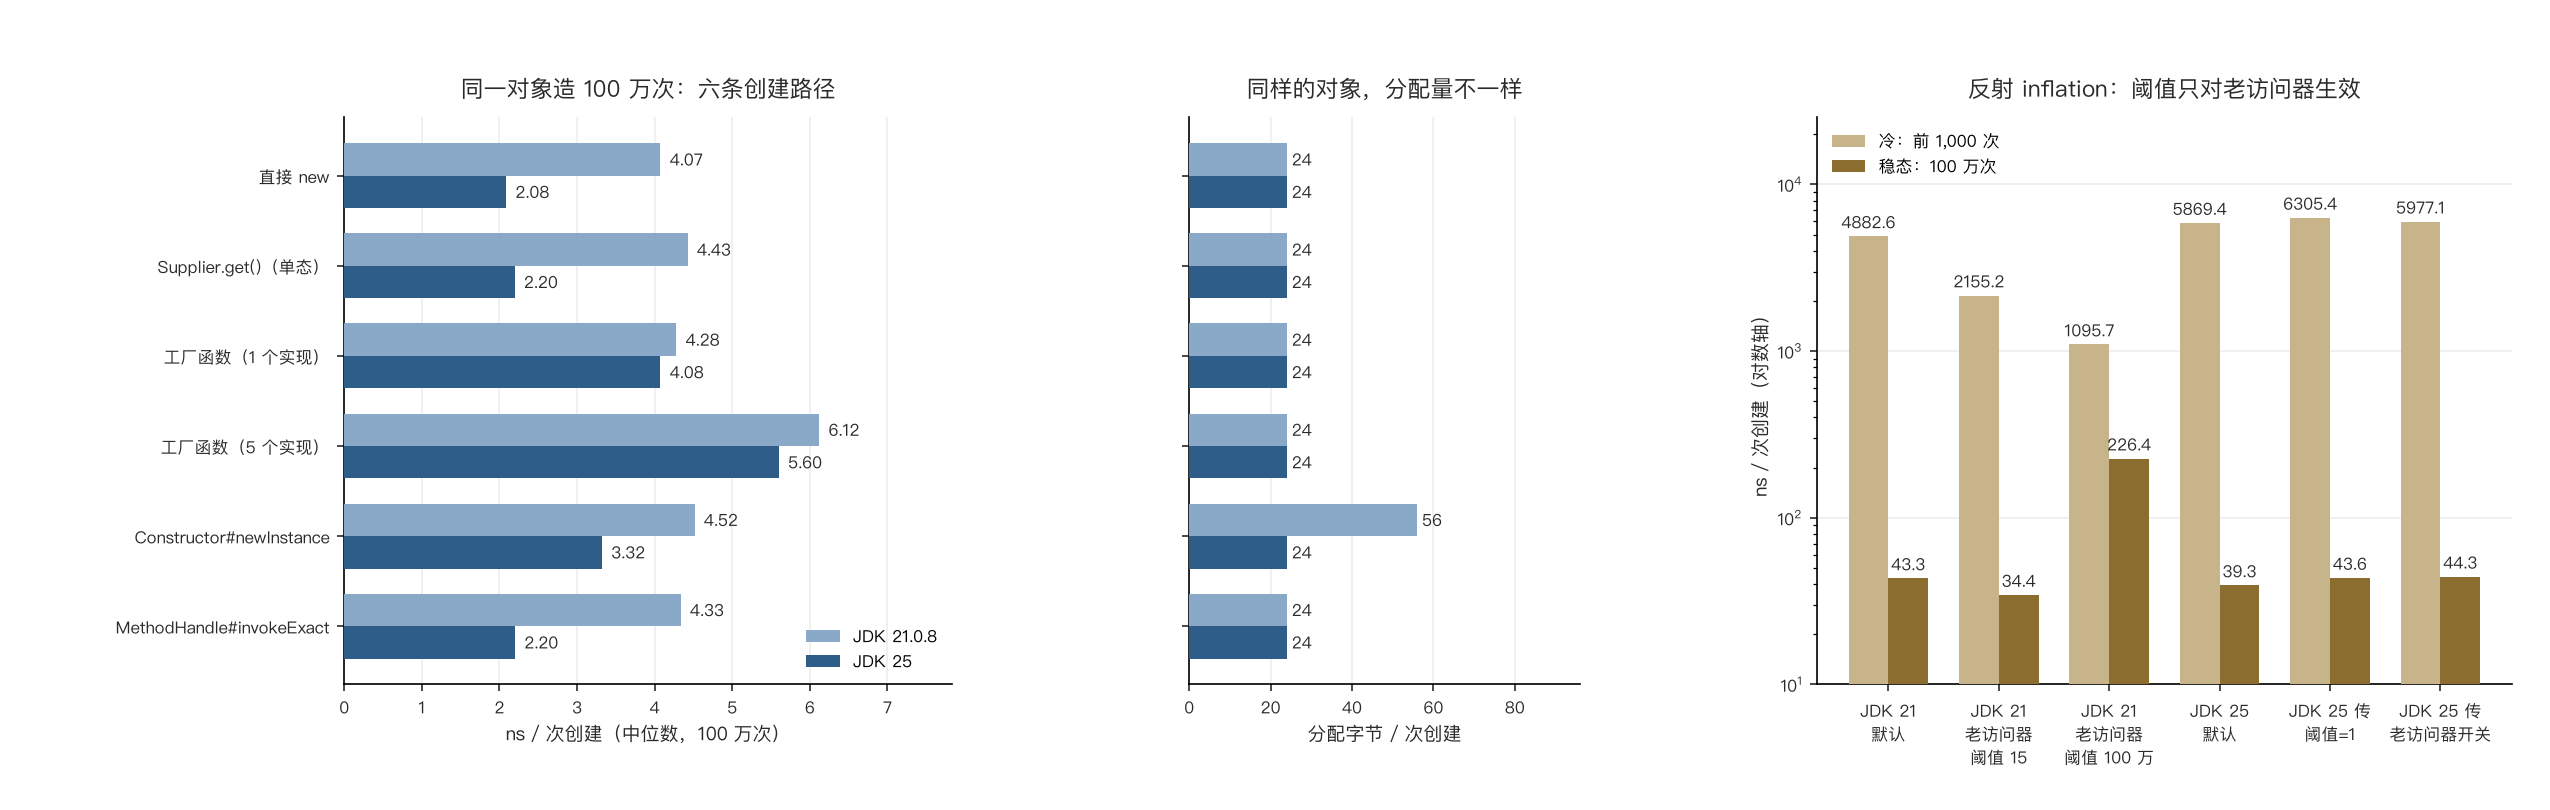
耗时上,六条路径的大部分差距落在测量噪声能解释的范围内。JDK 21 上 new、Supplier.get、单实现工厂函数、反射、invokeExact 全落在 4.0 到 4.7 纳秒之间;JDK 25 的落点更低,排序也换过位置:new 是 2.08,invokeExact 是 2.20,反射是 3.32,单实现工厂函数是 4.08。同一段代码在两个 LTS 上给出两套排序,差别来自 JIT 的编译顺序与剖析决定,跟语言语义无关。稳态下「多一次接口调用」这件事,在 2 纳秒的分辨力里测不出来。
站得住的差异有两处。
一个是多态调用点。pool[i % 5].make(a, b) 这一个调用点上有五种实现,C2 的类型剖析退化,内联失败,代价可复现:JDK 21 上两次运行是 6.05 与 6.19 纳秒,JDK 25 上是 5.77 与 5.43 纳秒。两个 JDK、两次运行,方向一致,是同一条路径单态版本的一点四到两倍。
另一个在分配那一栏。JDK 21 的反射路径每次创建分配 56 字节,其它路径都是 24 字节。24 字节是这个对象本身(12 字节对象头加两个 int 字段,对齐到 24)。多出来的 32 字节是两个 Integer 装箱:newInstance(Object...) 接受的是对象,int 参数要在调用点装箱。
JDK 25 那一栏是 24,两次运行都如此,装箱被逃逸分析消掉了。两个 JDK 对同一条反射构造链做了不同的逃逸分析决定:同样的源码,JDK 21 每次多分配 32 字节,JDK 25 一个字节也不多。
分配字节比时间更能说明问题
把标量替换关掉(-XX:+UnlockDiagnosticVMOptions -XX:-EliminateAllocations)再跑同一套代码,账目就对上了:
| 路径 | 分配字节/次(默认) | 分配字节/次(关掉标量替换) |
|---|---|---|
new、函数对象、invokeExact |
24 | 24 |
Constructor#newInstance,参数现场装箱 |
56(JDK 21)/ 24(JDK 25) | 80 |
Constructor#newInstance,参数预装箱 |
24 | 48 |
80 = 24(对象)+ 32(两个 Integer)+ 24(Object[2] 参数数组)。48 = 24 + 24。关掉标量替换之后,参数数组和两个装箱都摆在明处。默认配置下,JDK 21 消掉了参数数组、留下了装箱(56),JDK 25 两个都消掉(24)。
单件的大小用同一台机器上的探针量:
| 表达式 | 分配字节/次 |
|---|---|
new Point(a, b) |
24 |
new Integer(v) |
16 |
Integer.valueOf(v),命中缓存 |
0 |
Integer.valueOf(v),超出缓存 |
16 |
new Object[2]、new int[2] |
24 |
24 + 16 + 16 + 24 = 80,和上面那一列严丝合缝。命中缓存那一行是 0 字节:Integer.valueOf 在 -128 到 127 范围内直接返回 IntegerCache 里的实例,Integer.java:932-985 是那张表。工厂方法返回的不一定是新对象,这一档就是它跟 new 的分界线,具体套路属于共享不可变那一篇的范围。另一个细节:命中缓存的那一行耗时反而更高(31.93 对 2.89 纳秒/次),因为反复把同一个老年代对象写进年轻代数组要走写屏障的慢路径,省下的是分配这一栏。
关掉标量替换之后,时间也跟着变了:反射路径从 4.52 抬到 8.56 纳秒(JDK 21),从 3.32 抬到 8.63 纳秒(JDK 25)。分配不是免费的,逃逸分析每一次成功的消除都对应一次真实的搬运。
JIT 把这条链吃掉了
56 字节与 4.5 纳秒放在一起,说明反射调用没有完整走一遍。用 -XX:+PrintInlining 把内联决定打出来,两个 JDK 上看到的是同一件事:
1 | # JDK 21 |
Constructor#newInstance 上的 @ForceInline、访问器上的 @Hidden @ForceInline,加上类型剖析 100% 命中同一个访问器实现,整条链在编译后的循环里就是一段直线代码。剩下的差别只有两处:参数要装箱(JDK 21 没消掉),以及访问器对象要经过两次字段读取。
这条链能这样折起来,是 JEP 416 的直接目的:反射入口从「VM 内部的一个洞」变成一次普通方法调用加一次方法句柄调用,JIT 可以用同一套内联规则处理它。JDK 18 之前的实现在这里没有这个机会,它调用的是一次 JNI 入口,inline (hot) 那一行不会出现。
换一个测量装置,结论会不会变
上面那张表里,八行共用一个 JVM,JIT 的编译顺序与类型剖析互相影响。把每条路径放进自己的 JVM 再跑一遍:
| 路径 | JDK 21 混跑 | JDK 21 独立 JVM | JDK 25 混跑 | JDK 25 独立 JVM |
|---|---|---|---|---|
new |
4.08 / 4.13 | 5.06 | 2.08 / 2.09 | 2.41 |
Supplier.get() |
4.16 / 4.69 | 4.19 | 2.18 / 2.21 | 2.42 |
| 工厂函数,1 个实现 | 4.24 / 4.32 | 4.26 | 4.08 / 4.07 | 2.37 |
| 工厂函数,2 个实现 | 2.78 / 3.40 | 4.58 | 4.50 / 4.21 | 3.58 |
| 工厂函数,5 个实现 | 6.05 / 6.19 | 6.73 | 5.77 / 5.43 | 5.20 |
Constructor#newInstance |
4.59 / 4.44 | 8.20 | 3.29 / 3.35 | 3.77 |
MethodHandle#invokeExact |
4.20 / 4.47 | 4.13 | 2.14 / 2.26 | 2.70 |
(两列混跑是两个独立 JVM 各自的结果,独立 JVM 那一列是单跑一次;单位都是纳秒/次。)
表里那行「2 个实现」在混跑时是 3.09 和 4.36,独立跑变成 4.58 和 3.58;它在混跑时的低值没有意义,两条实现都在内联范围内。变化更大的是两处:JDK 25 的单实现工厂函数从 4.08 掉到 2.37,JDK 21 的反射路径从 4.5 涨到 8.2。同一条路径换一个测量装置,结论能差一倍,这类差异该记在方法学账上,不能写进设计决策。
两次装置下都站得住的只有两条:多态调用点比单态贵一点四到两倍;JDK 21 的反射路径每次创建多分配 32 字节。其余的差别(包括 JDK 25 整体比 JDK 21 低一截)属于 JIT 版本差异。写微基准的时候把 JDK 版本号写出来,比把小数点多写一位重要。
四、实测二:第一次创建
稳态的循环已经被 JIT 编译过,第一次调用没有。每个 JDK 起 5 个新 JVM,量一串「第一次」,同时用 ClassLoadingMXBean 数出每一步加载了多少个类:
| 动作 | JDK 21 中位耗时 | 该步加载的类 | JDK 25 中位耗时 | 该步加载的类 |
|---|---|---|---|---|
Point 第一次 new(含类加载) |
264 µs | 1 | 203 µs | 1 |
new(类已加载) |
333 ns | 0 | 416 ns | 0 |
Class#getConstructor |
36 µs | 0 | 43 µs | 0 |
第一次 newInstance |
2.27 ms | 18 | 3.30 ms | 28 |
第二次 newInstance |
7.4 µs | 0 | 8.9 µs | 0 |
换一个类,第一次 newInstance |
49 µs | 0 | 59 µs | 0 |
MethodHandles.Lookup#findConstructor |
40 µs | 0 | 51 µs | 0 |
第一次 invokeExact |
253 µs | 1 | 289 µs | 1 |
第二次 invokeExact |
1.7 µs | 0 | 1.6 µs | 0 |
(µs 是微秒。每一行取 5 次运行的中位数。)
台阶有三层,每一层都能归到具体的东西上:
new一次,类已经加载之后是几百纳秒。同一个类第一次被用到时要先加载它自己,要 200 到 260 微秒。这笔钱跟工厂方法无关,任何第一次碰到这个类的代码都要付。Class#getConstructor是 40 微秒上下,不加载新类,java.lang.reflect在启动阶段就备好了。- 第一次
newInstance是 2.3 到 3.3 毫秒,这一步同时加载了 18 个类(JDK 21)或 28 个类(JDK 25)。
18 到 28 个类的加载按每个类几十微秒算,只值几百微秒到一毫秒,解释不了整个台阶。
剩下的部分,本次没能继续拆开,能确定的是它不属于方法句柄子系统的首次初始化:先跑一次 findConstructor 加 invokeExact 把方法句柄热身,再量第一次 newInstance,耗时还是 2.9 到 3.8 毫秒。同一份代码里,第一次 invokeExact 只要 250 到 290 微秒。所以这 2 到 3 毫秒是「进程里第一次把 java.lang.reflect 这条完整调用路径跑通」的一次性开销,本次测量只把它定位到这一步,没有更细的归因。
把一次性开销和每个类的装配分开,只需要在同一个进程里再给第二个类装一次访问器:换一个类之后,第一次 newInstance 只要 49 微秒(JDK 21)和 59 微秒(JDK 25),而且一个类都不用加载。同一个类的第二次调用掉到 7 到 9 微秒,此时循环还在解释器里跑,没有 JIT 编译后的循环。
MethodHandle 那条路同构:findConstructor 要 40 到 51 微秒,第一次 invokeExact 250 到 290 微秒(附带加载一个句柄自己的 lambda form 类),第二次 1.5 微秒。
三层放在一起:创建一个对象几百纳秒,第一次反射创建几毫秒,中间隔着四个数量级;装配一次访问器五十微秒,稳态下两者又回到同一个带。讨论「工厂方法贵不贵」时如果不说是哪一层,就是拿一个数解释另一个数。
反射式工厂的开销形状是「每个类一次性的几十微秒」,把它当成「每次创建多几纳秒」讨论就是量错了地方。这类工厂适合启动期的装配(配置、插件、IoC 容器),每个类五十微秒的账单付得起;不适合放进每秒百万次的创建路径,那条路径上不该有 JIT 看不见的东西。
五、实测三:inflation 阈值在 JDK 25 上已经失效
| 配置 | 冷:前 1,000 次 | 稳态:1,000,000 次 |
|---|---|---|
| JDK 21 默认(方法句柄访问器) | 4882.6 ns/次 | 43.29 ns/次 |
| JDK 21 老访问器,阈值默认 15 | 2155.2 ns/次 | 34.41 ns/次 |
| JDK 21 老访问器,阈值 1000000 | 1095.7 ns/次 | 226.42 ns/次 |
JDK 21 老访问器,noInflation=true |
962.5 ns/次 | 34.56 ns/次 |
| JDK 25 默认 | 5869.4 ns/次 | 39.29 ns/次 |
JDK 25 传 -Dsun.reflect.inflationThreshold=1 |
6305.4 ns/次 | 43.57 ns/次 |
JDK 25 再传 -Djdk.reflect.useDirectMethodHandle=false |
5977.1 ns/次 | 44.28 ns/次 |
第二行和第三行是同一个老访问器实现,只改了 -Dsun.reflect.inflationThreshold:稳态从 34.41 纳秒/次变成 226.42 纳秒/次,六点六倍。前十五次调用之后它会生成一个字节码访问器,此后每次反射调用变成一次直接调用;阈值抬到一百万,这一百万次就全部留在 JNI 入口上。
第一行、第四行和第五行组成三角对照:JDK 21 的默认配置(方法句柄访问器)稳态 43.29,noInflation=true 的老实现 34.56,JDK 25 默认 39.29,三个数在同一个带里。JDK 21 的默认配置没有用 inflation,阈值设成多少都一样。
第六、七行是 JDK 25 上的对照:传 -Dsun.reflect.inflationThreshold=1,稳态 43.57;再传 -Djdk.reflect.useDirectMethodHandle=false,稳态 44.28。跟不传的 39.29 比,都在本次测量的波动范围内。System.getProperty 拿得到这些值,只是没有任何代码去读它们:前面在 src.zip 里搜「inflation」,java.base 下一条命中都没有,说的就是这件事。
类加载日志记下了这个机制的切换:
1 | # JDK 21,-Djdk.reflect.useDirectMethodHandle=false,阈值 15 |
GeneratedConstructorAccessor1 是 MethodAccessorGenerator 在运行期拼出来的类,ClassDefiner.defineClass 把它定义进平台加载器,来源标记 __ClassDefiner__(ClassDefiner.java:56-66,包名参数写的就是这个字符串)。阈值 15 时它出现在第 0.045 秒;阈值一百万时它出现在第 0.269 秒,也就是一百万次慢调用快跑完的时候。默认配置和 JDK 25 上,这个类不存在。
inflation 的思路是按需切换实现:用解释期的慢路径换启动时间,用生成期的快路径换稳态吞吐。问题出在实现方式:生成的类是真实的类文件,要走真实的定义与加载。JDK-8305104 的标题是「Remove the old core reflection implementation」,正文只有一句话:「JEP 416 用方法句柄重写了核心反射,从 JDK 18 起只报了几个小问题,是时候把老实现删掉了。」
六、源码:一次 newInstance 要过几道手
把 Constructor#newInstance 这条路径摊开。默认行为两个版本一致,差别在于 JDK 21 还留着一套可以在运行期换掉的老实现,JDK 25 只剩前一条。
    graph LR
    A["Constructor.newInstance(Object[])<br/>Constructor.java:478"] --> B["@Stable constructorAccessor<br/>Constructor.java:494"]
    B -->|null| C["acquireConstructorAccessor<br/>Constructor.java:532"]
    C --> D["ReflectionFactory.newConstructorAccessor<br/>ReflectionFactory.java:122"]
    D -->|JDK 21 默认 / JDK 25| E["MethodHandleAccessorFactory<br/>unreflectConstructor + asType"]
    E --> F["DirectConstructorHandleAccessor.invokeImpl<br/>@Hidden @ForceInline,按参数个数分派"]
    F --> G["MethodHandle.invokeExact → 构造函数"]
    D -->|"JDK 21 加 -Djdk.reflect.useDirectMethodHandle=false"| H["NativeConstructorAccessorImpl<br/>JNI 调用"]
    H -->|"调用次数 > inflationThreshold"| I["MethodAccessorGenerator<br/>生成字节码访问器"]
    I --> J["DelegatingConstructorAccessorImpl<br/>切换 delegate"]
稳态路径(JDK 21 默认与 JDK 25)
两个版本都读同一个 @Stable 字段,构建一次之后不再走分支。JDK 25 Constructor.java:476-500:
1 |
|
acquireConstructorAccessor 只在第一次调用时执行,它的注释说明了为什么不上锁(Constructor.java:527-553):
1 | // NOTE that there is no synchronization used here. It is correct |
工厂造出来的那个对象,是一句 MethodHandles.Lookup#findConstructor 加上一串类型适配(MethodHandleAccessorFactory.java:96-111 与 :151-160):
1 | static ConstructorAccessorImpl newConstructorAccessor(Constructor<?> ctor) { |
参数个数不大于 SPECIALIZED_PARAM_COUNT(MethodHandleAccessorFactory.java:290,值是 3)时,句柄按固定参数装配,不用 Object[] 摊平。之后每次调用落在 DirectConstructorHandleAccessor 的一个 switch 上(DirectConstructorHandleAccessor.java:82-92):
1 |
|
@Hidden 阻止这段调用栈出现在栈追踪里,@ForceInline 让调用方一定把它内联掉。这一段是 JEP 416「用方法句柄重写核心反射」的产物:反射入口不再解释参数,也不再生成新类,它把一次反射调用变成一次方法句柄调用,让 JIT 有机会把它和普通调用一样处理。
invokeExact 本身是一个签名多态方法(MethodHandle.java:505),返回类型由调用点的上下文决定,编译期就把描述符写死:
1 | public final native Object invokeExact(Object... args) throws Throwable; |
用 findConstructor 自己搭一个句柄,要走的是同一套适配(MethodHandles.java:2630-2638 解释了返回类型的约定):
1 | /** |
请求的类型写 void,拿到的句柄返回构造函数所属的类。这是构造句柄和普通方法句柄唯一别扭的地方。
老路径与 inflation(只在 JDK 21 上存在)
JDK 21 保留了 JEP 416 之前的实现,用 -Djdk.reflect.useDirectMethodHandle=false 打开。这条路径上有两代访问器:一个用 JNI 调 VM,一个把反射调用编译成字节码。切换点在 ReflectionFactory.java:630-645,注释写得很直接:
1 | // "Inflation" mechanism. Loading bytecodes to implement |
默认阈值 15 就在这里。每次调用都会比一次(NativeConstructorAccessorImpl.java:57):
1 | // We can't inflate a constructor belonging to a hidden class |
超过阈值以后生成字节码访问器,挂在 delegating 包装器上,下次调用就走新实现(DelegatingConstructorAccessorImpl.java:36-63):
1 | class DelegatingConstructorAccessorImpl extends ConstructorAccessorImpl { |
sun.reflect.inflationThreshold 只有 loadConfig 会读(ReflectionFactory.java:696-703),而 loadConfig 只有老路径会调用。JDK 25 的 src.zip 里,ReflectionFactory、Constructor、Method、Field 全部文件搜一遍「inflation」,一条命中都没有;jdk/internal/reflect 下也没有 NativeConstructorAccessorImpl、DelegatingMethodAccessorImpl、MethodAccessorGenerator 这三个文件。JDK-8305104「Remove the old core reflection implementation」把老实现删掉,Fix Version 是 22;JEP 416 自己的「Risks and Assumptions」一节也预告过这件事:-Djdk.reflect.useDirectMethodHandle=false 这个逃生口会失效。
所以两个 LTS 之间的差别是一整条机制被删掉,调参追不平。
七、什么时候值得多这一层
    graph TD
    Q1{"造哪个类,编译期就定得下来吗"} -->|是| A1["直接 new。多一层只会让读代码的人多跳一次"]
    Q1 -->|否| Q2{"决定依据来自哪"}
    Q2 -->|"进程启动时的配置、环境"| A2["一个 Supplier 字段或静态工厂方法就够了"]
    Q2 -->|"调用方用参数指定"| A3["接口 + 工厂方法,把实现注入进来"]
    Q2 -->|"运行期从名字、表、协议里读出来"| A4["反射查表,缓存 Constructor 或 MethodHandle"]
    A4 --> Q3{"创建频率高吗"}
    Q3 -->|"每秒百万次量级"| A5["缓存到 static final,让 JIT 常量折叠"]
    Q3 -->|"每秒几千次以下"| A6["保持反射,别过早优化"]
    A5 --> Q4{"返回的可以不是新对象吗"}
    A6 --> Q4
    Q4 -->|可以| A7["工厂方法升级成共享池或缓存,见享元"]
    Q4 -->|必须是新对象| A8["回到构造函数,别在工厂里藏状态"]
三条落地顺序:
- 先问需不需要工厂。只有「造哪个类」要在运行期决定时才需要这一层。
new能写死的地方写死,读代码的人少跳一次。 - 再看调用点会不会变多态。一个进程里有两个实现的接口,JIT 按双态内联,代价接近零;实现多到五六个、或者从插件里动态加载,调用点退化成查表,这时才需要把人手写的转发换成
MethodHandle(它自带@PolymorphicSignature,能绕开多态分派)。 - 最后把反射当缓存处理。
Constructor、Method、MethodHandle都塞进static final字段,让 JIT 常量折叠;参数要装箱的入口(newInstance(Object...))能不用就不用。JEP 416 的测量里,反射对象放在常量字段和放在数组元素上,构造耗时的差距是 32ns 对 114ns(他们的机器和基准,2021 年)。
什么时候不用工厂方法
- 类型只有一个实现,而且是编译期就能确定的。这时工厂方法只是一层命名。
- 创建动作本身有副作用需要顺序保证(比如必须先注册再返回)。先写清楚那个顺序,别藏在工厂后面。
- 为了「以后可能要换实现」而提前抽接口。要换的时候再抽,调用点是能改的。
总结
- 稳态下「多一跳」测不出代价。JDK 21 上
new、Supplier.get、单实现工厂函数、反射、invokeExact落在 4.07 到 4.52 纳秒之间;JDK 25 上落在 2.08 到 3.32 纳秒之间。差异的方向在两个 JDK 之间还会翻。 - 能测出来的是分配。反射入口的
Object...要装箱,JDK 21 上每次创建 56 字节对 24 字节;关掉标量替换后是 80 字节对 24 字节,多出来的正好是两个Integer加一个参数数组。 - 调用点从单态变成五态,代价才出现:6.12 对 4.28 纳秒(JDK 21)、5.60 对 4.08 纳秒(JDK 25)。
- 第一次创建的量级差最大。第一次
newInstance是 2.27 到 3.30 毫秒,其中一次性基础设施占大头;换一个类再装一次访问器只要 49 到 59 微秒,第二次调用 7 到 9 微秒,进了编译循环 2 到 3 纳秒。 sun.reflect.inflationThreshold的作用范围比名字看起来窄。JDK 21 默认不用它,只有打开-Djdk.reflect.useDirectMethodHandle=false走老实现时才生效(阈值 15 与 100 万相差六点六倍);JDK 25 无论怎么传都无效,JDK-8305104 在 22 删掉了老实现。
参考资料
- JEP 416: Reimplement Core Reflection with Method Handles
- JDK-8305104: Remove the old core reflection implementation
- Constructor (Java SE 25)
- MethodHandle (Java SE 25)
- MethodHandles.Lookup (Java SE 25)
- Supplier (Java SE 25)
- Thread.Builder (Java SE 25)
- Integer (Java SE 25)
- ThreadMXBean (Java SE 25)
系列索引:设计模式系列