设计模式——外观:批量接口的价值
外观模式的公开描述是「为子系统提供统一接口」。这句话在评审里没有用,谁也说不清「统一」到什么粒度。
换一个可测量的说法:外观把 N 次细粒度调用收成 1 次粗粒度调用,收益上限就是省下的那 N-1 次调用的固定成本。
本文写一万条小记录:逐条裸写、套缓冲、内存拼装后单次写,用 write(2) 计数和两种 JDK 的耗时给这三条路的差价结账,再看 JDK 自己怎么做外观。
一、把「统一接口」换成调用次数
外观模式的介绍通常画一张图:客户端指向一个 Facade 类,Facade 再指向三个子系统的类。图里没有数字,读完记不住任何可执行的东西。
把接口设计换成计费问题就具体了。每次调用都有一条固定成本:跨边界的开销。这个边界可能在进程之间、网络之间、内核与应用之间,也可能就在模块之间。外观把 N 次调用合并成 1 次,收益就是省下的 N-1 条固定成本;代价是这次合并本身要付参数打包、错误语义合并、内存占用的账。
写文件的例子把这两种成本都摆了出来。同样一万条记录、同样的字节,三种写法:
- 逐条
FileOutputStream.write(byte[]),每条一次系统调用。 - 套一层
BufferedOutputStream,调用次数不变,系统调用按缓冲大小摊销。 - 先在内存里拼成一个数组,最后
write一次。
调用次数和耗时这两把尺子量出来的差距不一样大。
外观与相邻模式的边界:装饰器不改接口,只在接口上叠行为;适配器改接口形状,把不兼容的调用变成兼容的调用;桥接拆的是两个独立变化的维度。外观不改变单个调用的形状,它减少调用的次数,把一串调用换成一个入口。
把 JDK 里的外观拆开看,有三种做法,本实验三条路各占一种:
| 做法 | 例子 | 调用次数怎么变 | 代价 |
|---|---|---|---|
| 摊销 | BufferedOutputStream |
应用层不变,系统调用按缓冲大小摊薄 | 用户态缓冲、延迟、崩溃时丢最后一段 |
| 合并 | Files.write(path, lines) |
一万次调用收成一次 | 需要一次性拿到全部参数 |
| 编排 | Files.copy、FileChannel.transferTo |
多个子系统调用收成一次 | 具体走哪条实现由 JDK 决定,调用方看不见 |
三种做法在调用次数上的收益量级依次变大,代价也依次变重。总纲那篇量过 Visitor、Strategy、Command、Template Method 的代码行数与耗时,这里换成调用次数与系统调用次数:外观的收益上限,取决于它能把 N 收到多小。
调用次数有两层:应用层的调用和跨越边界的调用。BufferedOutputStream 把第二层从 10,000 收到 64,第一层不动;Files.write(lines) 把第一层也收掉了,调用方只发一个请求。两层收益的量级不同,本实验把它们分开量。
    graph TD
    subgraph P1["逐条裸写:N 次系统调用"]
        A1["应用循环 10,000 次"] --> S1["FileOutputStream.write(byte[52])"]
        S1 -->|"每条一次"| K1["内核 write(2) ×10,000"]
    end
    subgraph P2["套缓冲:系统调用降两个数量级"]
        A2["应用循环 10,000 次"] --> S2["BufferedOutputStream 8192 字节缓冲"]
        S2 -->|"缓冲区满才刷"| K2["内核 write(2) ×64"]
    end
    subgraph P3["内存拼装:一次调用"]
        A3["应用在内存拼 520,000 字节"] --> S3["一次 write(byte[520000])"]
        S3 -->|"一次"| K3["内核 write(2) ×1"]
    end
二、实验设计
数据与四个变体
一万条记录,每条 52 字节的定长文本行,形如 id=000042,sku=SKU-0155,qty=42,price=13.94,note=n046。总量 520,000 字节。记录从一个 64 条的池子里循环取,字符串转字节只做一次,计时循环里没有 String.format、没有字符集编码、没有分配。三个写法写出的字节必须逐字节相同,否则比较无意义。
raw:FileOutputStream.write(byte[]),逐条。buffered:BufferedOutputStream(FileOutputStream, 8192),逐条写同样的数组。assembled:先在内存里拼好 520,000 字节的数组,一次write(byte[])。bytewise:同一个文件、同一批字节,但每次只写一个字节(write(int)),把调用粒度再降一格,用来看成本模型在 N 放大 52 倍时是否还成立。
校验方式是把所有输出文件(含下面提到的两个 JDK 自带 API)都算 SHA-256,前 8 字节全部相同:7147638db3034d31。一万条记录的文件大小都是 520,000 字节。
再加两个对照,用的是 JDK 自己的外观:Files.write(path, lines) 与 Files.write(path, bytes)。前者接收 List<String> 加平台换行,后者接收一个字节数组。它们不是本篇要比较的写法,是用来观察 JDK 把「一行调用」翻译成多少次底层操作。
系统调用计数怎么拿
macOS 上 dtruss 被系统完整性保护挡住,dtrace: failed to execute .../bin/java: Operation not permitted。fs_usage 的输出是系统级事件流,过滤短命的 JVM 进程不现实。这一段在装饰器篇已试过一遍,本篇沿用同一条路。
写一个 dylib,在 __DATA,__interpose 段里替换 write、open、close 三个 libc 符号,用 DYLD_INSERT_LIBRARIES 注入 JVM。每次进入 my_write 就是一次真实的 write(2),按 fd 归因到打开时的路径,进程退出时打印:
1 | static ssize_t my_write(int fd, const void *buf, size_t n) { |
计数口径能互相验证:写入字节数按路径求和后必须等于文件大小,测得 520,000 与 5,200,000 两个总量都与 ls -l 一致;JVM 自己的类文件、字体文件也有写操作,按路径过滤掉。这两个事实让计数可信。
计时怎么拿
计时循环放在全局文件锁内,一次只跑一个基准,避免并行任务抢 CPU。每个变体先跑 2 轮预热丢弃,再跑 5 轮取中位数。JDK 21.0.8 与 JDK 25 各跑一遍。取值区间用最小值和最大值一起报,不报标准差。
另有两个探针,都不需要计时,用来量外观的两种代价:
- 故障探针:每条路各写 7,437 条记录,然后
Runtime.halt()结束进程,不 flush、不 close,再从进程外看文件里剩下多少字节。进程崩掉时,有意义的问题是:有多少数据根本没有离开过用户态。 - 内存探针:把记录数放大到 100 万条(52 MB 负载),用
-Xmx32m跑buffered与assembled,看谁先撞墙,并记录堆峰值。
这是一台 Apple M1 Pro 上的单机微基准,不是 JMH,没有 fork 隔离,只用来判断量级。JVM 启动、类加载、文件系统页缓存的冷热都会进来。绝对耗时不能当硬件上限读,比值要看两个 JDK 是否给出相同方向。
    sequenceDiagram
    participant App as 应用代码
    participant Buf as BufferedOutputStream
    participant OS as 内核
    Note over App,OS: 逐条裸写
    App->>OS: write(52B) ×10000
    Note over App,OS: 套缓冲(8192 字节)
    App->>Buf: write(52B) ×10000
    Buf->>OS: write(8164B) ×63
    Buf->>OS: write(5668B) ×1(close 时收尾)
    Note over App,OS: 内存拼装
    App->>App: System.arraycopy 拼接 520,000 字节
    App->>OS: write(520000B) ×1
三、实测
两张尺子量同一件事
先看系统调用次数。一万条记录在两种 JDK 下的计数一致:
| 写法 | 应用层 write 调用 | write(2) 次数 |
每次系统调用平均字节 |
|---|---|---|---|
raw 逐条裸写 |
10,000 | 10,000 | 52 |
buffered 8192 缓冲 |
10,000 | 64 | 8,125 |
assembled 拼装单写 |
1 | 1 | 520,000 |
Files.write(lines) |
1 | 64 | 8,125 |
Files.write(byte[]) |
1 | 64 | 8,125 |
bytewise 单字节写 |
520,000 | 520,000 | 1 |
再看待机耗时,取 5 轮中位数:
| 写法 | JDK 21.0.8 | JDK 25 | 单条记录成本(JDK 25) |
|---|---|---|---|
raw 逐条裸写 |
19.59 ms | 23.62 ms | 2,362 ns |
buffered 8192 缓冲 |
0.74 ms | 0.78 ms | 78 ns |
assembled 拼装单写 |
0.29 ms | 0.20 ms | 20 ns |
bytewise 单字节写 |
891 ms | 883 ms | 88,310 ns |
Files.write(lines) |
4.92 ms | 1.96 ms | 196 ns |
Files.write(byte[]) |
0.79 ms | 0.56 ms | 56 ns |
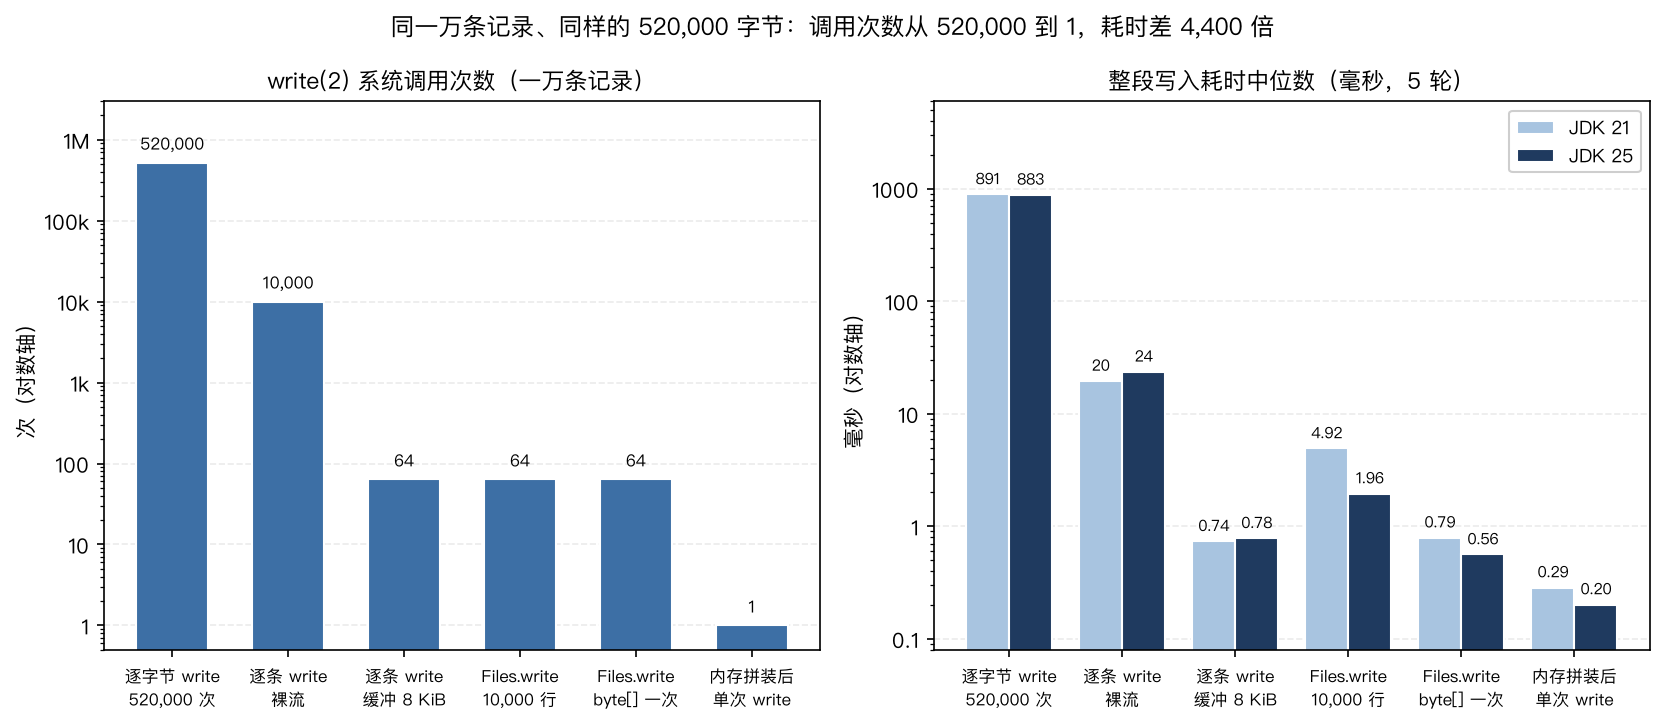
裸写比拼装慢 117 倍(JDK 25)和 68 倍(JDK 21),系统调用次数差 10,000 倍。两者的关系可以算成一个斜率:裸写与缓冲写法相差 9,936 次系统调用,中位耗时相差 22.84 ms,摊下来每次 write(2) 约 2.3 微秒。这个数字只对本机、本文件系统、这个记录形态成立,换台机器要重测。
重复性。 同一批测量在两个锁窗口里各跑了一遍。差异最大的是 raw:第一次 25.99 ms 与 24.34 ms,第二次 19.59 ms 与 23.62 ms,波动约 25%。Files.write(lines) 的波动更大(第二次的 JDK 21 落在 2.61 ms 到 9.04 ms 之间)。表格用的是第二次的完整数据。下面的结论只建立在量级上,例如「裸写与拼装相差两个数量级」,这类结论在两次测量里都成立。
一行 Files.write(path, lines) 顶掉了一万次 write 调用,代价是 1.96 ms(JDK 25),比手动编码加缓冲的 0.78 ms 慢 2.5 倍。这一份差价来自一次性的字符串编码:写同一批字节的 Files.write(path, bytes) 只要 0.56 ms,与手写缓冲同档,写入路径本身没有多花时间。
把量放大十倍再看
记录数从 1 万涨到 10 万,字节从 520,000 涨到 5,200,000:
| 写法 | 1 万条的 write(2) |
10 万条的 write(2) |
增长倍率 | 10 万条耗时 JDK 21 / JDK 25 |
|---|---|---|---|---|
raw |
10,000 | 100,000 | 10.0 | 195.2 ms / 191.4 ms |
buffered |
64 | 637 | 10.0 | 8.85 ms / 7.72 ms |
assembled |
1 | 1 | 1 | 2.13 ms / 2.42 ms |
Files.write(lines) |
64 | 635 | 9.9 | 10.27 ms / 9.56 ms |
Files.write(byte[]) |
64 | 635 | 9.9 | 4.00 ms / 4.45 ms |
除拼装写法外,调用次数随 N 线性增长,耗时也按同一倍率放大:裸写从 23.62 ms 涨到 191.4 ms(8.1 倍),缓冲从 0.78 ms 涨到 7.72 ms(9.9 倍)。拼装写法的耗时从 0.20 ms 涨到 2.42 ms,涨幅来自那一次 5,200,000 字节的 write,系统调用次数始终是 1。
线性关系决定了这个模式的适用面:细粒度调用的成本正比于 N,粗粒度调用的成本正比于数据量本身。N 越大,两条线的差距越大。
把粒度再降一格
同一个文件、同一批 520,000 字节,改成每次写一个字节:系统调用计数是 520,000 次,与应用层调用次数相等,写出的字节与前几种写法逐字节相同。
| 写法 | 应用层 write 调用 | write(2) 次数 |
每次系统调用平均字节 | 耗时中位数 JDK 21 / JDK 25 |
|---|---|---|---|---|
bytewise 单字节写 |
520,000 | 520,000 | 1 | 891 ms / 883 ms |
按前面的斜率 2.3 微秒算,520,000 次系统调用预期约 1.2 秒,实测 0.88 秒,单字节写的每次系统调用比 52 字节写便宜三成,因为要搬的数据少。这条例子把模型的两端连起来:调用次数从 1 涨到 520,000,耗时从 0.20 ms 涨到 883 ms,比值约 4,400 倍。中间几条写法(10,000 次的裸写、64 次的缓冲)都落在这条直线上,斜率由系统调用次数决定。
缓冲层的两次记账
buffered 在 1 万条时是 64 次,10 万条时是 637 次,都不是 8192 除下来的整数:刷写以 52 字节的整条记录为单位,除不尽。
- 缓冲区 8192 字节,能放 157 条完整记录,占 8,164 字节,第 158 条放不下。
- 第 158 条触发刷写,下一次又从零开始攒。
- 10,000 条 → 63 次满刷,剩下 109 条在
close()时刷出,合计 64 次。 - 100,000 条 → 636 次满刷,剩下 148 条在收尾时刷出,合计 637 次。
637 = ⌈100000 ÷ 157⌉,账对得上。这也解释了为什么缓冲的价值要看记录大小与缓冲大小的比值:8192 字节的缓冲区摊在 52 字节的记录上有 157 倍放大,摊在 8,000 字节的记录上只有 1 倍,套缓冲就没意义了。
缓冲省掉了什么,没省掉什么
buffered 与 assembled 的系统调用只差 63 次,耗时差 3.9 倍(0.78 ms 对 0.20 ms)。这 0.58 ms 花在那 10,000 次 Java 层调用上:每次进入 BufferedOutputStream.write 要拿一次锁、做一次边界检查、一次 System.arraycopy,合计 520,000 字节的搬运。78 ns 一条的成本主要出在这些操作上,不在系统调用。
外观的三层收益,量级依次是:
- 系统调用次数,从 10,000 到 64,量级差。这是主要收益。
- Java 层调用次数,从 10,000 到 1,但剩下的成本是纳秒级。
- 调用方代码行数,从一行循环变成一行调用。
第一层决定要不要做,第二层决定能省到什么程度,第三层是前两层的结果。
故障时落盘多少
合并调用次数会把失败的单位一起合并。每条路写 7,437 条记录(386,724 字节)后立刻 halt(),不 flush 不 close,文件里剩下的字节是:
| 写法 | 文件里剩下的字节 | 记录数 | 丢失的数据在哪 |
|---|---|---|---|
raw 逐条裸写 |
386,724 | 7,437 | 没有丢失,全部已交给内核 |
buffered 8192 缓冲 |
383,708 | 7,379 | 58 条(3,016 字节)在用户态缓冲区 |
assembled 拼装单写 |
0(文件不存在) | 0 | 全部 7,437 条还在内存里,没开始写 |
这些数字都对得上账:3,016 = 58 × 52,7,379 = 47 × 157。缓冲写法每 157 条刷一次,崩溃时缓冲区里正好是下一批没攒满的零头。拼装写法更极端,进程死之前一次 write 都没发出,文件还是空的。
失败可见性是外观容易被忽略的一项代价:Files.write(lines) 这类接口把「一万次写」变成一个动作,出错时调用方只看到一个异常,看不出写到了第几条。数据在磁盘上的可见性也跟着变了:缓冲写法的可见性以 8,164 字节为粒度,拼装写法以整批为粒度。
内存的天花板
把记录数放大到 100 万条,负载 52 MB,堆限制 32 MB,两个 JDK 上的结果一样:
| 写法 | 堆峰值 | 结果 |
|---|---|---|
buffered 8192 缓冲 |
2.4 MB(JDK 21)/ 2.1 MB(JDK 25) | 正常写完 52,000,000 字节 |
assembled 拼装单写 |
撞到堆上限 | OutOfMemoryError |
缓冲写法的内存占用是常数:一个 8,192 字节的数组,与批量大小无关。拼装写法要求一次拿到 52 MB 的连续数组,堆给不出来就失败。批量的规模上限由内存决定,这是外观设计时要写进文档的参数。JDK 自己清楚这一点,所以 Files.write(byte[]) 的 8192 分块(下面源码一节)不要求调用方一次性交出全部数据。
两个探针的结果合起来:外观减少调用次数靠的是「攒」,攒在用户态缓冲里,代价是失败可见性与内存占用。这两项在调用次数那张表里看不到。
四、JDK 源码里的外观
JDK 里这类外观到处都是。我按 JDK 25 src.zip 逐条对了一遍上面用到的和没用到的方法,看它们把 N 收敛到什么程度。
BufferedOutputStream:批量刷写的账本
JDK 25 的 BufferedOutputStream 有两个常量,一个初始值一个上限(java.base/java/io/BufferedOutputStream.java:46-47):
1 | private static final int DEFAULT_INITIAL_BUFFER_SIZE = 512; |
显式传缓冲大小时两个值取同一个数(:116-118),write(byte[], int, int) 的逻辑是这里的关键(:177-192):
1 | public synchronized void write(byte[] b, int off, int len) throws IOException { |
实测的数字来自这段逻辑。写入请求不小于缓冲上限时直接透传,不做二次拷贝。装不下的记录触发一次刷写再落到位,缓冲区攒到 8,164 字节就刷,离 8,192 差 28 字节,放不下第 158 条 52 字节的记录。flushBuffer 只有 4 行(:121-126),它把 out.write(buf, 0, count) 交给下层,这是几种写法里唯一一处把多次调用合并成一次的地方。
write(int) 和 write(byte[], int, int) 都带 synchronized。这一层锁是为了单流多线程安全,代价出现在每条记录 78 ns 的成本里。
Files.write(byte[]):分块是自己写的
调用方写一行 Files.write(path, bigArray),进到 java.base/java/nio/file/Files.java:3168-3184 是这样:
1 | public static Path write(Path path, byte[] bytes, OpenOption... options) |
BUFFER_SIZE 在同文件 :95 声明,值是 8192。「一次性写入」在 JDK 这里同样是 8192 字节一块,5,200,000 字节分 635 块,与实测的 635 次系统调用对应。名字叫一次 write,底下是 635 次。
Files.write(lines):一行调用,两万次内部调用
另一个重载更接近本文的场景,接收行列表(Files.java:3229-3244):
1 | public static Path write(Path path, Iterable<? extends CharSequence> lines, |
调用方写一行,JDK 内部做了 10,000 次 append、10,000 次 newLine,再经过 BufferedWriter 的 8192 字符缓冲与 OutputStreamWriter 的 8192 字节编码缓冲,落到 64 次系统调用。这三段容量都能在源码里查到:字符缓冲 512 起步、上限 8192(java.base/java/io/BufferedWriter.java:75-76),编码器字节缓冲的上限同样是 8192(java.base/sun/nio/cs/StreamEncoder.java:44 的 MAX_BYTE_BUFFER_CAPACITY),最里面的 Files.write 分块还是 8192。
成本也在源码里。每写一行要两次加锁的调用:write(String, int, int)(BufferedWriter.java:271-285)持锁把字符拷进缓冲,newLine()(:294-296)再走一遍:
1 | public void newLine() throws IOException { |
一万行记录,两万次加锁与字符拷贝,加上一次性的 UTF-8 编码,就是 Files.write(lines) 相对手写缓冲多付的约 1.2 ms。外观把这些内部调用接了过去:谁做合并、合并到多大、编码放在哪一层,调用方不再关心,也改不了。
实测里 Files.write(lines) 比手写 buffered 慢 2.5 倍(JDK 25 的 1.96 ms 对 0.78 ms),差的就是这一次性编码。省调用次数的收益是量级差,编码成本约 1.2 ms,这个代价可以接受。
同名方法在父类里是展开
BufferedOutputStream 的父类把同一个方法写成相反的方向(java.base/java/io/FilterOutputStream.java:135-141):
1 | public void write(byte[] b, int off, int len) throws IOException { |
父类的批量方法把一次调用拆成 len 次单字节调用,子类覆写之后改成攒进缓冲。BufferedOutputStream 在类图上只是一层包装,行为上把父类的展开反了过来。判断一个类是不是外观,看它的 write(byte[], int, int) 往下一层发了几次调用,与它在类图上的位置无关。
FilterOutputStream 里也有纯转发的方法,write(int) 就一行 out.write(b)(FilterOutputStream.java:88-90),flush() 同理(:154-156)。一次调用换一次调用,这类方法只是转发;把 N 次调用收成一次,才是外观。
Files.copy:外观按 provider 分派
同一份拷贝操作,Files.copy 分两条路(Files.java:1186-1198):
1 | public static Path copy(Path source, Path target, CopyOption... options) |
两个路径同文件系统时走 provider 自己的实现,本机上是 sun.nio.fs.UnixFileSystem.copyFile,里面先尝试平台直接拷贝(UnixFileSystem.java:642-655,macOS 上是 copyfile(3) 一类),失败才退回到 ByteBuffer 缓冲循环。跨文件系统时走 CopyMoveHelper.copyToForeignTarget,它最后落到(CopyMoveHelper.java:146-148):
1 | try (InputStream in = Files.newInputStream(source)) { |
而 Files.copy(InputStream, Path, ...) 的收尾是 Files.java:2864 的一行 return in.transferTo(out);。一次 Files.copy 表面是一个调用,底下可能是一次 copyfile 系统调用、一个 8192 字节的循环,或者 transferTo 的三层机制。外观替调用方做了选择,调用方看不到自己拿到了哪一种。
transferTo:三层机制藏在一个名字后面
InputStream.transferTo 是 JDK 9 引入的粗粒度 API,默认实现(java.base/java/io/InputStream.java:790-806)是一个 16,384 字节缓冲的循环:
1 | public long transferTo(OutputStream out) throws IOException { |
它的默认缓冲是 16,384 字节(同文件 :58 的 DEFAULT_BUFFER_SIZE),与 BufferedOutputStream 的 8192 不同。16 KiB 这个数在 JDK 里反复出现:FileChannelImpl 里 mmap 路径的门槛 MAPPED_TRANSFER_THRESHOLD 也是 16 KiB(java.base/sun/nio/ch/FileChannelImpl.java:840)。
FileChannel.transferTo 走的层数最多。它的 javadoc 承诺(java.base/java/nio/channels/FileChannel.java:627-630):
1 | * <p> This method is potentially much more efficient than a simple loop |
实现是三级瀑布(FileChannelImpl.java:962-975):
1 | // Attempt a direct transfer, if the kernel supports it, |
1 | // fallback to read/write loop |
第一层是 sendfile 或 copy_file_range 一类的零拷贝(FileChannelImpl.java:785-788 的注释写着 This implementation uses sendfile, copy_file_range or equivalent.),只支持文件到文件、文件到 socket 两种目标。第二层是 mmap,门槛 16 KiB,上限 8 MiB(:840-843)。第三层退回 8192 字节的读写循环(:1078 的 TRANSFER_SIZE = 8192)。
一个方法名下面是三种搬运机制,调用方一句 transferTo(0, size, target) 就要接受其中任意一种。外观在这里收敛了两样东西:调用次数和实现差异,代价是性能特征从调用方视野里消失。
五、什么时候做外观,什么时候不做
判据流程
    graph TD
    Q0["这段逻辑在一轮业务里重复调用多少次"] --> Q1{"N 是否超过约 100"}
    Q1 -->|"否"| A1["保持细粒度调用,外观只会增加一层需要维护的转发"]
    Q1 -->|"是"| Q2{"多次调用的参数能否一次性拿到"}
    Q2 -->|"不能"| A2["做不了批量接口,改从减少调用次数之外的方向做优化"]
    Q2 -->|"能"| Q3{"结果可以攒在内存里吗"}
    Q3 -->|"可以"| A3["拼装成一次粗调用,系统调用次数与 N 脱钩"]
    Q3 -->|"不可以"| Q4{"失败时是否需要定位到具体某一条"}
    Q4 -->|"需要"| A4["用缓冲或流水线,保留逐条的调用位置与错误上下文"]
    Q4 -->|"不需要"| A5["用批量 API,同时把整批的失败语义定义清楚"]
N 的门槛不是拍出来的。本机上一次 write(2) 约 2.3 微秒,一次 Java 层的加锁加拷贝约 78 纳秒,相差 30 倍。N 小于 100 时,细粒度调用的总成本不超过 0.25 ms,抵不过多一层抽象带来的维护成本。
批量接口改掉的东西
批量接口换掉的还有语义。下面四条都有本实验的数字。
内存峰值与批量规模绑定。 缓冲写法的堆峰值是 2.1 MB(JDK 25,100 万条记录),拼装写法在同样的 -Xmx32m 下直接 OutOfMemoryError。批量的上限由堆决定,接口文档里要写清楚这个上限,或者像 Files.write(byte[]) 一样内部分块,把单次分配的规模压回 8 KiB。
失败可见性以批为单位。 同样是写到 7,437 条时进程崩溃,逐条写留下 386,724 字节,缓冲写法留下 383,708 字节,拼装写法留下 0 字节。异常信息能定位到失败的批,定位不到第几条。
延迟攒在批里。 攒批意味着最后一个字节要等到批满或显式关闭才可见。BufferedOutputStream 的 flush() 要手动调,忘了它,最后一次没刷满的部分就留在缓冲区里(一万条时是 5,668 字节)。批量接口的写入时机要写进文档,不能留给调用方猜。
错误定位精度下降。 一万条一次写入,第 7,437 条出错时异常只带一个偏移量,调用方需要自己换算回记录序号。逐条写能在出错处停下并保留上下文。需要定位问题时,缓冲写法是折中:调用位置仍在循环里,系统调用按批摊薄,出错可以立刻停止并丢掉未刷出的部分。
一条判断顺序
按这个顺序问,四个问题都能答「是」再做批量外观:
- 这个边界上的单次调用成本是否远高于数据搬运成本。本机上是 2.3 微秒对 78 纳秒,差 30 倍。
- 一轮业务里的调用次数是否到百次量级。低于这个数,合并省下的时间小于接口带来的复杂度。
- 多条调用的参数能否提前拿到。拿不到就没有批量接口,只能做流水线。
- 失败时能否接受按批定位。不能接受就保留逐条调用,把成本花在别处。
第 2 条的阈值来自本机实测,换机器要重测。前两条决定值不值得做,后两条决定能不能做。
与相邻模式的边界
享元共享不可变对象,省的是内存;对象池复用可变对象,省的是构造与销毁。外观省的是调用次数,与内存关系不大,三个模式经常同时出现但解决的问题不同。
装饰器在不改接口的前提下叠行为,每次调用仍然只是一次转发,只是往下多走了几层,本实验里的 BufferedOutputStream 就是装饰器。同一个类既可以当装饰器用(保持 OutputStream 接口),也可以当外观用(把 N 次调用合并成 64 次)。模式的名字描述意图,不描述这个类在链上的位置。
适配器改变单个调用的形状,read() 变成 readLine();外观不改变形状,改变次数。一个方法同时做到两件事时,先想清楚调用方需要的是哪一个。
总结
- 一万条 52 字节的记录,520,000 字节,三种写法的
write(2)次数是 10,000、64、1,耗时中位数是 23.62 ms、0.78 ms、0.20 ms(JDK 25)。裸写与拼装差 117 倍。 - 每次
write(2)的边际成本约 2.3 微秒(两个 JDK 的差值方向一致)。这个数字决定了批量接口的盈亏平衡点:调用次数低于百次量级时,合并的意义不大。 - 调用次数随记录数线性增长:10 万条时分别是 100,000、637、1 次,倍率分别是 10.0、10.0、1.0;耗时按同样倍率放大(裸写 191.4 ms,缓冲 7.72 ms)。
- 单字节写同一批数据要 520,000 次系统调用,耗时 883 ms,是拼装写法的 4,400 倍。本实验的全部写法都落在调用次数与耗时的那条直线上。
BufferedOutputStream每次攒满 8,164 字节就刷(157 条记录),剩下的零头在close()时刷出,所以 10 万条对应 637 次而不是 635 次。缓冲大小的收益取决于记录大小与缓冲大小的比值。- 缓冲写下每条记录的成本约 78 纳秒,主要来自
synchronized与System.arraycopy,不是系统调用。系统调用从 10,000 降到 64 的收益是量级差,Java 层调用从 10,000 降到 1 的收益是纳秒级。 - 合并调用次数会把失败也合并:写到 7,437 条时进程崩溃,逐条写留下 386,724 字节,缓冲写留下 383,708 字节,拼装写留下 0 字节。内存上限同样绑在批量规模上:100 万条记录在
-Xmx32m下,缓冲写法的堆峰值是 2.1 MB,拼装写法直接OutOfMemoryError。 - JDK 自己的外观也是这么分层的:
Files.write(byte[])内部按 8192 字节分块(Files.java:95、:3177-3181),Files.write(lines)内部做 20,000 次 append 与 newLine 后落到 64 次系统调用(:3229-3244)。实测后者慢 2.5 倍,差额来自字符编码;写同一批字节的Files.write(byte[])只要 0.56 ms,与手写缓冲同档。 FileChannel.transferTo一个方法名下面有三级实现:sendfile一类的零拷贝、16 KiB 门槛的 mmap、8192 字节的读写回退(FileChannelImpl.java:962-975)。外观同时隐藏了调用次数与调用方拿不到的性能特征。- 做外观的判据是调用次数、参数可批量、结果可缓冲、错误定位要求四条。无法一次性拿到参数、或必须逐条定位失败时,缓冲比合并更合适。
参考资料
- BufferedOutputStream (Java SE 25)
- Files (Java SE 25)
- InputStream (Java SE 25)
- FileChannel (Java SE 25)
- Facade — Refactoring.Guru
- Facade pattern — Wikipedia
- sendfile(2) — Linux man page
系列索引:设计模式系列