设计模式——中介者:谁负责协调
中介者把参与者之间的 N(N−1) 条引用换成 N 条,代价是所有人的调用都要经过它。
这笔代价有一半是虚构的:JIT 把只做转发的分发路径内联之后,它和直连编译成同一段代码,测不出差别。
另一半是真的,来自中介者自己持有的共享状态:一个轮转游标、一个全局序号、一把锁。
一、换掉的是引用,也是决定权
8 个参与者互相发事件。直连的写法是每个参与者持有其余 7 个的引用;中介者的写法是每个参与者只认识中介者。
    graph TB
    subgraph d["直连:参与者两两持有引用,8 个节点 56 条边"]
        direction LR
        D1((A)) --- D2((B))
        D1 --- D3((C))
        D1 --- D4((D))
        D2 --- D3
        D2 --- D4
        D3 --- D4
    end
    subgraph m["中介者:每个参与者一条引用,加上中介者的 8 条反向引用共 16 条"]
        direction LR
        M((Mediator))
        M --- E1((A))
        M --- E2((B))
        M --- E3((C))
        M --- E4((D))
    end
引用数从 56 降到 16 只是算术。变化的是谁决定接收方:直连时这个决定写在发送方的代码里(peers[t].onEvent(...),t 由发送方算出来),中介者时代码里只有一句 send(msg),收件人由中介者查出来。
把分散的决定集中到一处,这一处就成了所有分发都要经过的路径。
一次分发经过的层
    sequenceDiagram
    participant S as 发送方
    participant M as 中介者
    participant R as 接收方
    S->>M: send("peer-3", event)
    Note over M: 查注册表:hash + equals<br/>实测约 1.6 ns
    M->>R: onEvent(event)
    Note over R: 累计状态
    Note over S,R: 直连版本省掉的正是中间那一跳
二、实验设计与局限
四组实验,都在本机跑:Apple M1 Pro,10 个逻辑核(8 性能核 + 2 能效核),macOS Darwin 25.6.0,JDK 21.0.8 与 JDK 25,都是 arm64。同一台机器上同时有别的进程在编译,两次计时会话的 load average 分别在 7.1 和 10.0 之间,所以同一张表里的横向对比比绝对值可靠。
| 实验 | 问题 | 做法 |
|---|---|---|
| 一 | 多一层转发本身要多少钱 | 单线程,8 个参与者,分发 500 万个事件,点对点与广播各测一次,9 次取中位数 |
| 二 | 中介者成为热点是什么样子 | 1 / 4 / 8 个线程共用一个中介者,每个测量点固定 300 ms 时间预算,5 次取跨度最短的一次 |
| 三 | 引用换代价值不值得 | N 从 8 到 2048,数引用条数,用 -XX:+UseSerialGC 加 System.gc() 量堆占用 |
| 四 | 注册表变大以后查表贵不贵 | 注册表塞 8 到 100 万条,分发 300 万次,比「目标固定」和「目标散布全表」两种访问模式 |
实验一只测分发,接收方的 onEvent 只做一次累加。实验二的每个线程有自己的接收方对象,接收方之间的伪共享已经用填充字段排掉,剩下的差异全部来自中介者。实验二取「最短跨度」而不是中位数,因为机器上有别的负载,最短的那次最接近没有干扰的状态。
四个实验在同一个类里,每个实验一个入口,第三到第六节的数字就是这四行的输出:
1 | java -cp out MediatorBench exp1 5000000 9 # 500 万事件,9 次取中位 |
计时循环全程持一把全局文件锁,同一时刻本机只有一个计时进程在跑。
局限说清楚:
- 这是单机微基准,不是 JMH。用它判断量级和方向,不能当硬件上限。
- 全局锁只保证计时循环互相不重叠,拦不住机器上其他进程的编译和运行。第二组里直连与每线程独立槽在高线程数下也一起变慢,那部分是本机的负载,不属于代码的性质。
- 第二组测的是 8 个线程在 10 个核上跑,不是 8 个线程独占 8 个核。能效核和别的进程都会拉低高线程数的数字。
这几组实验没有覆盖的形状:接收方 onEvent 返回 void,所以没有返回值路径;分发是同步的,没有测「投进队列由别的线程处理」;中介者不做过滤,发送方指名道姓;也没有测中介者自身的失败路径。这些都会往上加成本,加的量级需要另外测。
三、实测一:一次事件从发出到送达
三种连接方式:直连(发送方直接拿着接收方的引用)、中介者按位次分发(中介者内部是一个数组)、中介者按名字分发(中介者内部是 HashMap<String, Peer>)。三种都做了 JIT 预热,测的是 500 万个事件的总耗时除以事件数。
| 分发方式 | JDK 21 ns/事件 | JDK 25 ns/事件 | 相对直连(JDK 25) |
|---|---|---|---|
| 点对点 直连 | 1.92 | 2.13 | — |
| 点对点 中介者按位次 | 1.84 | 1.94 | −9% |
| 点对点 中介者按名字 | 3.44 | 3.57 | +68% |
| 广播 直连 | 3.83 | 3.85 | — |
| 广播 中介者按位次 | 3.20 | 3.21 | −17% |
| 广播 中介者按名字 | 14.61 | 14.52 | +277% |
点对点每次事件送达 1 个接收方,广播每次事件送达 7 个,所以广播那一行的绝对值本来就该高。
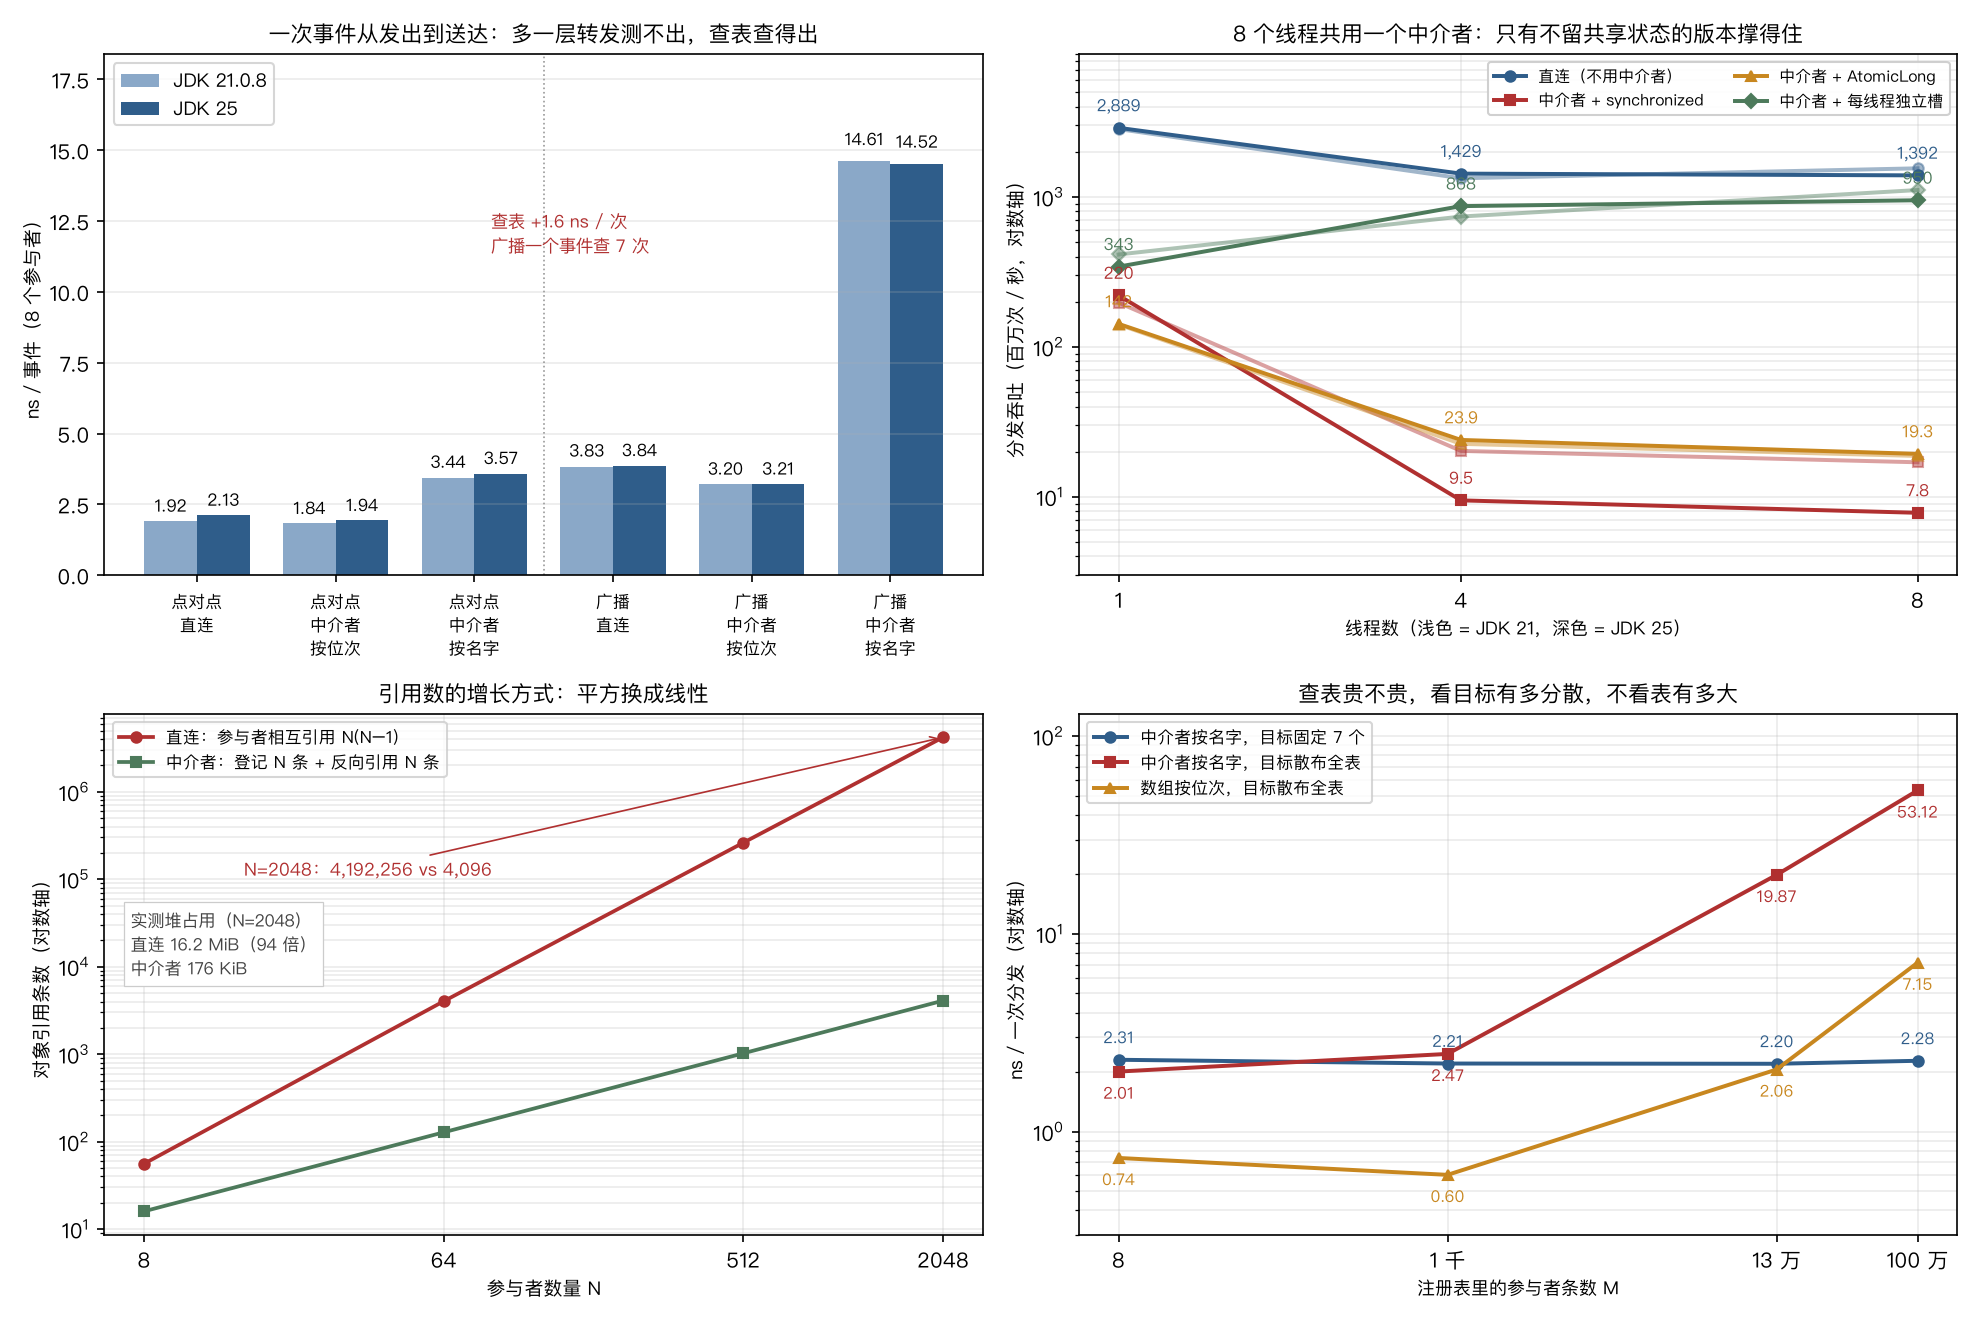
多一层转发测不出来
中介者按位次分发的两个数字都比直连低,两个 JDK 上方向一致,幅度 9% 到 17%。这个方向违反直觉,来源是内联。JDK 25 加 -XX:+UnlockDiagnosticVMOptions -XX:+PrintInlining 跑同一段代码,JIT 把转发方法和接收方方法都内联进了调用者的循环:
1 | @ 38 MediatorBench$ArrayMediator::dispatch (14 bytes) inline (hot) |
dispatch 那一次调用在机器码里不存在,按位次分发与直连编译出来是同一段代码。差别只在数组从哪个对象上取:直连经过发送方对象的字段,中介者经过中介者对象的字段。这点差别落在测量噪声里。
**结论:只要中介者只做转发、不留状态,就不构成可测开销。**两个 JDK、两种分发模式都没有出现稳定的正偏差。
花钱的地方是按名字找目标
按名字分发比按位次多的那部分,两种算法在两个 JDK 上互相验证:
| 口径 | JDK 21 | JDK 25 |
|---|---|---|
| 点对点:名字 − 位次 | 1.60 ns | 1.63 ns |
| 广播:(名字 − 位次) ÷ 7 | 1.63 ns | 1.62 ns |
一次 HashMap.get 配一个字符串比较值 1.6 ns。广播把这一项放大 7 倍:一个事件 14.52 ns 里有 11.3 ns 花在查表上,同样的 7 次转发走数组只要 3.21 ns。
1.6 ns 是转发一次成本的 5 倍多。这个倍数可以从表里推出来。把每次事件的固定开销记作 F、投递一次记作 D,JDK 25 上直连点对点是 F + D = 2.13 ns,直连广播是 F + 7D = 3.85 ns,两式相减得到 D ≈ 0.29 ns,回代得到 F ≈ 1.84 ns。投递一次 0.29 ns,查一次表 1.62 ns。
用名字并不算错。中介者的价值在于调用方不需要知道接收方的索引,send("order-created", e) 换来的可读性和可扩展性买的就是这 1.6 ns。这个决定要按事件频率算账:每秒钟 10 万次分发,1.6 ns 合计 0.16 ms,谁都不用管;每秒钟 1 亿次,它变成 160 ms 的纯开销,那时候就该把名字换成整数 id,或者把注册表做成数组。
广播时多出来的工作量落在谁头上
广播那一组还有一个结构上的差别,数字里能看出来。直连广播时发送方线程自己跑完 7 次投递,一次事件 3.85 ns;中介者广播时发送方只调一次 send,剩下的 7 次投递在中介者的栈帧里完成,一次事件 3.21 ns。两者差不多,说明在这个规模下多一次调用和少一次调用没区别,但工作量的归属变了。
这一点在真实系统里的表现是延迟归因。直连时一条事件的延迟记在发送方的调用栈上,中介者时记在中介者身上,而中介者是所有人的。后面几节的数字都在说同一件事:中介者身上的每一纳秒都要乘以分发次数,广播直接把这个倍数乘上扇出。
四、实测二:8 个线程共用一个中介者
中介者既然要决定收件人,就难免要记住点什么:轮转游标、全局序号、当前在线人数、限流计数。这一组量它记住东西之后的代价。
四个版本,接收方都是每个线程自带的对象,所以差别全部来自中介者的状态:
- 直连:不用中介者,线程直接调用自己的接收方。
- 中介者 + synchronized:
synchronized方法里推进游标、取接收方、调用。 - 中介者 + AtomicLong:
getAndIncrement()拿序号,接收方数组只读。 - 中介者 + 每线程独立槽:每个线程在中介者里有一个自己的槽位,互不触碰。
表格每格是「吞吐(百万次/秒) / 每次分发占用的单线程时间」。
四个版本的中介者长这样。共享状态是那个游标,接收方数组在三种版本里都只读:
1 | // 中介者 + synchronized:游标和分发在一个锁里 |
三个版本的业务语义一样:给这次分发编号,然后交给接收方。差别只在序号由谁维护。
| 线程数 | 直连 | 中介者 synchronized | 中介者 AtomicLong | 中介者 每线程独立槽 |
|---|---|---|---|---|
| 1(JDK 25) | 2,889 / 0.35 ns | 220.2 / 4.54 ns | 142.3 / 7.03 ns | 342.7 / 2.92 ns |
| 4(JDK 25) | 1,429 / 2.80 ns | 9.5 / 422.5 ns | 23.9 / 167.1 ns | 868.0 / 4.61 ns |
| 8(JDK 25) | 1,391.8 / 5.75 ns | 7.8 / 1,022.8 ns | 19.3 / 413.8 ns | 949.7 / 8.42 ns |
| 1(JDK 21) | 2,833.5 / 0.35 ns | 197.1 / 5.07 ns | 140.9 / 7.10 ns | 413.0 / 2.42 ns |
| 4(JDK 21) | 1,331.5 / 3.00 ns | 20.2 / 197.7 ns | 22.5 / 177.4 ns | 739.6 / 5.41 ns |
| 8(JDK 21) | 1,551.0 / 5.16 ns | 17.0 / 470.8 ns | 18.7 / 427.3 ns | 1,111.0 / 7.20 ns |
零竞争下中介者就已经不便宜
单线程那一行的三个中介者版本和直连差了 8 到 20 倍。这时候队列里没有第二个线程,也没有人来抢锁。
代价分两块。一块是锁:一次没人竞争的 monitorenter 加 monitorexit 在 M1 上要 4.54 ns,是直连 0.35 ns 的 13 倍。另一块是 AtomicLong.getAndIncrement() 在无竞争时也要 7.03 ns,因为它在 ARM 上是一条独占加载加一条条件存储的循环,比一次普通读改写贵得多。
**中介者的分发路径上只要出现一次同步原语,成本就从「纳秒的零头」跳到「几个纳秒」。**这个跳跃和参与者有几个、事件发到哪里都无关。
8 线程下差 121 倍
线程加到 8 个,8 个线程一起进同一个中介者。JDK 25 那一行:
- 直连 1,391.8 百万次/秒,中介者每线程独立槽 949.7 百万次/秒。两者都是「没有共享可变状态」的形状,高线程数下的下降来自本机负载,不是代码。
- 中介者 AtomicLong 19.3 百万次/秒。8 个核抢同一个
AtomicLong,CAS 失败就要重来。 - 中介者 synchronized 7.8 百万次/秒,是同一行里每线程独立槽的 1/121,也是它自己单线程吞吐的 1/28。线程越多,吞吐越低。
锁的代价不在阻塞
用 JFR 数一下 jdk.JavaMonitorEnter(阈值设成 0 ns,记录所有走慢路径的监视器进入)。8 线程、150 ms 的窗口:
| 版本 | 分发次数 | JavaMonitorEnter 事件 |
|---|---|---|
| 中介者 synchronized | 5,559,808 | 7,338 |
| 中介者 AtomicLong | 2,862,592 | 1 |
7,338 ÷ 5,559,808 = 0.13%。挂起的操作只有千分之一多一点,剩下的 99.87% 都走的快速路径,而同一次运行里每次分发仍然要 222 ns。锁竞争的成本主要落在监视器字所在的那条 cache line 上:它要在 8 个核之间来回搬,每次进入监视器都得从上一个核手里抢过来。AtomicLong 那一行一个 JavaMonitorEnter 都没有(唯一那 1 个来自 JVM 内部),它不用监视器,可同一次运行里每次分发要 419.7 ns,和锁版本是同一量级。CAS 争的是同一条缓存行,换掉锁换不掉那条线。
这一条对设计有直接影响:**「我的临界区只有两行,所以加锁没关系」这个推理在竞争激烈的中介者上不成立。**临界区长度决定的是抢不到锁的线程等多久,决定不了 cache line 来回搬的次数。
同一段锁代码,两个 JDK 差一倍多
把两个 JDK 的 8 线程那一行并排看:JDK 21 的 synchronized 版本 17.0 百万次/秒,JDK 25 是 7.8。JDK 21 上 AtomicLong(18.7)和 synchronized(17.0)几乎打平,JDK 25 上是 19.3 对 7.8。字节码是同一份,差别在 JVM 的监视器实现,膨胀锁的排队策略和自旋策略在 JDK 22 到 25 之间改过几轮。
别把这理解成 JDK 25 变慢了。它说的是:拿锁版本的吞吐做容量规划,得钉死 JDK 版本量一遍,跨版本外推不可靠。相比之下,直连和每线程独立槽那一列的跨版本差异小得多,因为它们没有走同步原语。
中介者的状态,哪些能拆
能不能按线程拆开,要看状态的用途:
- 能拆的:每次分发的序号(每个线程自己编号,全局顺序本来就没保证)、统计计数(最后求和)、按发送方分片的限流配额、每个连接的缓冲。这类状态的用途是「累加」或者「局部」,拆开之后语义不变。
- 不能拆的:轮转负载均衡的游标(拆开就退化成每个线程各转各的)、全局唯一序号(拆开就不唯一)、容量上限(拆开之后总容量会超)、「谁是当前主节点」这类需要强一致的标志。
第四节的每线程独立槽属于第一类。第二类没法靠数据结构消掉,只能降低更新频率:批量取号(一次 CAS 拿 100 个号再在自己线程里分)、分片(把参与者按 hash 分成 8 组,每组一个游标)、或者改写协议让顺序不再需要全局保证。
这一节没有测量,把第四节的结果翻译成选择。判断某个状态能不能拆,问一句:**把它复制 8 份之后,系统还对不对?**对,就拆;不对,就往下走。
五、实测三:引用数随参与者数量怎么长
中介者省掉的引用可以数出来。N 个参与者两两互持是 N(N−1) 条;中介者是 N 条登记加 N 条反向引用。下表两列引用条数是按实际建出来的结构数的,堆占用用 -XX:+UseSerialGC 加三次 System.gc() 取前后差。
| 参与者 N | 直连引用条数 | 中介者引用条数 | 直连堆占用 | 中介者堆占用 |
|---|---|---|---|---|
| 8 | 56 | 16 | 4.9 KiB | 8.6 KiB |
| 64 | 4,032 | 128 | 21.5 KiB | 5.3 KiB |
| 512 | 261,632 | 1,024 | 1.05 MiB | 42 KiB |
| 2048 | 4,192,256 | 4,096 | 16.2 MiB | 176 KiB |
N = 8 那一行,中介者比直连多占 3.7 KiB。一个 HashMap 有自己的表数组和节点对象,参与者少到个位数时,这笔固定开销比省下的 40 条引用贵。中介者省内存这件事有起算点:N = 8 时它更占地方,到 N = 64 已经省下 16 KiB,N = 2048 时差 94 倍。
另一处是增长方式。参与者从 512 涨到 2048(4 倍),直连的引用涨 16 倍,中介者涨 4 倍。这个斜率差决定上限在哪:直连的 N 涨到几千,光是引用表就吃掉几十兆;中介者到几万都不会成为瓶颈。比省下来的那点内存更重要的是斜率。
六、实测四:注册表大了以后查表贵不贵
第三节量到查一次表 1.6 ns,那是在 8 个参与者的注册表里查。真实系统里注册表可能大得多。把注册表从 8 条塞到 100 万条,同时换两种目标访问模式:
- 目标固定 7 个:注册表很大,但事件只发给固定的那几个收件人。
- 目标散布全表:每次事件的收件人在整张表上跳(步长 7919 个条目),把注册表的每个角落都摸一遍。
| 注册表条数 M | 中介者 目标固定 7 个 | 中介者 目标散布全表 | 数组 目标散布全表 |
|---|---|---|---|
| 8 | 2.31 ns | 2.01 ns | 0.74 ns |
| 1,024 | 2.21 ns | 2.47 ns | 0.60 ns |
| 131,072 | 2.20 ns | 19.87 ns | 2.06 ns |
| 1,048,576 | 2.28 ns | 53.12 ns | 7.15 ns |
(JDK 25,300 万次分发取中位数。JDK 21 的同一组数方向一致,散布访问那一列的两组数相差 3 ns 以内。)
**查表成本由目标的分散程度决定。**注册表从 8 条涨到 100 万条,目标固定时查表成本纹丝不动,一直在 2.2 ns 上下,因为要查的那几个条目和它们的哈希桶一直待在缓存里。目标一旦散布到全表,成本从 2.0 ns 涨到 53 ns,26 倍,每一次查表都要把哈希桶、节点、键字符串挨个从内存里拉一遍。
数组分发也一起变慢(0.74 ns 到 7.15 ns),因为它也要去摸那 100 万个目标对象。区别是数组只需要一次引用加载,中介者查表要三次(桶、节点、值)。所以散布访问下中介者比数组贵 7.4 倍,而集中访问下两者差不多。
这一条修正了第三节的结论:1.6 ns 对应的是查一张热表。事件总线、插件系统、连接池这类中介者的注册表通常几十到几百条,参与者之间又总是少数几个人在通信,所以 2 ns 上下是个可靠的估计。真到了每次事件都发给不同的收件人、注册表又有几十万条的时候,按名字查表会变成整个系统最贵的一行。
要不要给中介者加索引,判据在这一节里:**看收件人的分布。**目标集中就不需要索引,几百万条的注册表照样是 2.2 ns;目标分散就该换成数组或者整数 id,十几万条的表已经要 19.9 ns。索引的常见做法是让发送方在注册时拿到一个整数句柄,之后按句柄分发,一次哈希就变成一次数组下标。代价是调用方又多了个要保管的东西:路由的耦合从「知道对方是谁」变成「知道对方的编号」。
七、JDK 里的三个中介者怎么处理自己的热点
JDK 自己有三个典型的协调者,都在 java.base 和 java.sql 里。看它们怎么把读和写分开,比看模式定义有用。
DriverManager:注册表用写时复制
JDK 25 的 java.sql/java/sql/DriverManager.java:85:
1 | private static final CopyOnWriteArrayList<DriverInfo> registeredDrivers = new CopyOnWriteArrayList<>(); |
getDriver 和 getConnection 都直接遍历它,没有加锁:
1 | // :246-248 getDriver 里 |
写路径在 registerDriver 里,:312:
1 | registeredDrivers.addIfAbsent(new DriverInfo(driver, da)); |
每次注册复制整个数组。注册发生在启动阶段,分发发生在每次取连接时,取舍对得上两者的频率差。
getConnection 找驱动时不建索引,挨个问每个已注册的驱动,第一个返回非空连接的胜出(:607-618):
1 | for (DriverInfo aDriver : registeredDrivers) { |
注册表在这里不承担路由,只承担遍历。驱动数量通常个位数,线性扫描比维护一张「URL 模式到驱动」的索引便宜,也不用处理模式冲突。这和第六节量到的是一回事:查表只有在表大到值得索引、且目标分散的时候才需要优化,JDBC 驱动这张表一直没到那个规模。
getConnection 的第二个细节是 ensureDriversInitialized()(:601)每次调用都会执行一次。它第一句读的是 volatile 布尔量(:516-518,if (driversInitialized) { return; }),热路径上没有锁,只有第一次会走到 synchronized:
1 | // :515-523 |
lockForInitDrivers 是 :92 的一个普通对象。这正是中介者该有的形状:注册表在运行期几乎不变,读路径不带锁,复制的代价留给罕见的写。
ServiceLoader:缓存挂在实例上
java.base/java/util/ServiceLoader.java 有两个缓存列表,都是实例字段:
1 | // :396 iterator 走的缓存 |
迭代器的 next()(:1250-1259)第一次走查找器,之后直接从缓存下标取:
1 | public S next() { |
缓存挂在实例上,这个中介者就没有跨实例的共享状态,两个线程各自 ServiceLoader.load() 拿到的两套缓存互不影响。代价是同一个服务每次加载都会把实现类重新找一遍、实例化一遍,缓存不共享。
ThreadPoolExecutor:只有增删 worker 才加锁
提交路径是 java.base/java/util/concurrent/ThreadPoolExecutor.java 的 execute(:1292),它第一句读的是 ctl(:382 的 AtomicInteger):
1 | // :1314-1319 |
worker 集合的增删走一把 ReentrantLock,注释写明了这一点:
1 | // :466-470 |
:464 是 private final ReentrantLock mainLock = new ReentrantLock();。mainLock 只在增删 worker、统计峰值、中断空闲线程这些动作上持有。常规提交走的是 ctl 的 CAS 加队列的 offer,不碰它。
三个中介者的共同点
| 中介者 | 中介了什么 | 读路径 | 写路径 | 共享的是 |
|---|---|---|---|---|
DriverManager |
JDBC 驱动注册表 | 无锁遍历 CopyOnWriteArrayList |
复制整个数组 | 一个数组引用 |
ServiceLoader |
服务接口与实现类 | 读实例字段 ArrayList |
追加 | 无跨实例共享 |
ThreadPoolExecutor |
任务与工作线程 | ctl 的 CAS 加队列无锁 offer |
mainLock 保护 workers |
一个 AtomicInteger 加一把只在增删时用的锁 |
三个都遵守同一条规则:**读路径不加锁,写路径才加锁或复制。**第四节里那两个掉到 7.8 百万次每秒和 19.3 百万次每秒的版本,违反的正是这一条,它们让每一次读都去改共享状态。
它们还有一个共同点:注册表都不大。JDBC 驱动个位数,ServiceLoader 的服务实现通常几十个,线程池的 worker 最多几百个。第六节的结论在这里成立:表小、目标集中,线性扫描和 HashMap 都够用,谁也没有为查表做特殊处理。三个中介者的力气都花在写路径上,因为它们的注册表在启动之后就基本不变。
八、结论
什么时候用中介者
两个条件同时成立:
- 谁该收到消息在运行期才定得下来,或者会变。参与者数量固定、调用关系写死在代码里的,直接持有引用更省事。
- 这个决定逻辑要是散在各处会互相矛盾。8 个参与者各自维护一份路由表,改一次规则要改 8 个地方,这是中介者的正经理由。
什么时候不用
- 调用关系是固定的。 依赖注入、传一个函数、直接持有引用都能解耦,而且不用给中介者一次查表。
- 中介者要在每个事件上改共享状态。 第四节里 synchronized 版本 8 线程下的吞吐是它自己单线程的 1/28,是同一行每线程独立槽版本的 1/121。换成
AtomicLong也只是从 7.8 涨到 19.3 百万次每秒,因为 CAS 争的还是同一条 cache line。这是结构问题,调优解决不了。 - 参与者只有几个,只是想让 API 好看一点。 第三节里多一层转发测不出来,但登记表在 N 小于几十的时候比直连多占内存。事件总线、消息队列、发布订阅这些现成的东西也提供了「发送方不认识接收方」的性质。
单点意味着延迟加在所有人身上
中介者是所有分发的必经之路。第四节 8 线程里,每个线程调用的中介者是同一个对象:中介者 synchronized 版本每次分发 1,022.8 ns,直连 5.75 ns。差的这 178 倍摊在每个参与者身上。
这是「单点」的具体含义,指延迟和吞吐上的单点,不是可用性上的单点故障(那一面没法用微基准量):中介者的每一次加锁、每一次复制、每一次缓存未命中,都要乘以分发次数。
中介者还拿走了调用栈
直连时,一个事件从 A 到 C 的路径在代码里写得出来:A 的方法里有一行 peers[t].onEvent(...),断点打上去就是。中介者时代码里只看得到 send(msg),收件人要等运行期查表才知道。排查「这个事件为什么没送到」的问题,从读代码变成读日志。
这一条没法用微基准量。但它和第四节的数是同一件事:中介者把决定权集中到了一处,也就把「谁收到什么」这个事实从代码挪进了运行期的状态。状态可以改,代码不会。第四节里那些把状态按线程拆开的版本之所以快,正是因为它们把「谁收到」重新变成了一个不用共享的东西。
中介者的热点怎么消
按代价从低到高:
- **不留状态。**只做转发的中介者测不出开销,第三节前两行就是这个情况。
- **状态能按线程拆就拆开。**第四节的每线程独立槽把共享状态换成每线程一份,8 线程吞吐 949.7 百万次每秒,和直连的 1,391.8 是一个量级。
- **状态只能有一份,就把更新频率降下来。**JDK 的做法是写时复制(
DriverManager)、CAS(ThreadPoolExecutor的ctl)、或者把锁缩到只保护增删。 - **都做不到,就按事件频率算总账。**锁版本 8 线程下每次分发要等 1,022.8 ns,聚合吞吐 7.8 百万次每秒。够用就够用,不够用就得改结构。
一条判断顺序
    graph TD
    Q0["参与者之间要不要互相认识"] -->|"调用关系固定,只是不想互相 import"| A0["不需要中介者:持有引用或传函数"]
    Q0 -->|"运行期才知道谁该收到"| Q1["每次分发要不要改中介者的共享状态"]
    Q1 -->|"不用,注册后只读"| A1["中介者 + 不可变快照<br/>读路径无锁"]
    Q1 -->|"要:全局序号、轮转游标、限流计数"| Q2["这个状态能不能按线程拆开"]
    Q2 -->|"能"| A2["每线程一份<br/>吞吐随核数涨"]
    Q2 -->|"不能,只能有一份"| Q3["收件人是固定几个还是散布全表"]
    Q3 -->|"固定几个"| A3["按名字查表可以接受<br/>热条目约 2 ns"]
    Q3 -->|"散布全表"| A4["换成数组或整数 id<br/>按名字查表 53 ns"]
走一遍判断顺序
一个聊天服务:房间里的用户互相发消息,中介者是那个房间管理器。
第一个问题,用户之间要不要互相认识。不要,而且接收方在运行期才确定(谁在这个房间、谁在线、谁被拉黑),问题一过关。
第二个问题,每次分发要不要改中介者的共享状态。「按房间查成员列表」是只读的,成员列表只在有人进出房间时变。用写时复制的快照,分发路径上就没有同步原语,落在第四节那张表的第一列和第四列之间。
第三个问题不用问,状态不可变,没有东西要拆。需要共享的是「谁在哪个房间」这张表,它的更新频率是成员进出,不是每条消息,属于第三节里「写路径罕见」的形状。
第四个问题,收件人集中还是分散。一条消息发给同一个房间的成员,收件人列表是热的,按名字查表大约 2 ns。
这个中介者的分发路径可以做到 2 ns 上下,成本几乎全在扇出和实际投递上。给每条消息加一个全局序号做去重,就会掉进第四节那个洞:8 个线程抢一个计数器,每次分发 400 ns 起步。
总结
- 中介者省掉的是参与者之间的引用:N = 2048 时从 4,192,256 条降到 4,096 条,堆占用从 16.2 MiB 降到 176 KiB。代价是集中了一个决定点。参与者不到几十个的时候,中介者反而更占内存。
- 只做转发的中介者测不出额外开销。JDK 25 上点对点直连 2.13 ns、中介者按位次 1.94 ns;广播 3.85 ns 对 3.21 ns。
-XX:+PrintInlining显示 JIT 把dispatch和onEvent都内联了,两个版本编译成同一段代码。 - 按名字查注册表每次 1.6 ns,是单次投递成本(0.29 ns)的 5 倍多。广播一个事件查 7 次表,事件耗时从 3.21 ns 涨到 14.52 ns。
- 中介者只要在每个事件上碰一次共享状态,零竞争下就要 4.54 ns(
synchronized)或 7.03 ns(AtomicLong),直连是 0.35 ns。 - 8 线程共用一个中介者:直连 1,391.8 百万次/秒,每线程独立槽 949.7,
AtomicLong19.3,synchronized7.8。最后一个比自己单线程时慢 28 倍。 - 锁的成本主要落在 cache line 上。8 线程 150 ms 窗口里,5,559,808 次分发只触发了 7,338 次监视器慢路径(0.13%),而同一次运行里每次分发要 222 ns。搬 cache line 比挂线程贵。
- 查表的成本由目标的分散程度决定:注册表从 8 条涨到 100 万条,目标固定 7 个时一直是 2.2 ns;目标散布全表时从 2.0 ns 涨到 53 ns。
- JDK 的三个中介者都让读路径无锁,只在写路径加锁或复制。
DriverManager用CopyOnWriteArrayList(JDK 25DriverManager.java:85),初始化才用lockForInitDrivers(:92、:515-523);ThreadPoolExecutor的mainLock(:464)只保护workers(:470),提交走ctl的 CAS。 - 同一段
synchronized代码,8 线程下 JDK 21 是 17.0 百万次/秒,JDK 25 是 7.8,差一倍多。锁版本的容量规划不能跨 JDK 版本外推。 - 判断顺序:先问调用关系固不固定,再问每次分发要不要改共享状态,再问状态能不能按线程拆,最后问收件人是固定几个还是散布全表。四问都在第三节到第六节里有对应的数字。
参考资料
- DriverManager (Java SE 25)
- DriverManager (Java SE 21)
- ServiceLoader (Java SE 25)
- ThreadPoolExecutor (Java SE 25)
- AbstractExecutorService (Java SE 25)
- CopyOnWriteArrayList (Java SE 25)
- Mediator Pattern
- Java Concurrency in Practice
系列索引:设计模式系列